Hot 100 --- 分割等和子集
本文概览:本文讲解分割等和子集的核心思路:能否分割等价于能否选出和为 sum/2 的子集,转化成 0/1 背包,dp[i] 表示能否凑出 i,内层必须从 target 往下遍历防重复选取
一、题目
二、题目分析
1. 题目要求
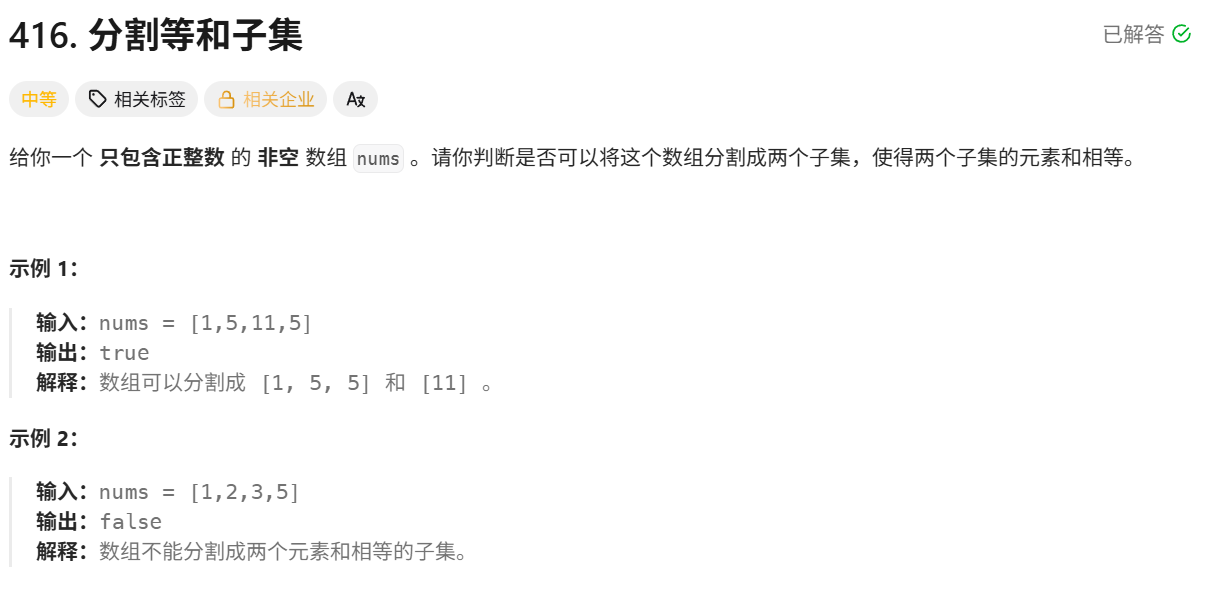
给你一个只包含正整数的非空数组 nums,判断是否可以将这个数组分割成两个子集,使得两个子集的元素和相等。
示例 1:nums = [1, 5, 11, 5] → true([1, 5, 5] 和 [11],和都是 11)
示例 2:nums = [1, 2, 3, 5] → false(总和 11 是奇数,怎么分都不相等)
2. 问题转化:能不能变成更小的问题?
先想清楚"分割成两个和相等的子集"意味着什么。
设数组总和为 sum,分成的两个子集和相等,那每个子集的和就是 sum / 2。反过来,如果能从数组里选出部分元素,让它们的和恰好等于 sum / 2,剩下的元素自然也凑出另一个 sum / 2——分割成功。
所以原问题等价于一个更小的问题:
能否从数组中选取部分元素,使它们的和等于 sum / 2?
这个转化还带来一个快速剪枝:sum 是奇数时直接返回 false(两个整数子集的和不可能等于一个半整数)。
顺手算一下示例 1:sum = 22,target = 11。问题变成:从 [1, 5, 11, 5] 里选元素,能否凑出 11?选 11 一个就够,或选 1+5+5——能,返回 true。
3. 怎么判断这是动态规划问题?
暴力枚举行不行? 每个元素"选"或"不选",n 个元素 2ⁿ 种组合,枚举所有组合看有没有和为 target 的——指数级,不现实。
从后往前想:假设 target 已经凑齐了,最后一个选入的元素是 num。那剩下的元素必须能凑出 target - num——大问题由小问题组合出来,且"凑出某个值的可行性"与选了哪些具体元素无关(无后效性)。标准的 DP 结构。
4. 需要解决哪几个问题?
问题一:状态怎么定义?——"能否凑出 i"怎么用数组记录?
问题二:转移方程怎么写?——已知前面的记录,怎么推出"能否凑出 i"?
问题三:遍历顺序有什么讲究?——内层正着还是倒着?外层是元素还是目标值?
三、思路概览
1 | public boolean canPartition(int[] nums) { |
思路简要说明:
- 问题转化:能否分割 ⟺ 能否选出和为 target = sum/2 的子集
- 状态定义:
dp[i]表示能否用已遍历的元素凑出 i - 转移方程:
dp[i] = dp[i] || dp[i - num](不选 num 维持原值,选 num 看 dp[i-num]) - 初始条件:
dp[0] = true(什么都不选,凑出 0) - 答案:
dp[target] - **时间复杂度 O(n × target)**,空间 O(target)
四、思路详解
第一步:解决状态定义——为什么 dp 是 boolean 数组?
转化后的问题是"能否凑出 target",答案只有 true/false,不是数值。所以 dp 数组用 boolean:
dp[i] = 用已遍历过的元素,能否凑出和为 i。
注意"已遍历过的元素"这个限定——dp 的含义随着外层循环推进而逐步扩大:处理第 1 个元素时,dp 只反映"用第 1 个元素能凑出什么";处理完第 3 个元素时,dp 反映"用前 3 个元素能凑出什么"。
**初始条件 dp[0] = true**:一个元素都不选,和为 0,天然成立。它是一切的起点——凑出任何非零值的第一步,都是从"凑出 0"开始加一个元素。
第二步:解决转移方程——选或不选 num
假设正在处理元素 num,要更新 dp[i](能否凑出 i)。凑出 i 的方案分两类:
- 不选 num:沿用旧状态,能不能凑出 i 看之前的结果
dp[i](旧值) - 选 num:先凑出
i - num(用之前的元素),再补上一个 num——前提是旧状态里dp[i - num]为 true
两类有一条通就行,"或"起来:
1 | dp[i] = dp[i](旧值,不选 num) || dp[i - num](旧值,选 num) |
这和打家劫舍的"偷或不偷"是同一个分析手法:站在目标状态往回看,最后一个决策是什么。区别在于打家劫舍两个候选取 max(求最优值),这里两个候选取"或"(判可行性)。
第三步:内层为什么必须从 target 往下遍历?
这是本题最重要的编码细节,先看正确写法:
1 | for (int i = target; i >= num; i--) { // 从大到小 |
关键在于 dp[i - num] 必须是"没用过 num 的旧值"。
假设反过来,从小到大遍历(i 从 num 到 target):
1 | 处理 num = 1,target = 4: |
一个 1 被用了 4 次——dp[4] 竟然变成 true,意味着"用一个元素 1 凑出了 4",错。
从大到小就没这个问题:
1 | i=4: dp[4] = dp[4] || dp[3] ← dp[3] 还是旧值(本轮还没碰到) |
先更新大下标,读的 dp[i - num](更小的下标)都还没被本轮碰过,全是"没用过 num"的旧值——每个元素最多被选一次。
这和乘积最大子数组方法一"从后往前更新 dp"是同一个原理:新值依赖旧值,倒着遍历让读的永远是还没被覆盖的旧值。
第四步:外层为什么必须是元素、内层是容量?
1 | for (int num : nums) { // 外层:逐个元素 |
反过来会怎样? 外层容量、内层元素:
1 | for (int i = 1; i <= target; i++) { |
问题一:每个容量 i 会把所有元素试一遍,同一个元素在不同容量处被反复"选用"——元素失去"只用一次"的约束(组合变排列,还可能重复用)。
问题二:dp 的语义坏了。正确语义是"处理完第 k 个元素后,dp 反映前 k 个元素的凑和能力",每轮内层只更新一个元素的贡献。反过来后,dp 在半路上就混入了后面元素的信息,推导链断了。
这就是 0/1 背包的标准写法:外层物品、内层容量(倒序)。"0/1"指每个物品只有一个,选或不选;与之相对的完全背包(物品无限个,比如前面的零钱兑换)内层正序遍历,正序恰恰是"允许重复选"的写法——零钱兑换每枚硬币可无限用,正序更新让它在本轮就被自己更新,等于多用一次。
第五步:完整执行过程
以 nums = [1, 5, 11, 5] 为例,sum = 22,target = 11。
处理 num=1(i 从 11 到 1):
1 | 只有 dp[1] 通过 dp[0] 变 true |
处理 num=5(i 从 11 到 5):
1 | i=6: dp[6] = dp[1] = true ← 1+5 |
处理 num=11(i 从 11 到 11):
1 | i=11: dp[11] = dp[0] = true ← 11 |
处理 num=5(i 从 11 到 5):
1 | i=11: dp[11] 已是 true(11 或 1+5+5 都行) |
返回 dp[11] = true ✓(对应选 11,或选 1+5+5,剩下一半自动凑齐)
再走一个 false 的例子:nums = [1, 2, 3, 5],sum = 11,奇数,直接返回 false ✓(连 dp 都不用建)。
第六步:代码细节
奇数提前返回:sum % 2 != 0 时 target 不是整数,两个整数子集的和不可能相等,直接 false。这也是最快的一道剪枝——不用进循环。
**内层边界 i >= num**:容量 i 必须至少为 num 才装得下这个元素;i < num 时 i - num 是负数下标,越界。
dp[i] = dp[i] || dp[i - num] 的读值:dp[i] 已是 true 时保持 true(凑出过一次就一直成立)。真正的重点是读的 dp[i - num] 必须是旧值,这由倒序遍历保证。
为什么 dp 数组开 target + 1 而不是 sum + 1:我们只关心"能否凑出 target",凑出比 target 大的值没有意义(剩下的元素和必然小于 target,凑不齐另一半)。按 target 截断,空间省一半。
复杂度分析
**时间复杂度 O(n × target)**:外层 n 个元素,内层最多 target 次更新。
**空间复杂度 O(target)**:一维 boolean 数组。
对比暴力枚举的 2ⁿ:dp 把"每个子集能不能凑出"压缩成"每个数值能不能凑出",子集有 2ⁿ 个,数值只有 target + 1 个。
五、总结
分割等和子集的核心思路:
- 问题转化:能否分割成两个和相等的子集 ⟺ 能否选出和为 sum/2 的子集;sum 为奇数直接 false
- 状态定义:
dp[i]= 用已遍历的元素能否凑出 i,boolean 型 - 转移方程:
dp[i] = dp[i] || dp[i - num],不选 num 或选 num,"或"起来 - 内层倒序(从 target 到 num):保证读到的
dp[i - num]是没用过 num 的旧值——每个元素只用一次 - 外层元素、内层容量:0/1 背包的标准写法;反过来会破坏"每个元素一次"的约束和 dp 的语义
0/1 背包与完全背包的对照(结合前面的零钱兑换):
| 维度 | 0/1 背包(本题) | 完全背包(零钱兑换) |
|---|---|---|
| 物品数量 | 每个一个,选或不选 | 每个无限个 |
| 内层方向 | 倒序(防重复选) | 正序(允许重复选) |
| 典型问题 | 分割等和子集、目标和 | 零钱兑换、完全平方数 |
| 转移 | dp[i] = dp[i] || dp[i-num](可行性) |
dp[i] = min(dp[i], dp[i-coin]+1)(最少件数) |
方向记法:内层倒序 = "一次性"(每个物品最多选一次,读了旧值就不许自己更新自己);内层正序 = "可重复"(本轮更新过的值马上被下一轮读到,物品等于多用了一次)。
和前面 DP 的关系:转移的分析手法依然是"站在目标状态往回看最后一步"——这里最后一步是"选不选 num"。从打家劫舍的 max(最优值)、单词拆分的逻辑与(可行性)、到本题的"或"(可行性),DP 的转移形式在变,但推导的出发点从没变过。