无标题
先看一段再普通不过的代码。
1 | public class Counter { |
两个线程各自调用一次 increment(),期望结果是 3,实际可能得到 2。
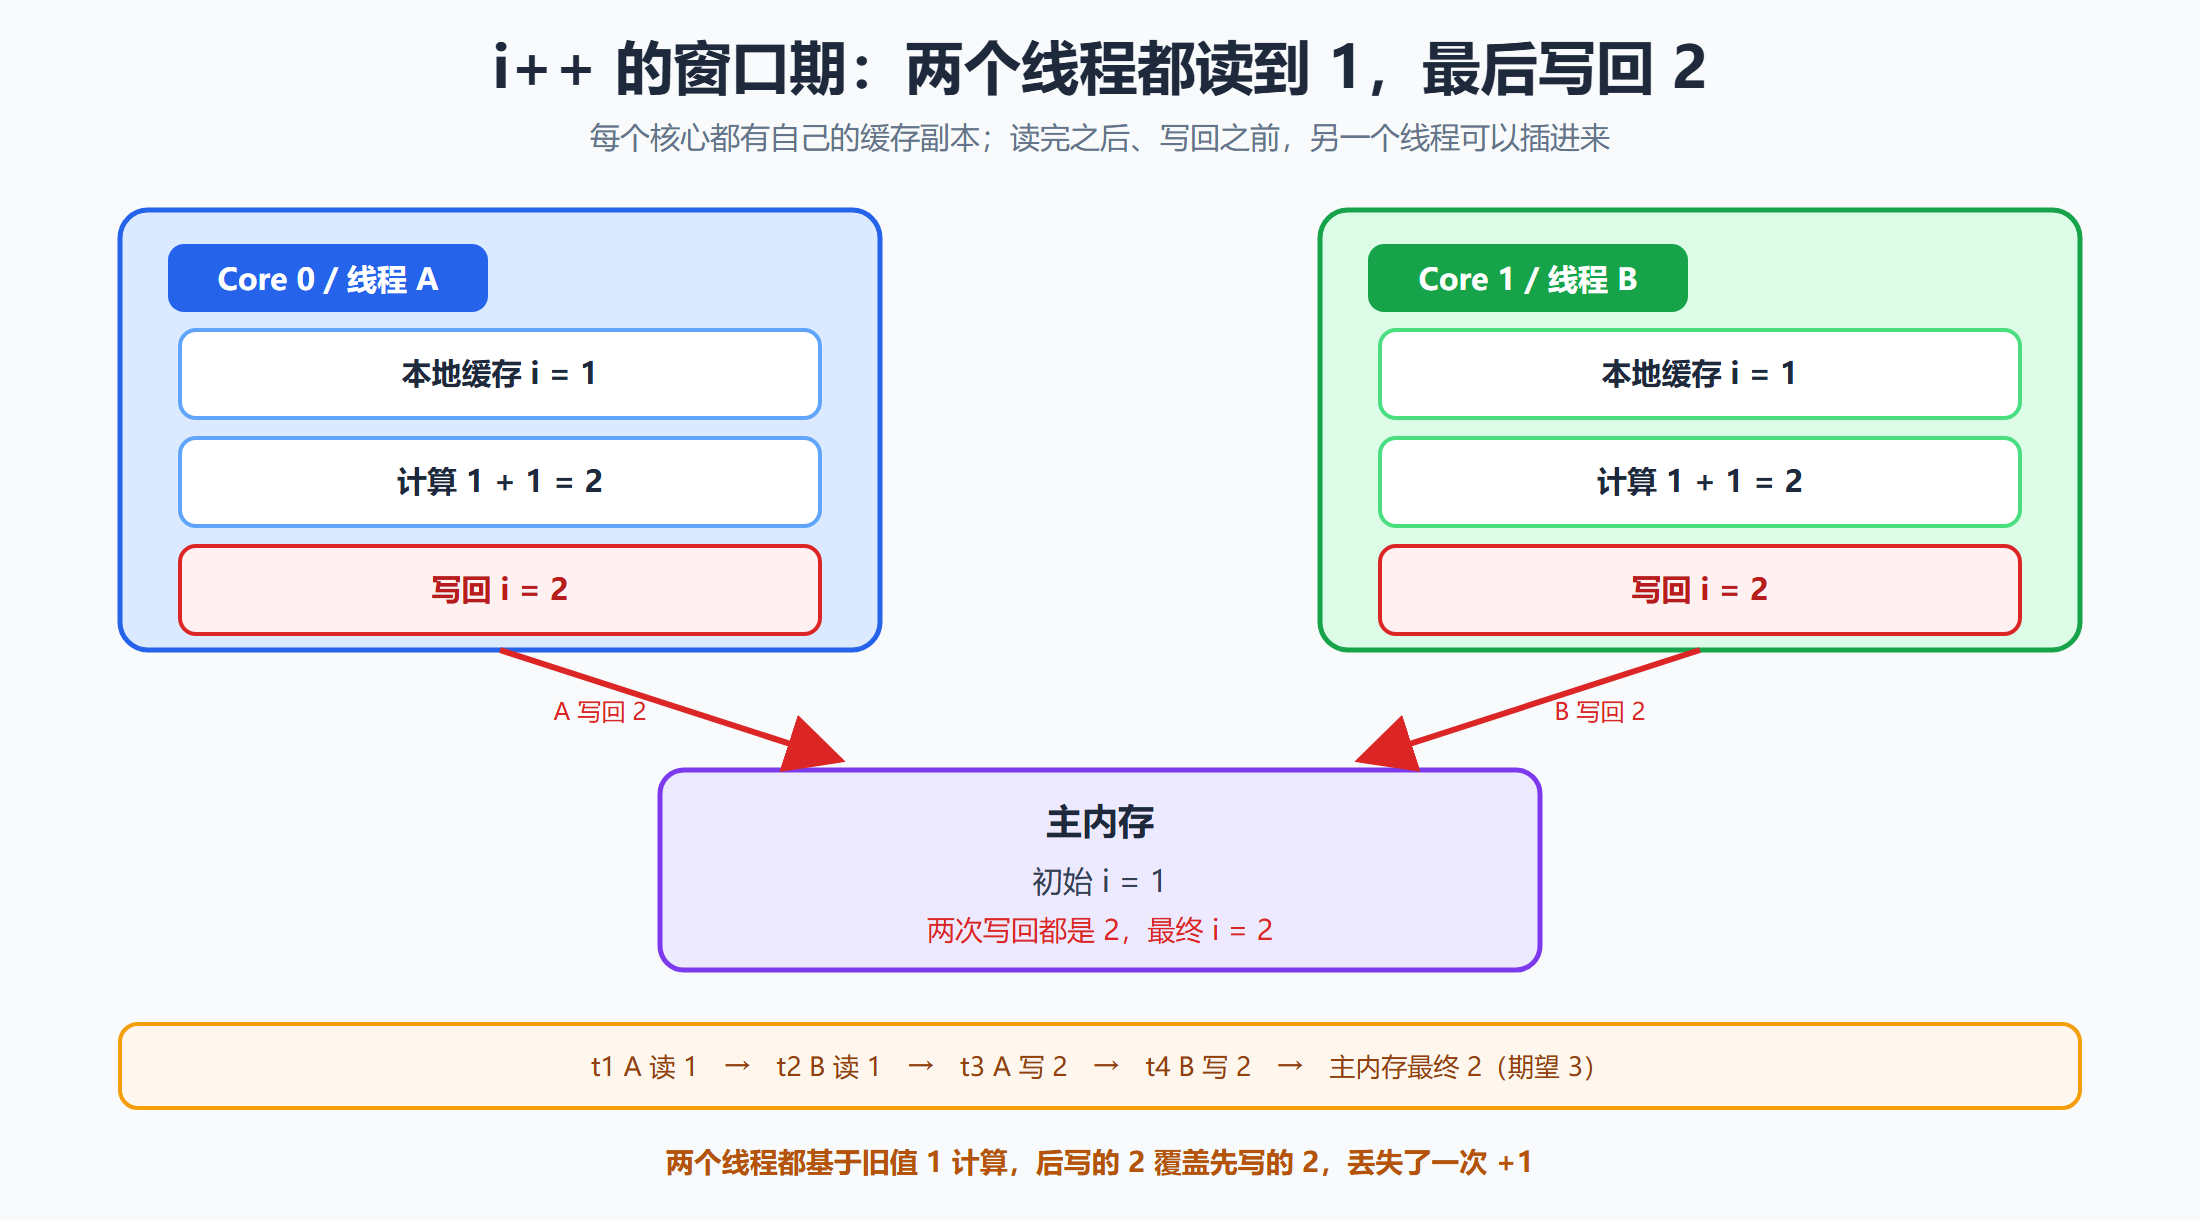
问题不在语法,也不在 API 用法,而在于 count++ 本身不是原子操作。本文按两条实现路线展开:
- 第一条:悲观锁,代表是
synchronized; - 第二条:乐观锁,代表是 CAS 与版本号。
显式锁、AQS 属于同一层的另一条实现路线,本文只在必要处提名字,不展开。
一、问题的本质:i++ 为什么不是原子操作
1.1 一条自增,三条指令
count++ 在字节码层面大致对应三条动作,按执行顺序编号:
- 读取:把
count的当前值取到操作数栈上。 - 计算:把取到的值加一。
- 写回:把计算结果写回
count所在的内存位置。
所以,count++ 实际上是“读—算—写”三步,而不是一条不可分割的指令。
三步之间没有任何保护,两个线程完全可以交替执行:
| 时刻 | 线程 A | 线程 B | count 的逻辑值 |
|---|---|---|---|
| t1 | 读取 count = 1 | — | 1 |
| t2 | — | 读取 count = 1 | 1 |
| t3 | 计算 1 + 1 = 2 | — | 1 |
| t4 | — | 计算 1 + 1 = 2 | 1 |
| t5 | 写回 2 | — | 2 |
| t6 | — | 写回 2 | 2 |
两个线程都基于旧值 1 计算,后写的 2 覆盖了先写的 2,一次自增凭空消失。这类问题有一个专门的名称:丢失更新。
1.2 三个术语
- 竞态条件:最终结果取决于线程执行的先后顺序。上面的 t1 到 t6,只要顺序变一下,结果就可能不同。
- 临界区:访问共享状态的那段代码。本例中,
count++就是临界区。 - 原子性:一个操作要么全部完成,要么完全不发生,中间状态不会被其他线程看到。
count++ 不具备原子性,所以它不能作为一个整体被并发执行。
1.3 可见性为什么不够
一个常见的疑问是:既然线程可能读到旧值,那给 count 加上 volatile,强制每次都从主内存读,是不是就好了?
答案是否定的。这里要把两条线分开。
可见性回答的是“一个线程的写,另一个线程什么时候能看到”。JMM 下每个线程有自己的工作内存,普通变量的读写可能发生在本地副本上,所以确实存在读到旧值的情况。volatile 的写会刷回主内存,volatile 的读会从主内存取最新值,这部分它能保证。
但原子性回答的是“三步之间会不会被插进来”。即使每次读到的都是最新值,交错仍然可以发生:
| 步骤 | 线程 A | 线程 B | count 的值 |
|---|---|---|---|
| 1 | 读 1 | — | 1 |
| 2 | — | 读 1 | 1 |
| 3 | 写 2 | — | 2 |
| 4 | — | 写 2 | 2 |
每一步读到的都是“最新值”,结果依然错。原因不在可见性,而在“读”和“写”之间存在窗口。
同理,Unsafe 提供的 loadFence、storeFence 这类内存屏障,约束的是指令重排序和可见性顺序,它们是 JMM 层面的排序原语,不是把三步合成一步的工具。屏障不能替代原子操作。
真正需要的是:让“读—算—写”整体不被打断。synchronized 之所以能解决,是因为它同时提供了两件事——互斥(同一时刻只有一个线程进入临界区)和可见性(解锁前的写对后续加锁的线程可见,即 happens-before)。
1.4 两条路线
要保住原子性,只有两种思路。
思路一:互斥。 在窗口期内只允许一个线程操作,其他线程在门外等。相当于把并发改成串行。
思路二:冲突检测。 不加锁,先读—算,提交时检查“这段时间里有没有别人改过”。没改就写入,改了就放弃或重来。
这里有一个容易被忽略的前提:检查与写入必须作为一个整体完成。如果先检查、再写入,两步之间又会出现新的窗口,问题原封不动地回来了。这个“比较并写入”的原子性只能由底层指令保证,Java 代码无法自己把两步合成一步;CAS 就是对这类指令的封装。
二、两条解决路线:悲观锁与乐观锁
上一节的两条思路,落到工程上就是两种策略。
2.1 悲观锁:先独占,再操作
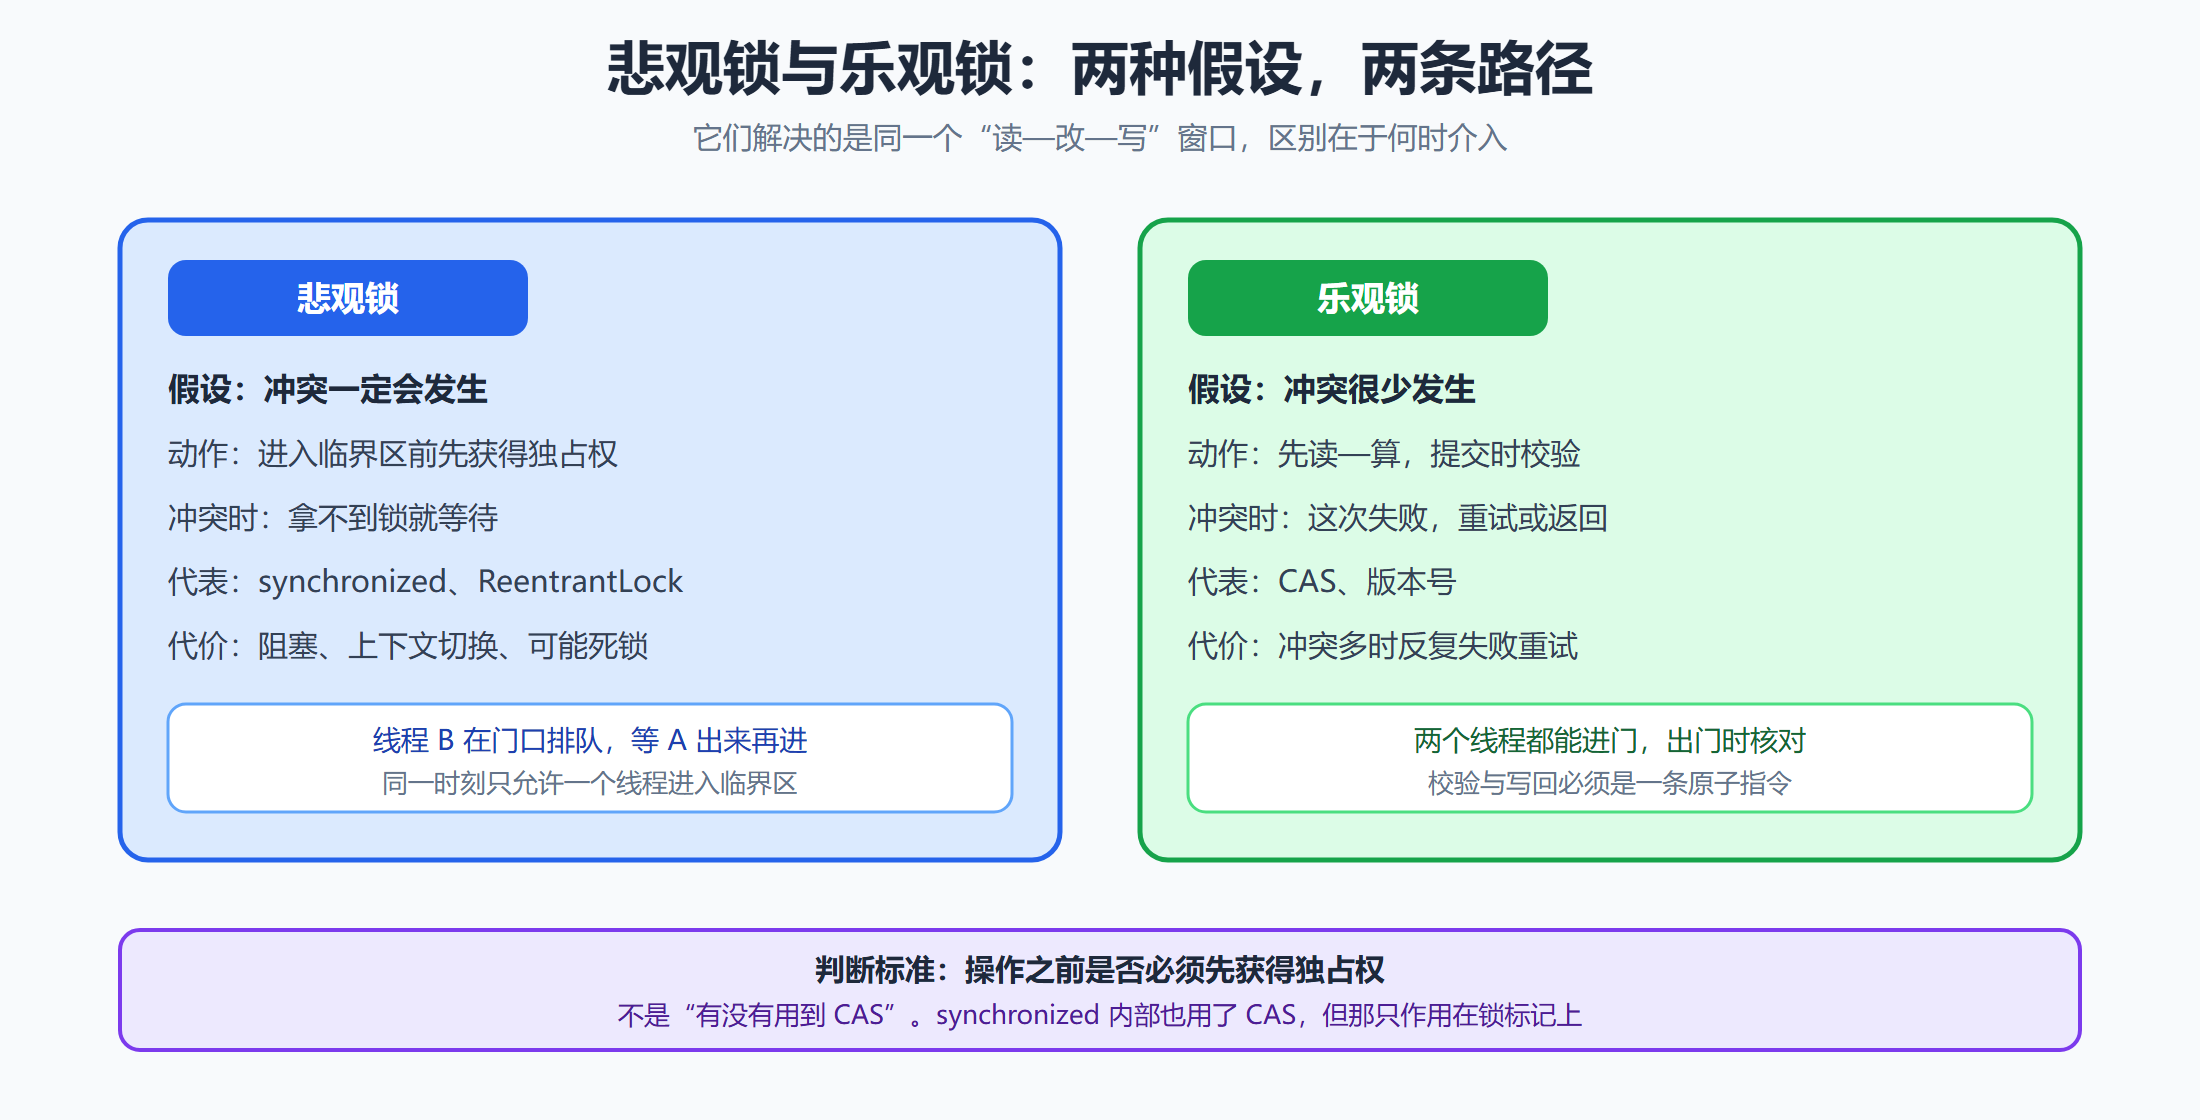
路线一(对应 1.4 的思路一:互斥):悲观锁。 把“进入临界区之前必须先拿到独占权”固定成规则,就是悲观锁。
悲观锁假设冲突一定会发生,认为共享资源每次被访问时都可能出问题,所以在操作之前先上锁。其他线程想拿这个资源,只能阻塞,直到锁被上一个持有者释放。也就是说,共享资源每次只给一个线程使用。
1 | public void performSynchronisedTask() { |
Java 中 synchronized 和 ReentrantLock 都是这种思想的实现。数据库里的 SELECT ... FOR UPDATE 也是同一套逻辑,只不过锁由数据库管理。
代价也很清楚:高并发下激烈的锁竞争会造成线程阻塞,大量阻塞线程带来上下文切换;如果获取锁的顺序不当,还可能死锁。
需要说明的是,“悲观”描述的是假设,不是性能评价。低竞争时,synchronized 内部有针对无竞争和轻竞争场景的优化,开销并不比乐观锁高;具体机制在第四章展开。
2.2 乐观锁:先操作,再校验
路线二(对应 1.4 的思路二:冲突检测):乐观锁。 把“先读—算,提交时校验”固定成规则,就是乐观锁。
乐观锁假设冲突很少发生,认为共享资源每次被访问时不会出问题,所以线程可以不停地执行,不加锁也不等待,只在提交修改时验证数据有没有被别人改过。
验证方式有两种:
- CAS:把一个预期值和当前值比较,相等才写入。
- 版本号机制:给数据加一个
version字段,读取时一起读,提交时比较版本号。
代价同样清楚:如果冲突频繁,大量线程会反复失败重试,CPU 被白白消耗。乐观锁的收益建立在“冲突少”这个前提上,前提不成立时,它的性能并不占优,甚至可能因为反复重试而更差。
2.3 判断标准
两种策略的分界线,不是看有没有做“比较”,而是看:操作之前是否必须先获得独占权。
| 对比项 | 悲观锁 | 乐观锁 |
|---|---|---|
| 假设 | 冲突一定会发生 | 冲突很少发生 |
| 加锁时机 | 操作之前 | 不加锁,提交时校验 |
| 冲突时 | 阻塞等待 | 失败重试或直接返回 |
| 代表实现 | synchronized、ReentrantLock |
CAS、版本号 |
标准定下来之后,两条路各自的代价和适用场景也就清楚了。
2.4 适用场景与代价
理论上:
- 悲观锁适合写多、冲突激烈的场景,避免大量失败重试。
- 乐观锁适合读多写少、冲突较少的场景,避免加锁的开销。
举个极端一点的例子。假设每秒有 1000 个线程要执行同一段临界区操作:
- 悲观锁把它们排成一队,一次只放一个进去,其余等待。
- 乐观锁让 1000 个线程同时冲,冲突越多,失败和重试越多。
两条路的代价在这里分岔:悲观锁用等待换稳定,乐观锁用重试换吞吐。冲突越多,乐观锁浪费在重试上的 CPU 越多;冲突越少,悲观锁的等待越显得多余。
至于具体的成功率,它和临界区长度、线程数、CPU 核数、重试策略都有关,不存在一个通用数字。要判断自己的场景适合哪条路,只能固定这些条件做压测。
还有一个例外值得一提:LongAdder 在竞争激烈时把更新分散到多个内部单元,降低所有线程争用同一个值的概率。它内部仍然有 CAS 和重试,只是把“一个热点”拆成了“多个热点”。这一点在 3.7 节展开。
三、乐观锁路线:CAS、ABA 与原子类
乐观锁在 Java 内存中的实现,核心是 CAS;版本号则是它在数据库场景中的对应做法。这一章先讲 CAS 本身,再看它的缺陷 ABA,然后看版本号如何补上“变化历史”,最后落到 Java 的原子类。
3.1 CAS 的原理
CAS 全称 Compare And Swap,涉及三个操作数:
- V:要更新的变量当前值
- E:预期值
- N:拟写入的新值
当且仅当 V 等于 E 时,才用 N 更新 V;否则说明已经被别人改过,本次放弃。
举个例子:变量 i 原值为 1,线程 A 想把它改成 6。
- 读取
i,得到 V = 1。 - 把预期值设为 E = 1,新值设为 N = 6。
- 执行 CAS:如果此刻
i仍然等于 1,就写入 6;否则失败。
失败时线程不会被挂起,只是被告知“这次没成”,是否重试由调用方决定。这也是 CAS 与锁最本质的区别:它不阻塞。
但前提仍然成立:比较和写入必须是一条原子指令。CPU 层面通常对应 lock cmpxchg 这类指令,lock 前缀保证操作在缓存/总线层面不可分割。Java 代码无法自己拼出这个语义,只能借助 Unsafe 或 VarHandle 调用。
3.2 CAS 的缺陷:ABA
CAS 只比较“当前值是否等于预期值”,它无法知道这个值在中途是否变过。
设想下面的时序:
| 时刻 | 线程 A | 线程 B | 值 |
|---|---|---|---|
| t1 | 读到 A | — | A |
| t2 | — | 把 A 改成 B | B |
| t3 | — | 又把 B 改回 A | A |
| t4 | CAS(A → C) 成功 | — | C |
线程 A 看到当前值仍是 A,就认为“没人动过”。实际上,值已经被修改了两次,只是绕回了原点。这个问题叫 ABA。
它是否带来问题,取决于业务是否关心中间过程。
只关心最终值时,ABA 通常无害。 看一个多线程扣库存的场景:库存为 10,线程 A 和线程 B 都要下单。
| 时刻 | 线程 A | 线程 B | 库存 |
|---|---|---|---|
| t1 | 读到 10,准备 CAS(10→9) | — | 10 |
| t2 | — | CAS(10→9) 成功 | 9 |
| t3 | — | 订单创建失败,系统回滚 9→10 | 10 |
| t4 | CAS(10→9) 成功,A 的下单成功 | — | 9 |
A 的 CAS 成功时,B 已经扣过又退回。但 A 只要求“当前库存是 10 时减一”,它不关心 B 是否来过。最终库存 9:A 买走一件,B 没有成交,结果符合预期。这里的 ABA 无害。
关心中间是否发生过变化时,ABA 会出错。 看一个支付回调的幂等标记:0 表示未处理,1 表示处理中。
| 时刻 | 线程 A | 线程 B | 标记 |
|---|---|---|---|
| t1 | 读到 0,准备 CAS(0→1) | — | 0 |
| t2 | — | CAS(0→1) 成功,开始处理,并成功发放积分 | 1 |
| t3 | — | 后续步骤异常,标记回滚 1→0 | 0 |
| t4 | CAS(0→1) 成功,再次处理,又发一次积分 | — | 1 |
线程 A 看到标记回到 0,就认为“没人处理过”。但线程 B 已经处理过一次,积分也已经发出;标记回滚了,副作用却没有回滚。A 再次处理,用户就拿到两份积分。这个时间窗口可以很短,不需要任何线程“停很久”,线程被短暂调度出去就足够发生。
问题的根源不是“值变了”,而是“值变过又变回来了,而 CAS 看不见这段历史”。
解决方向是给值附加一个单调递增的“变化次数”。这样即使值绕回原点,次数也不会回到原点。
3.3 版本号机制:补上变化历史
版本号机制的做法,是在数据表里加一个 version 字段,每次修改成功就加一。读取时把版本号一起读出来,提交时比较。
假设账户表里有一条记录:id = 1,余额 100,版本号 1。
| 步骤 | 操作员 A | 操作员 B | 数据库中的 (balance, version) |
|---|---|---|---|
| 1 | 读出 (100, 1) | — | (100, 1) |
| 2 | — | 读出 (100, 1) | (100, 1) |
| 3 | 计算 100 - 50 = 50,提交更新 | — | (50, 2),更新成功 |
| 4 | — | 计算 100 - 20 = 80,提交更新 | 影响 0 行,更新失败 |
对应的 SQL 是:
1 | UPDATE account |
这条语句返回的影响行数就是结果:
- 返回 1:版本号匹配,更新成功。
- 返回 0:版本号已经变了,说明期间有人改过,本次失败,由业务决定重试还是返回。
关键点在于:检查和更新写在同一条 SQL 里,由数据库的行锁保证这条语句的原子性。如果拆成“先 SELECT 校验、再 UPDATE”,两步之间又会出现窗口,版本号就失去意义了。
版本号还有一个额外好处:它是单调递增的,天然能识别 ABA。值从 10 变到 9 再变回 10,版本号已经从 1 变成 3,不会被误认为“没动过”。
在 Java 内存里,没有原生的“版本号 CAS”指令。要做到等价效果,需要把“引用 + 版本号”打包成一个对象,再对整体做 CAS。这个类会在 3.4 节出现。
3.4 Java 的落地:原子类
java.util.concurrent.atomic 包把 CAS 封装成了可以直接使用的原子类。按操作的数据类型,分为四类:
| 类别 | 代表类 | 用途 |
|---|---|---|
| 基本类型 | AtomicInteger、AtomicLong、AtomicBoolean |
原子更新基本类型 |
| 数组类型 | AtomicIntegerArray、AtomicLongArray、AtomicReferenceArray |
原子更新数组中的某个元素 |
| 引用类型 | AtomicReference、AtomicStampedReference、AtomicMarkableReference |
原子更新引用 |
| 字段更新器 | AtomicIntegerFieldUpdater、AtomicLongFieldUpdater、AtomicReferenceFieldUpdater |
原子更新某个类里的字段 |
其中两个引用类专门用来处理 ABA:
AtomicStampedReference:引用 +int版本号,能识别变化了多少次。AtomicMarkableReference:引用 +boolean标记,只能表示“动过/没动过”,无法区分次数。
以 AtomicStampedReference 为例,它把引用和版本号绑在一起:
1 | AtomicStampedReference<String> ref = |
compareAndSet 同时校验引用和版本号。只要中途发生过变化,版本号就对不上,CAS 会失败,从而避开 ABA。
字段更新器有几个限制:字段必须是 volatile,并且访问权限要允许更新器通过反射访问,通常不能是 private。它适合“已有类不方便改成原子类,但想对某个字段做原子更新”的场景。
3.5 为什么需要 Unsafe
原子类的源码里反复出现同一个类——Unsafe。要理解原子类为什么能保证原子性,绕不开它:它是这些原子类底层实现的入口。Java 语言本身既拿不到字段的内存地址,也发不出 CPU 原子指令,CAS 的语义最终要由一个能直接操作内存的类来完成,这就是 Unsafe 被引入的原因。
Unsafe 位于 sun.misc 包下,提供低级别、不安全的能力,包括:
- 内存操作(直接分配、读写内存)
- 内存屏障(
loadFence、storeFence、fullFence) - 对象与数组操作(字段偏移、数组基址与步长)
- CAS 操作(
compareAndSwapInt等) - 线程调度(
park、unpark) - Class 操作与系统信息
它之所以“不安全”,是因为这些能力绕过了 Java 语言层的检查,用错会直接破坏内存语义。
正常情况下拿不到它的实例。Unsafe.getUnsafe() 会检查调用者的类加载器,只有由 Bootstrap ClassLoader 加载的类才能通过,否则抛 SecurityException。常见的绕法是反射读取私有静态字段 theUnsafe。
版本上还有两个变化需要知道:
- JDK 9 之后模块化,反射访问
sun.misc可能触发非法反射警告;强封装下需要显式开放,例如--add-opens java.base/sun.misc=ALL-UNNAMED。 - JDK 23 起(JEP 471),
Unsafe中用于内存访问的方法被标记为弃用、准备移除,官方推荐迁移到VarHandle与MemorySegment。
另外,并非所有原子类在任何版本都走 Unsafe。JDK 8 的实现是 sun.misc.Unsafe + 字段偏移量;JDK 9 之后,compareAndSet 这类方法内部改用 VarHandle,部分批量方法仍通过 jdk.internal.misc.Unsafe。语义没变,源码细节变了。下面拆源码时以 JDK 8 为例。
3.6 AtomicInteger 源码拆解
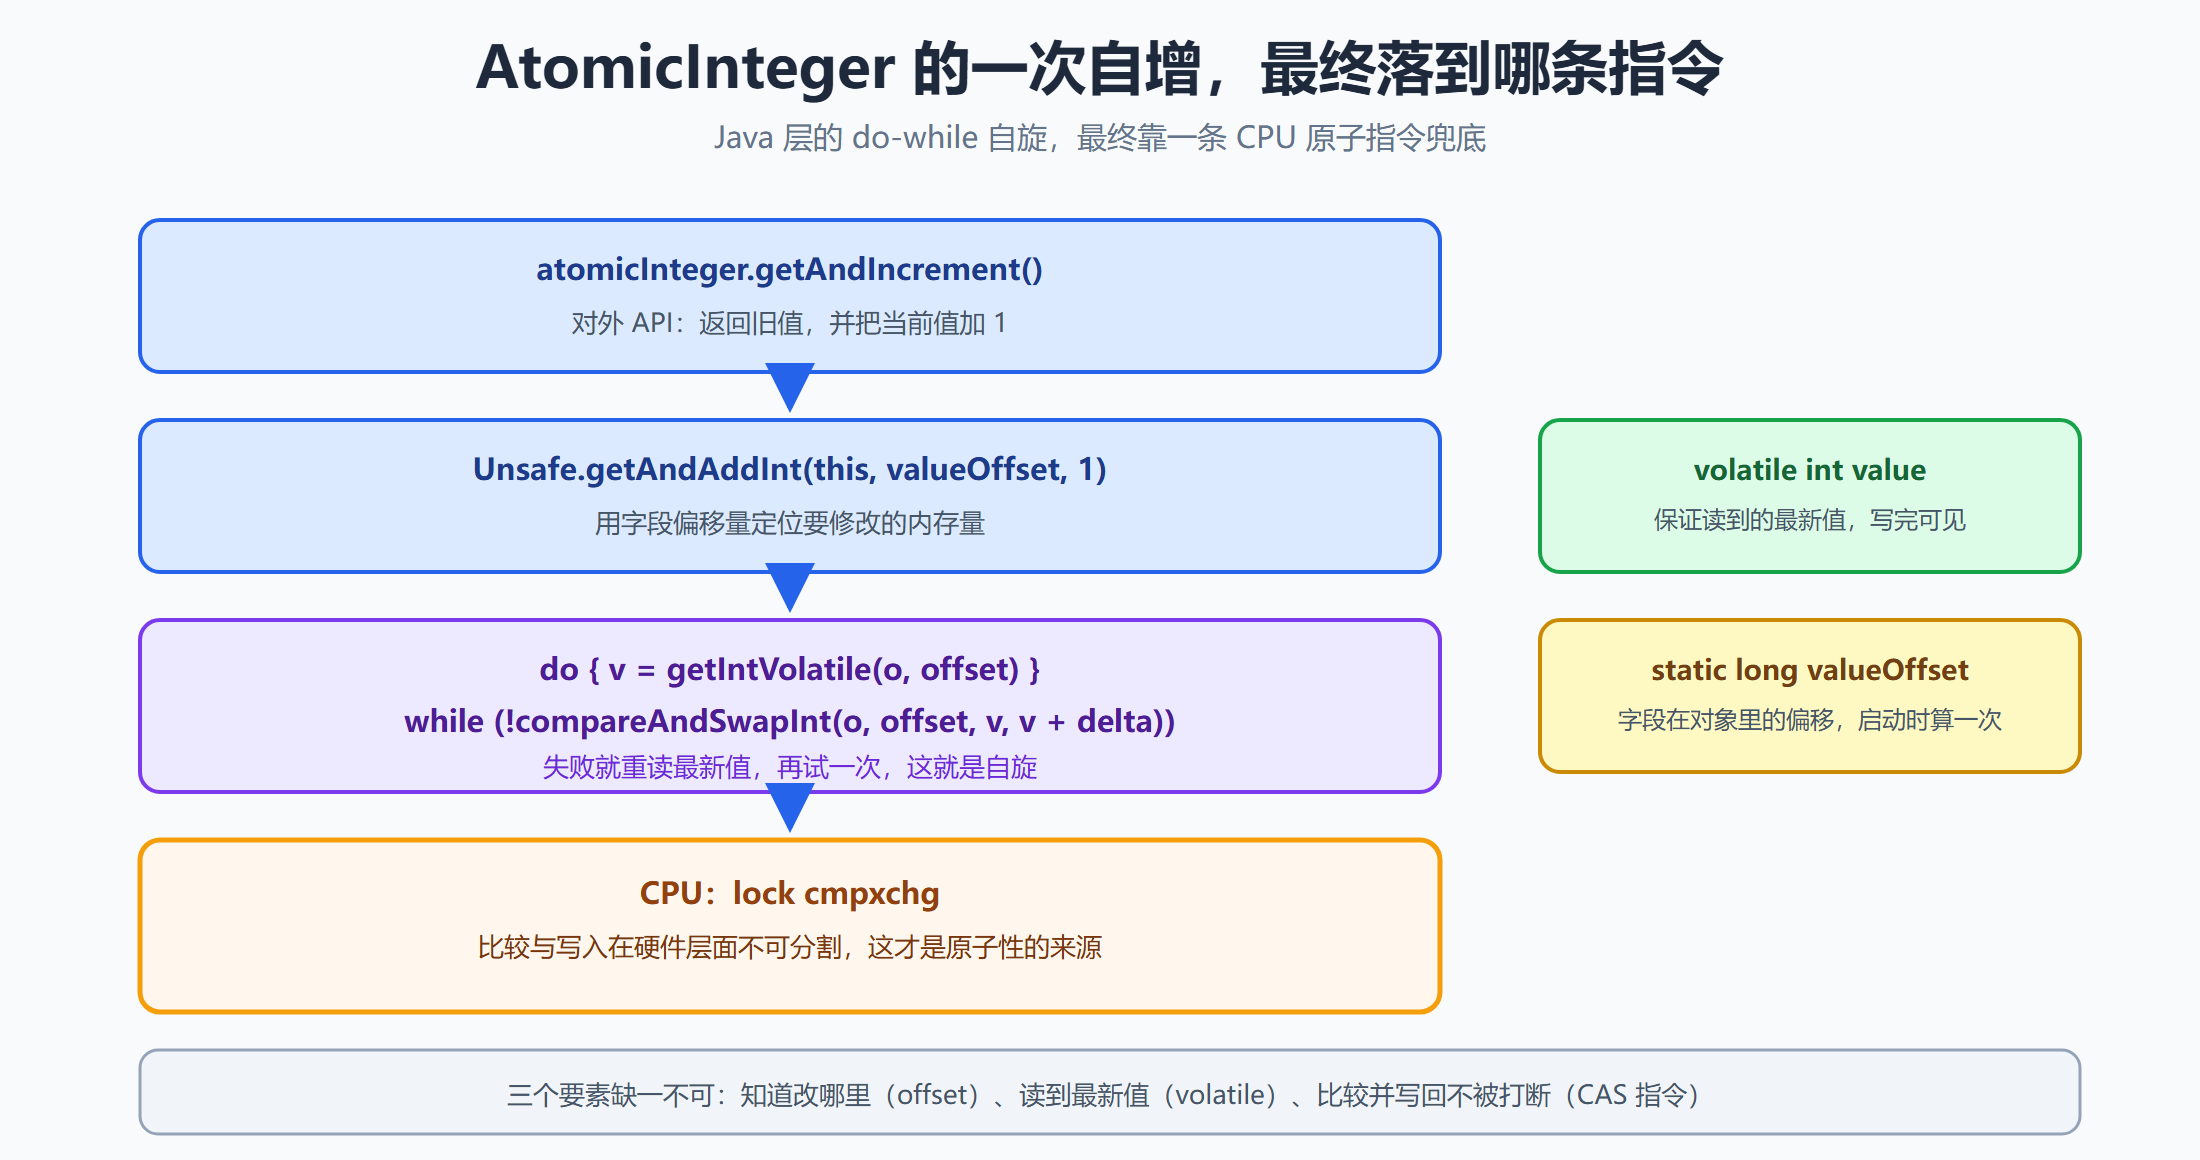
1 | // 获取 Unsafe 实例 |
Unsafe#getAndAddInt 的实现:
1 | public final int getAndAddInt(Object o, long offset, int delta) { |
对外的方法都复用它:
1 | public final int getAndAdd(int delta) { |
调用起来的效果如下:
1 | AtomicInteger counter = new AtomicInteger(0); |
这段源码里有四个要点:
Unsafe是入口:Java 层做不了的原子指令,通过它下发。valueOffset是定位:Java 不能直接取对象字段的地址,只能在类加载后算一次字段相对对象起始地址的偏移量。volatile int value是保鲜:保证getIntVolatile读到最新值,也保证写入后其他线程可见。getAndAddInt是自旋:CAS 失败就重新读、重新算,直到成功。
为什么 volatile 和 offset 缺一不可?没有 offset,Unsafe 不知道改哪里;没有 volatile,读到的可能是旧副本,CAS 会基于过期值反复失败,可见性也没有保障。但仅有 volatile 仍然不够——它不能让“读—算—写”变成一步,原子性来自 CAS 指令本身。
3.7 LongAdder:拆分热点
LongAdder 同样位于 java.util.concurrent.atomic 包,是原子类家族中专门为高并发累加设计的成员。它和 AtomicLong 解决同一个问题——多线程安全累加——但选择了另一条路:牺牲瞬时精确性,换取吞吐。
先看它要解决的瓶颈。单变量 CAS 不只是“抢不到”,还有缓存行的来回同步。多个核心反复写同一块缓存行,缓存一致性协议要不断让这块行在核心之间转移,这种开销叫缓存一致性流量。线程越多,这笔开销越大。
LongAdder 把累加状态拆成两部分:一个 base,和一个 Cell[] 数组。
- 没有竞争时,直接 CAS
base。 - 出现竞争时,每个线程根据自己的散列值(内部用
probe计算,可以理解为线程的散列种子)选择一个Cell,把增量累加到该Cell上。Cell里存的是“这段时间累计加了多少”,不是固定加一。 - 某个
Cell上冲突仍然严重,就扩容Cell数组,把热点进一步分散。 - 求和时,
sum() = base + 所有 Cell 的值。
所以它不是在“找不到 Cell 就失败”,而是在竞争出现时创建、扩容 Cell,把冲突摊开。
sum() 的语义也要注意:它是逐个读取 base 和 Cell 再相加。读的过程中,其他线程可能正在改某个 Cell,所以它拿到的不是某一瞬间的精确快照,而是一个近似值。这也是它适合统计、监控这类“允许短暂不一致”的场景,而不适合当余额或库存的原因。
四、悲观锁路线:synchronized 与 Monitor
回到第一条路。synchronized 是 Java 语言内置的互斥同步手段:用它修饰一个方法或一段代码,进入前必须先取得对应的锁,退出时释放;同一时刻,只有拿到锁的线程能执行被保护的代码。它是悲观策略最直接的语言级实现。
4.1 三种用法与锁对象
synchronized 有三种写法,锁的对象各不相同。
修饰实例方法,锁当前对象实例:
1 | synchronized void method() { |
修饰静态方法,锁当前类的 Class 对象:
1 | synchronized static void method() { |
静态成员不属于任何一个实例,归整个类所有,所以它锁的是类,而不是某个对象。
修饰代码块,锁括号里指定的对象或类:
1 | synchronized (this) { |
| 写法 | 锁对象 | 影响范围 |
|---|---|---|
| 实例方法 | this |
同一个实例的同步方法互斥 |
| 静态方法 | Class 对象 |
该类的所有实例共享这把锁 |
| 代码块 | 括号里的对象 | 取决于锁对象被多少线程共享 |
由此可以回答一个常见问题:静态 synchronized 方法和实例 synchronized 方法互斥吗?
不互斥。 一个线程调用实例方法,锁的是当前实例;另一个线程调用静态方法,锁的是 Class 对象。两把锁不同,自然不会互相阻塞。
几个实践中的注意点:
- 不要用
String常量作为锁对象。字符串常量池会复用对象,不同代码可能锁到同一个字符串,产生意料之外的互斥。 - 锁对象不能为
null,否则抛NullPointerException。 synchronized是可重入的,同一个线程可以多次进入同一把锁保护的代码。- 同步块抛出异常时,锁会自动释放,不需要手写
finally。
4.2 最初的实现:monitor
知道怎么用之后,下一个问题是:它凭什么能保证同一时刻只有一个线程进入?这要从 synchronized 最初的实现——monitor 说起。
同步代码块编译后,会出现 monitorenter 和 monitorexit 两条指令。前者标记同步块的开始,后者标记结束。字节码里通常是一个 monitorenter 配两个 monitorexit:一个对应正常执行路径,一个对应异常路径,保证两种情况都能正确释放锁。
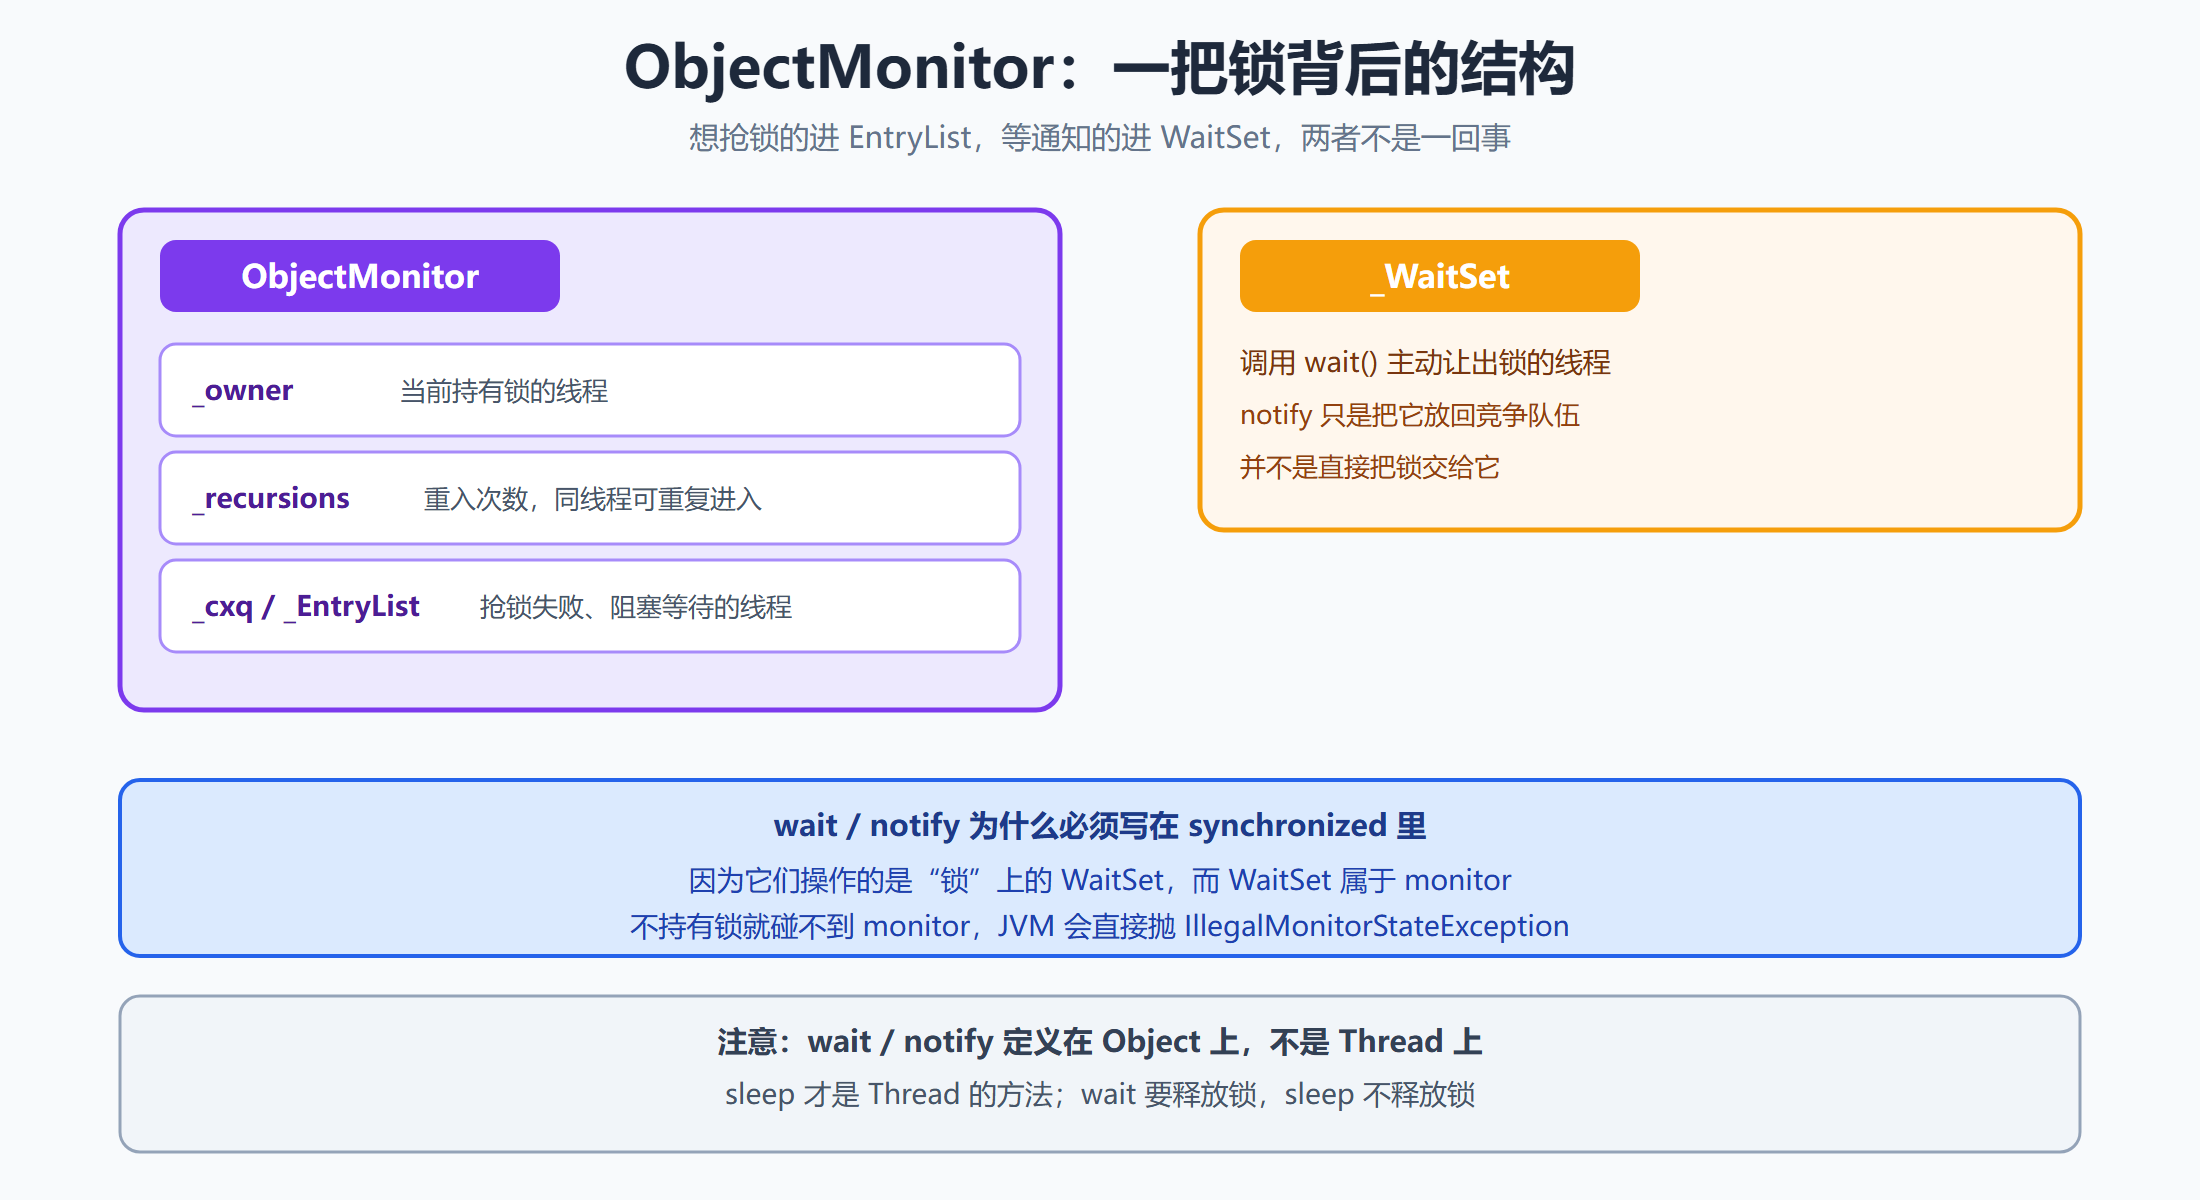
执行 monitorenter 时,线程尝试获取对象的监视器(monitor)。在 HotSpot 中,monitor 由 C++ 的 ObjectMonitor 实现。
这里需要修正一个流传很广的说法:“每个对象中都内置了一个 ObjectMonitor 对象”。更准确的理解是:
- 每个 Java 对象都有对象头,对象头里的 Mark Word 记录锁状态。
- 在基于 monitor 的实现中,Mark Word 会指向堆中的
ObjectMonitor。 ObjectMonitor是 JVM 在 C++ 层维护的结构,不是塞在 Java 对象里的字段。
ObjectMonitor 里几个关键成员:
_owner:当前持有锁的线程。_recursions:重入次数。同一个线程再次进入时加一,退出时减一,减到零才真正释放。_cxq/_EntryList:抢锁失败、阻塞等待的线程队列。_WaitSet:调用wait()主动让出锁的线程。
这种实现的代价是什么? 竞争失败的线程要挂起,释放时再唤醒。挂起和唤醒都需要操作系统参与调度,涉及用户态与内核态的切换;竞争越激烈,切换成本越高。也正因为如此,这种基于 ObjectMonitor 的实现被称为重量级锁。
方法级同步有什么区别? 修饰方法时,字节码里没有 monitorenter / monitorexit,取而代之的是方法访问标志 ACC_SYNCHRONIZED。JVM 在方法调用时检查这个标志,如果存在,就在进入方法前获取 monitor、退出时释放(包括异常退出)。效果和同步块一致,只是加解锁由 JVM 隐式完成,不需要显式字节码指令。
wait / notify 是什么? 它们定义在 Object 上,不是 Thread 上,也不是“抢锁失败后的处理”。wait() 让已经持有锁的线程释放锁,进入该对象的 _WaitSet;notify() / notifyAll() 负责唤醒 _WaitSet 中的一个或全部线程。正因为操作的是 monitor 上的等待队列,调用前必须持有该对象的锁,否则抛 IllegalMonitorStateException,这也是它们必须写在同步块里的原因。两个队列的分工与公平性的关系,留到 5.4 节展开。
顺带区分一下 Thread.sleep():sleep 不释放锁,只是让当前线程暂停;wait 会释放锁。
到这里,monitor 的实现方式和代价都清楚了:它能保证正确性,但竞争时要挂起线程。下一节看 HotSpot 如何针对不同竞争程度做优化。
4.3 synchronized 的优化:锁升级
重量级锁的代价,直接催生了锁升级。
在重量级锁下,加锁和解锁都要经过 monitor;即使没有竞争,也要走一遍 monitor 的加锁流程。一旦出现竞争,没抢到的线程要挂起,释放时再唤醒,而挂起和唤醒都由操作系统调度,涉及用户态与内核态的切换,还要付出上下文切换的成本。线程越多、临界区越短,这笔开销的占比越大——线程刚被挂起又被唤醒,真正用来执行业务的时间反而很少。
早期 synchronized 只有这一种实现,所以高并发下性能很差,很多代码宁愿改用 ReentrantLock,或者干脆避免共享状态。为了把这个开销降下来,HotSpot 才引入锁升级:根据竞争程度,在更轻的锁状态之间切换。它并不是让重量级锁本身变快,而是让大多数没有激烈竞争的场景根本不必走到重量级锁。
锁状态记录在对象头的 Mark Word 里,不同的状态对应不同的锁标志位:
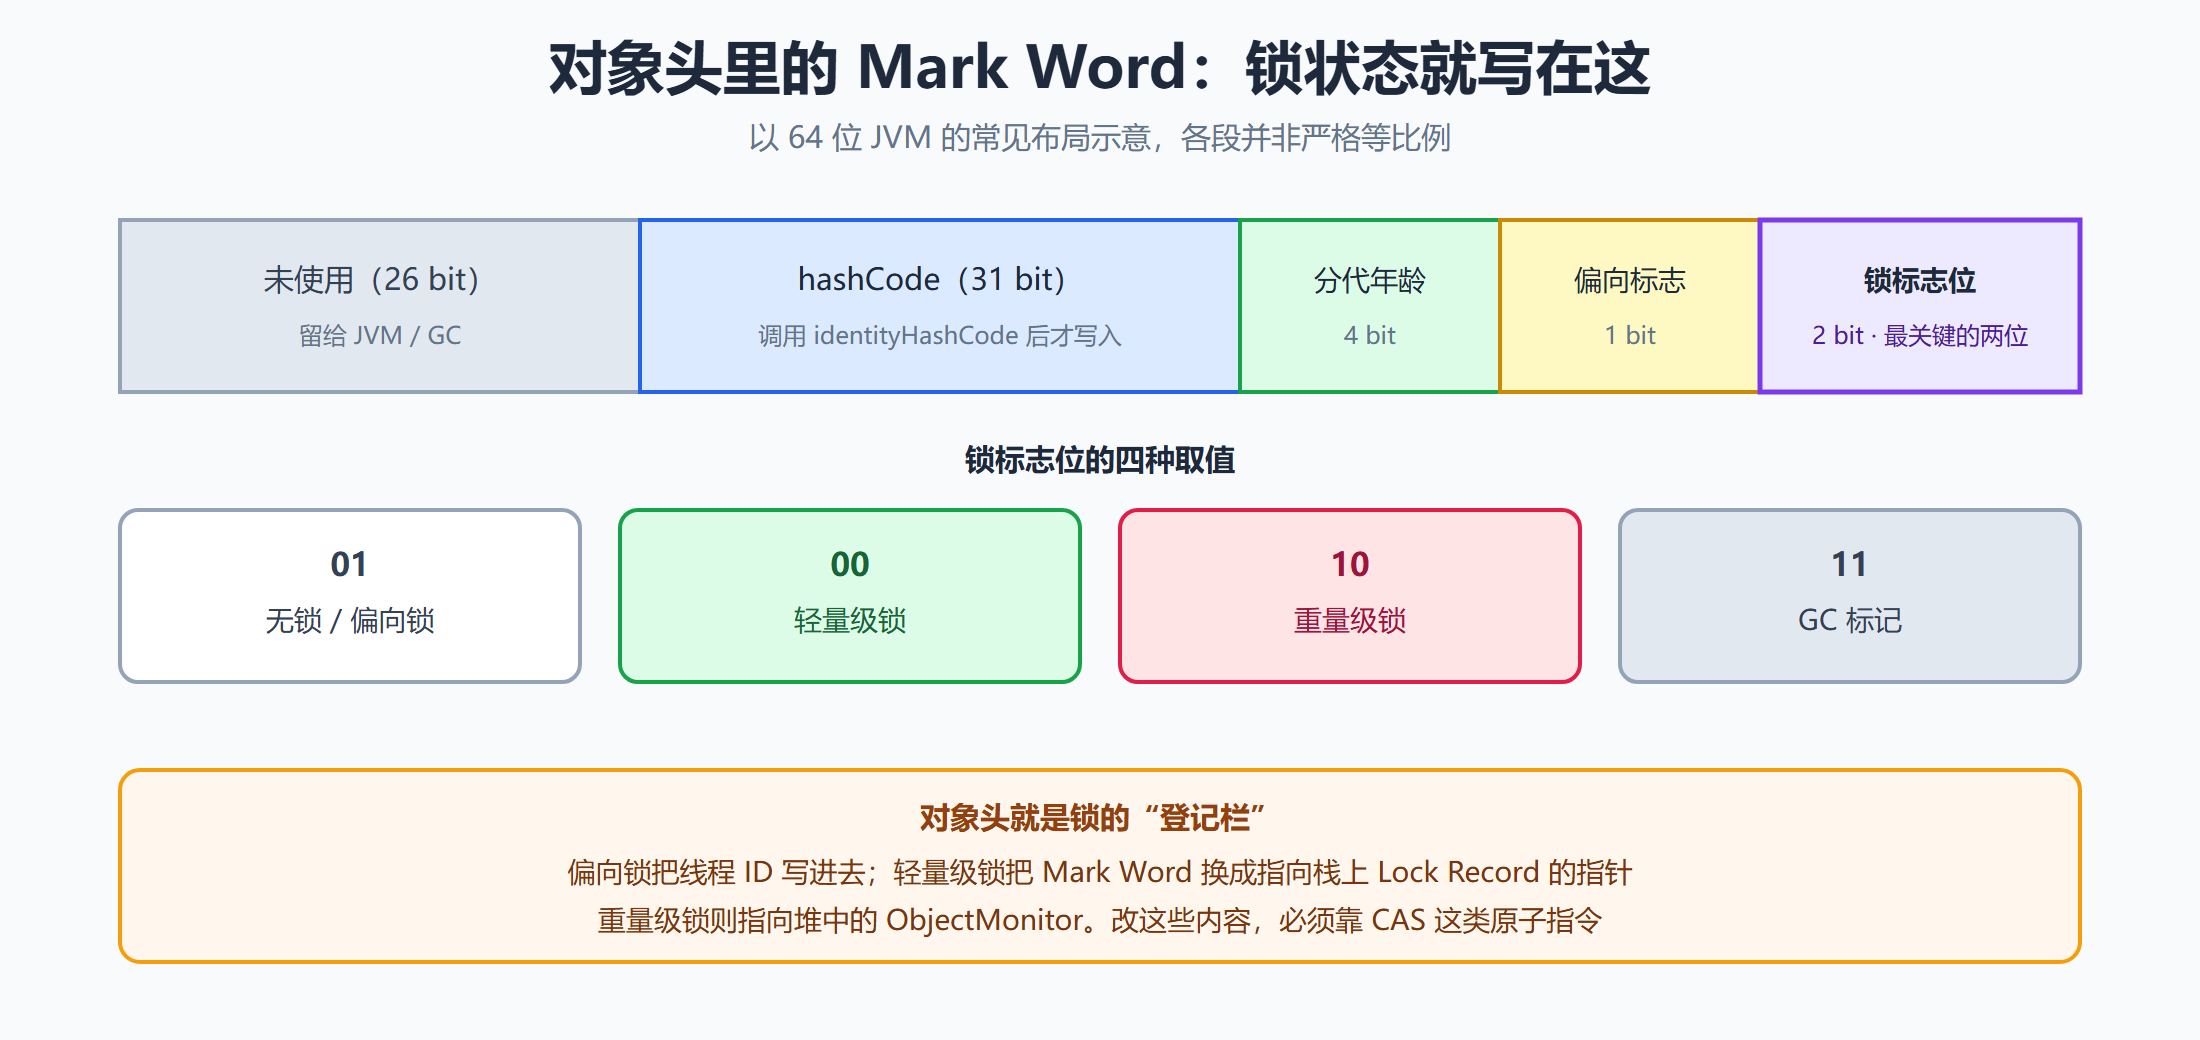
下面先按“偏向锁仍启用”的版本来讲;JDK 15 之后偏向锁默认关闭,实际路径会从无锁直接进入轻量级锁,原因在 4.5 节说明。
- 无锁:对象还没有被任何线程锁定。
- 偏向锁:第一个线程加锁时,用一次 CAS 把线程 ID 写进 Mark Word。之后同一个线程再进入,只要比对线程 ID 即可,连 CAS 都省了。
- 轻量级锁:第二个线程来竞争时,偏向锁被撤销,升级为轻量级锁。线程在自己的栈帧里创建 Lock Record,复制对象头的 Mark Word,再用 CAS 把对象头替换为指向 Lock Record 的指针。成功就拿到锁,失败就自旋。
- 重量级锁:自旋失败或竞争加剧时膨胀,交给
ObjectMonitor,竞争线程挂起排队。
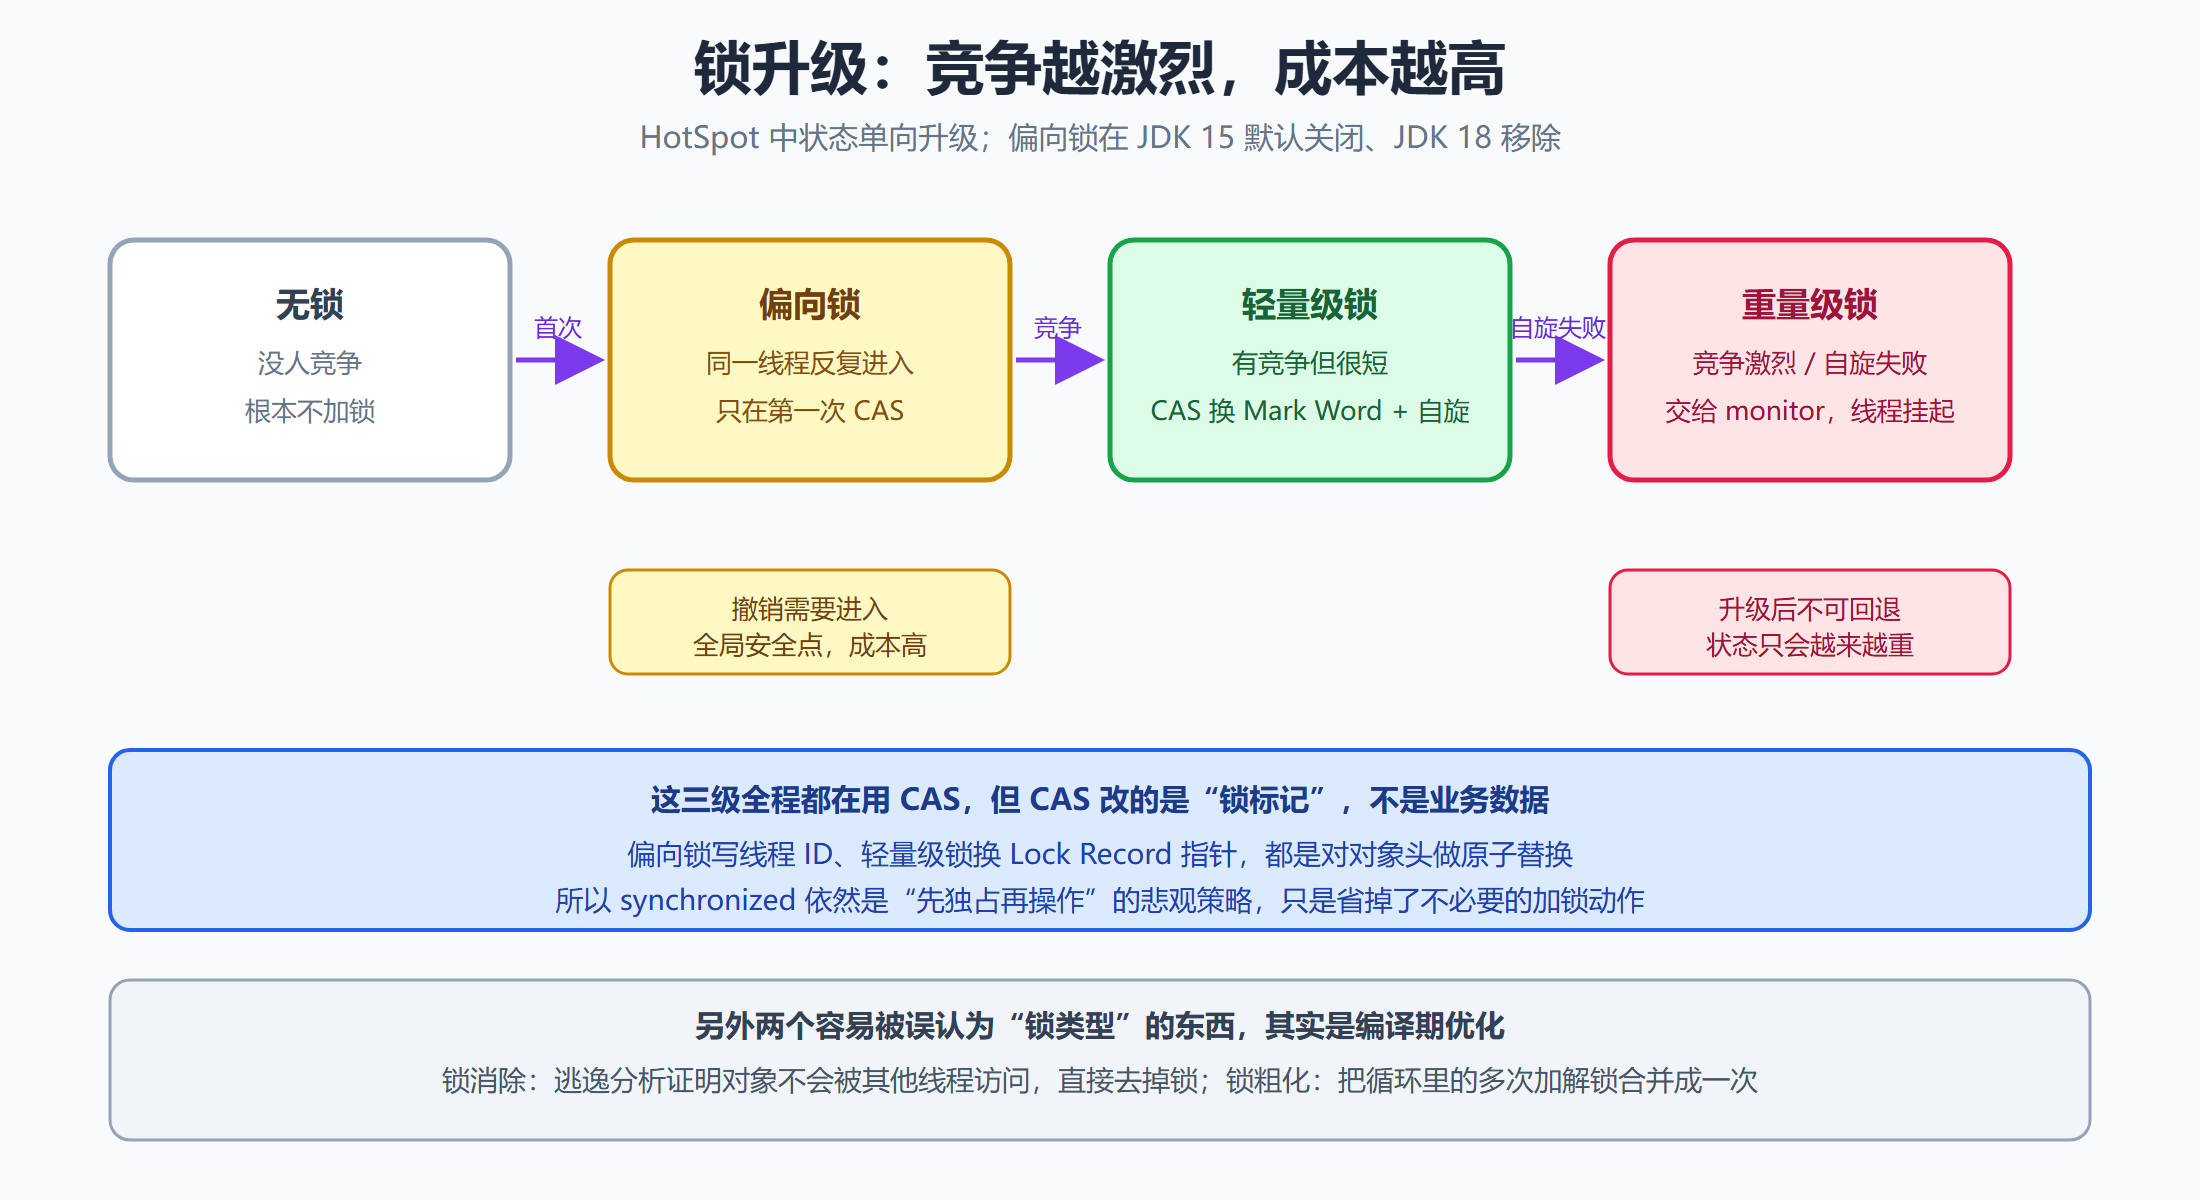
| 状态 | Mark Word 内容 | 加锁动作 | 何时进入该状态 |
|---|---|---|---|
| 无锁 | 普通对象头 | 无 | 对象刚创建 |
| 偏向锁 | 线程 ID | 一次 CAS | 第一个线程加锁 |
| 轻量级锁 | 指向 Lock Record 的指针 | CAS + 自旋 | 第二个线程竞争 |
| 重量级锁 | 指向 ObjectMonitor | monitor 接管,线程挂起 | 自旋失败或竞争加剧 |
围绕这三级状态,有几个细节值得展开。
偏向锁解决的是“同一线程反复进入”的场景。 第一次加锁时,JVM 用一次 CAS 把线程 ID 写进 Mark Word;之后同一个线程再进入,只比对 ID,不再执行 CAS。只要出现第二个线程,偏向锁就会失效:JVM 需要等到全局安全点(safepoint),暂停所有线程,检查对象状态并撤销偏向,然后进入轻量级锁。撤销之所以昂贵,就是因为它要打断整个 JVM 的运行。
升级方向是单向的。 轻量级锁自旋失败会膨胀为重量级锁,重量级锁不会自动退回轻量级。偏向锁是个例外:它可以被撤销,撤销后对象回到无锁,或直接进入轻量级锁。
这三者是同一把锁的三种状态,不是三种并列的锁类型。 锁消除和锁粗化也不属于状态,它们是编译期优化,下一节单独说。
版本变化(JDK 15 默认关闭、JDK 18 移除)留到 4.5 节展开。
到这里可以回答一个常见的疑问:synchronized 内部也用了 CAS,为什么仍算悲观锁? 因为这里的 CAS 只作用在对象头上——它抢的是“锁标记”,不是业务数据。抢不到就继续抢或排队,策略仍然是“先独占,再操作”。这也是它和 3.6 节 AtomicInteger 的分界线。
4.4 编译期优化:锁消除与锁粗化
锁升级解决的是“每次加锁走多长的路径”;锁消除和锁粗化则发生在编译期,直接改变加锁的位置和次数。
这两项都是 JIT 在编译期做的优化,不是锁的状态,也不是源码层面的改写。
锁消除依赖逃逸分析。 JIT 会判断一个锁对象会不会“逃逸”:
- 方法逃逸:对象作为返回值返回,或作为参数传给别的方法。
- 线程逃逸:对象被赋值给共享字段、静态字段,可能被其他线程访问。
如果对象只在方法内部创建和使用,既没有返回,也没有发布到其他线程,就是非逃逸。非逃逸对象不可能被其他线程拿到,锁也就不可能产生竞争,JIT 可以直接把锁去掉。
一个典型例子:
1 | public String build() { |
StringBuffer 的 append 是 synchronized 实例方法,锁的是 sb 这个对象。这里 sb 是局部变量,方法返回的是 toString() 生成的新字符串,不是 sb 本身。其他线程拿不到 sb,append 上的锁就不可能产生竞争,JIT 可以把它消除。
如果对象逃逸了,就不能消除:
1 | private StringBuffer buffer = new StringBuffer(); |
buffer 是字段,又被 getBuffer() 返回,其他线程可以拿到它,锁必须保留。
还要注意两点:判断依据是“对象有没有逃逸”,不是“当前有没有并发”;锁消除通常要等 JIT 编译后才生效,解释执行阶段仍然会加锁。
锁粗化是把相邻的多次加解锁合并成一次。 比如循环里每次都对同一把锁加解锁:
1 | for (int i = 0; i < 100; i++) { |
JIT 可能把锁移到循环外面,变成一次加锁、一次解锁:
1 | synchronized (lock) { |
这样加解锁次数从 100 次降到 1 次,省掉了重复的锁操作。但锁的持有时间也从“每次一小段”变成“整个循环”。如果有其他线程在等这把锁,它们要等更久,并发度反而下降。所以锁粗化不必然带来性能提升,是否合并由编译器综合权衡。
4.5 偏向锁的移除
回到锁状态。偏向锁是锁升级里最特殊的一级,也是唯一被移除的一级。
它的设计目标很明确:如果一个同步块长期只被同一个线程访问,每次进入都做一次 CAS 是浪费。偏向锁用一次 CAS 把线程 ID 写进 Mark Word,之后这个线程再进入,只比对 ID 即可,相当于“这把锁已经偏向你了”。
这套优化在早期确实有用。HashTable、Vector 这类老集合大量使用 synchronized,单线程频繁访问时,偏向锁能省掉大量 CAS。但随着 ConcurrentHashMap 等集合改用 CAS、volatile 和细粒度锁,应用代码也越来越少依赖整表 synchronized,偏向锁的收益场景明显缩小。
它的成本却没有下降:
- 撤销偏向需要进入全局安全点,暂停所有线程,再逐个检查对象状态,代价很高。
- 偏向锁的实现侵入同步子系统的多个环节,增加了理解、维护和重构的难度。
收益下降、成本仍在,OpenJDK 最终决定移除它。JDK 15(JEP 374)将偏向锁标记为废弃并默认关闭,需要显式开启 -XX:+UseBiasedLocking 才能使用;JDK 18 彻底移除。因此在 JDK 15 之后,默认的锁升级路径是:无锁 → 轻量级锁 → 重量级锁,偏向锁这一级不存在了。
五、竞争失败之后:自旋、阻塞与公平性
到这里,两条路线都已经讲完。但还有一个共同问题没有回答:竞争失败之后,线程去哪?
5.1 直接失败
第一种是立刻返回失败,不等待、不重试。
它适合“业务可以马上给用户反馈”的场景:
- 秒杀扣库存失败,直接返回“已售罄”,而不是让请求排队等锁。
- 乐观锁版本冲突,返回“数据已更新,请刷新后重试”,由用户决定下一步。
tryLock()拿不到锁就返回false,调用方可以走降级逻辑。
这类做法的价值在于快速失败:与其让请求卡住,不如尽早告诉调用方结果。
5.2 自旋
第二种是不放弃 CPU,循环重试。自旋有两个层次,需要分开看。
5.2.1 库代码里的自旋:CAS 重试
AtomicInteger 的 getAndAddInt 是一个典型的库级自旋:
1 | do { |
CAS 失败就重新读、重新算,直到成功。这里没有线程挂起,失败只表示“这次没抢到”,由库代码自己决定继续重试。
它适合两个条件同时成立:
- 临界区很短:一次操作只涉及几次内存读写,重试窗口小,冲突概率低。
- 竞争不激烈:同时争同一个变量的线程不多,重试几次就能成功。
两个条件缺一不可。临界区短但竞争激烈,窗口虽小,插进来的线程依然多;临界区长但竞争少,一次失败后要等很久才有下一次机会。任一条件不满足,自旋都会变成 CPU 空转——线程一直在做无效的读取和 CAS,占着 CPU 却不推进。
5.2.2 JVM 锁的自旋:轻量级锁
synchronized 的轻量级锁也用自旋。它抢锁的方式是 CAS 替换对象头里的 Mark Word:成功就拿到锁;失败说明有竞争,先不急着阻塞,而是循环重试一段时间。
HotSpot 用的是自适应自旋:自旋次数不是固定值,而是根据上一次在该锁上的自旋成功率、锁持有者的状态动态调整。上一次自旋成功过,就允许多转几次;总是失败,就早点放弃去阻塞。
自旋期间,CPU 会执行 pause 指令。它有两个作用:一是延迟流水线执行,减少空转的资源消耗;二是避免退出循环时因内存顺序冲突而清空流水线。它只是提示,不是睡眠。
需要说明的是,自适应自旋不是指数退避。它没有“失败后 sleep 一段时间再试”的机制;指数退避通常出现在应用层的重试策略或分布式锁的客户端重试里,不在 JVM 的锁自旋中。
如果自旋仍然失败,轻量级锁就会膨胀为重量级锁,线程进入阻塞排队。这就是下一节的内容。
5.3 阻塞排队
第三种是放弃 CPU,进入等待队列,等锁释放时被唤醒。
路径大致是:
- 尝试获取锁,失败。
- 自旋一小段时间,仍失败。
- 进入
_EntryList(或_cxq),调用park挂起。 - 持有者释放锁时,
unpark唤醒其中一个线程。 - 被唤醒的线程重新参与竞争,不是直接拿到锁。
最后一步很关键。正因为被唤醒后还要和新来的线程一起抢,synchronized 才是非公平锁:后来者可能先抢到,等待最久的线程不一定先拿到。
阻塞的代价是上下文切换。线程挂起和恢复都要操作系统参与,对 CPU 来说是“换人”的成本。这也是为什么临界区很长、竞争激烈时,阻塞比自旋更划算:自旋大概率会失败,不如早早让出 CPU。
5.4 两个队列与公平性
排队的过程中,有两个队列经常被混为一谈。ObjectMonitor 里,它们服务的不是同一件事。先看差别:
| 队列 | 谁进来 | 什么时候离开 | 是否还持有锁 |
|---|---|---|---|
_EntryList |
抢锁失败、阻塞等待的线程 | 锁释放后被唤醒,重新竞争 | 否 |
_WaitSet |
调用 wait() 主动让出锁的线程 |
被 notify / notifyAll 移回竞争队列 |
否 |
由此可以澄清一个常见误记:“synchronized 是公平锁,会随机唤醒线程”。
这句话混了两件事:
- 锁的公平性说的是
_EntryList里抢锁的顺序。synchronized不保证先来先得,所以它是非公平锁。 notify的唤醒顺序说的是_WaitSet里叫醒谁。JVM 规范只保证唤醒“任意一个”,HotSpot 的实现更接近后等先醒(LIFO),但写代码时不能依赖这个顺序。
notify 也不是把锁直接交给某个线程,它只是把线程从 _WaitSet 移回竞争队列;线程醒来后仍要重新抢锁。理解这一点,wait/notify 的很多“奇怪行为”就都能解释了。
非公平锁的代价是线程饥饿:如果总有新线程插队,等待很久的线程可能一直抢不到。需要严格顺序时,才考虑公平锁;ReentrantLock 可以通过构造参数开启公平模式,这部分属于显式锁,本文不展开。
六、如何选择
两条路线、三级状态,以及竞争失败后的处理都讲完了。最后把前面拆开的内容合到一张决策表里。
6.1 决策维度
实际选型时,看四个维度:
- 冲突概率:读多写少,还是写多冲突激烈
- 临界区长度:几步内存操作,还是包含 IO、远程调用
- 变量个数:单个变量,还是多个字段需要一起更新
- 附加需求:是否需要可中断、超时、公平
6.2 决策表
| 场景 | 选择 | 理由 |
|---|---|---|
| 单变量计数、读多写少 | AtomicInteger / AtomicLong |
无阻塞,冲突少时开销低 |
| 超高并发累加 | LongAdder |
分散热点,接受 sum() 非快照 |
| 写多、冲突激烈 | synchronized |
避免大量失败重试 |
| 临界区长、含 IO 或多步业务 | synchronized |
CAS 只适合单点更新,不适合长事务 |
| 多字段需要一起原子更新 | synchronized 或封装成对象 |
CAS 管不了多个变量 |
| 需要可中断、超时、公平 | ReentrantLock |
synchronized 不提供这些能力 |
6.3 三条结论
第一,标签是分层的,不能互相推导。
悲观/乐观是策略,公平/非公平是调度,偏向/轻量/重量是实现状态。同一把锁可以同时拥有多个标签,标签之间不构成矛盾。
第二,锁升级是成本优化,不是策略改变。
synchronized 从偏向到重量级,一直在用 CAS,但 CAS 改的是锁标记,不是业务数据。它始终是“先独占,再操作”。
第三,粒度决定选型。
synchronized 保护的是一段代码,CAS 保护的是一个变量的一次更新。粒度不同,适用的场景自然不同。把两者放在一起比“谁更快”,本身就问错了问题。
七、总结
回到开头那个问题:count++ 为什么会丢一次更新?
因为它是“读—算—写”三步,中间存在窗口。可见性只能保证读到最新值,不能消除这个窗口;内存屏障也只能约束顺序,不能把三步合成一步。要保住原子性,要么互斥,要么冲突检测加原子写入。
这两种思路落到 Java 里,就是两条实现路线:
- 悲观路线:
synchronized把锁加在对象头上,用 monitor 管理等待队列。 - 乐观路线:CAS 直接作用在变量地址上,用自旋处理失败。
它们的分界线不是“有没有用 CAS”,而是“操作之前是否必须先获得独占权”。把这条线划清,再去看 ReentrantLock、AQS、读写锁,就不会越学越乱——那些内容回答的仍然是同样的问题,只是换了锁的位置和排队方式。