Java 并发基础全解:从进程与线程到多线程、线程安全与死锁
想真正理解多线程,不能一上来就背"什么是并发、什么是死锁"。得先搞清楚最底层的执行单元长什么样——进程是什么、线程是什么、各自的资源怎么划分,再往上谈并发、谈切换、谈安全。本文就按这条线,从地基开始一层层往上砌。
阅读路线
全文按"是什么 → 什么样 → 为什么 → 怎么运行 → 会出什么问题"推进,可以按需跳读:
- 第一、二章(是什么):进程与线程的概念和区别;进程/线程各自持有什么资源,把 PC、虚拟机栈、本地方法栈讲透。
- 第三章(在 Java 里长什么样):Java 线程和操作系统线程是什么关系——用户线程/内核线程、三种线程模型、平台线程与虚拟线程。
- 第四章(几个关键名词):并发与并行是什么、同步与异步是什么——后面所有讨论都建立在这几个词上。
- 第五章(为什么):为什么要用多线程——单核上靠什么提效率、多核上又收益在哪。
- 第六~八章(怎么运行):线程生命周期与六种状态、上下文切换、sleep/wait 与 run/start。
- 第九章(会出什么问题):线程安全、内存泄漏、死锁。
一、进程与线程:先弄清"执行单元"到底是什么
1.1 进程:程序的一次执行过程
进程是程序的一次执行过程,是系统运行程序的基本单位,因此它是动态的——系统运行一个程序,就是一个进程从创建、运行到消亡的过程。
在 Java 里,当我们启动 main 方法时,其实就是启动了一个 JVM 进程,main 方法所在的线程就是这个进程里的一个线程,也叫主线程。不止 Java,浏览器、抖音这类软件,只要被启动,就创建了一个进程,程序代码就在这个进程中运行。
一个进程被创建出来,操作系统至少要为它做这几件事:
- 分配独立的虚拟地址空间(对应一套页表);
- 分配文件描述符、权限、信号、CPU 时间配额等资源;
- 把程序代码加载进地址空间的代码段;
- 之后,就可以在这个进程里创建多个线程来真正执行代码。
一句话概括:进程是操作系统资源分配的最小单位,同时一个进程内部可以有多个线程——这也是后面所有内容的重点。
1.2 线程:进程内部的执行流
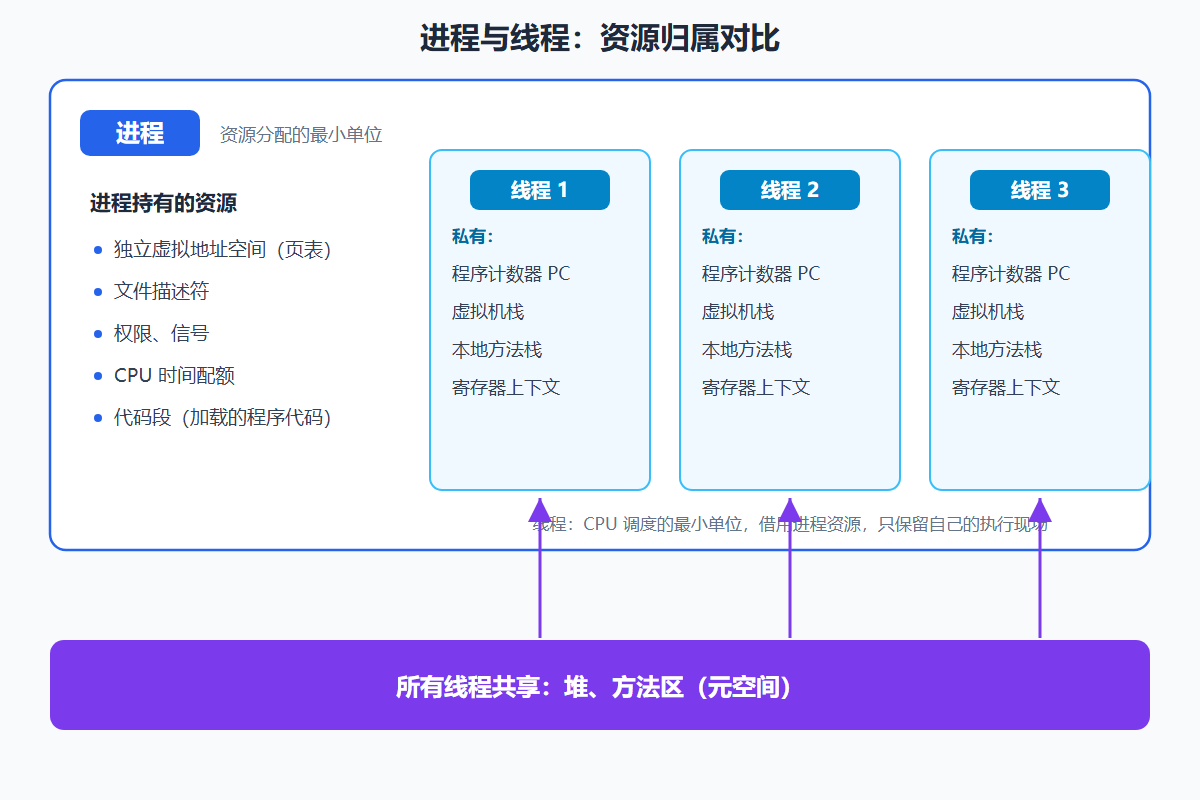
线程是进程内部的执行流,是 CPU 调度的最小单位。
它不拥有系统资源,而是"借用"所属进程的全部资源,只保留自己的执行现场。具体来说:
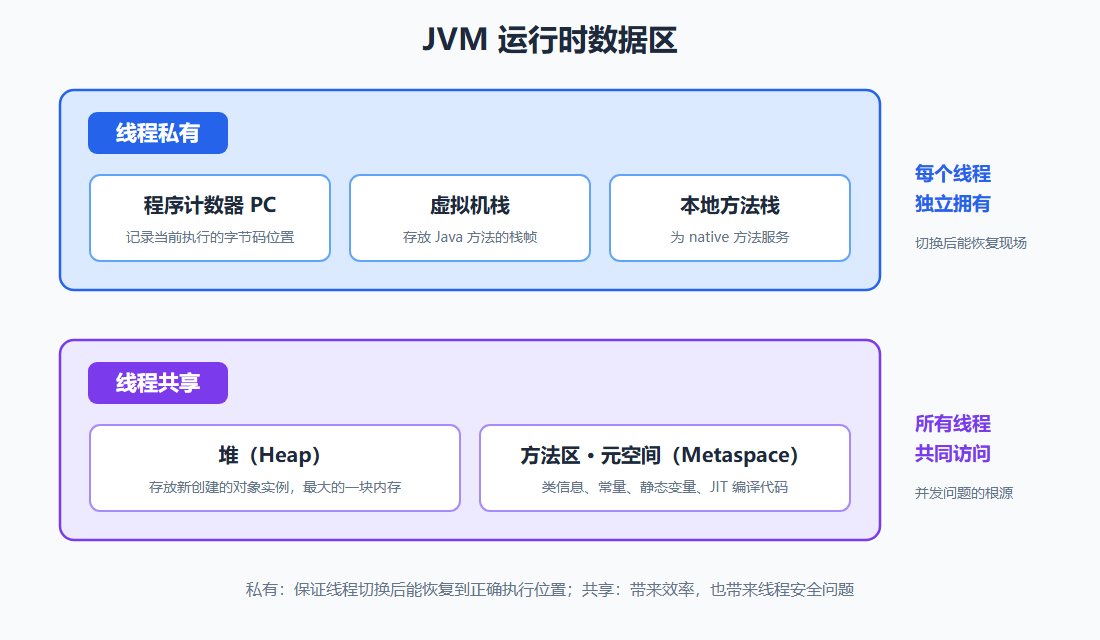
- 线程自己持有:程序计数器 PC、虚拟机栈、本地方法栈、寄存器上下文。
- 同类线程共享:堆和方法区(JVM 里方法区的实现就是元空间)。
堆和方法区是所有线程共享的资源。堆是进程中最大的一块内存,主要用于存放新创建的对象(几乎所有对象都在这里分配内存);方法区主要用于存放已被加载的类信息、常量、静态变量、即时编译器编译后的代码等数据。
1.3 一张图看清:进程 vs 线程
| 维度 | 进程 | 线程 |
|---|---|---|
| 定义 | 程序的一次执行过程 | 进程内部的执行流 |
| 资源 | 拥有独立地址空间与全部资源 | 借用进程资源,只保留执行现场 |
| 私有资源 | 地址空间、文件描述符等 | PC、虚拟机栈、本地方法栈、寄存器上下文 |
| 共享资源 | —— | 堆、方法区 |
| 系统定位 | 资源分配的最小单位 | CPU 调度的最小单位 |
| 切换开销 | 大 | 小(因此被称为轻量级进程) |
| 隔离性 | 强,进程间相互独立 | 弱,同进程线程极易相互影响 |
二、线程里有什么,进程里有什么
上一节把"私有 / 共享"列成了清单,这一节就把清单上的每一项讲透——尤其是 PC、虚拟机栈、本地方法栈,它们是理解"为什么线程要私有资源"的关键。
2.1 线程私有的资源
- 程序计数器 PC(Program Counter Register):一块很小的内存,记录当前线程的代码执行到了哪个位置,方便下一步取指令。
- 虚拟机栈(JVM Stack):存放栈帧。有方法被调用,就会压入一个对应的栈帧。
- 本地方法栈(Native Method Stack):为
native方法服务。 - 寄存器上下文:CPU 寄存器现场,随线程切换一起保存与恢复。
2.2 线程共享的资源
- 堆(Heap):存放对象实例,是最大的一块内存。
- 方法区 / 元空间(Method Area / Metaspace):存放类信息、常量、静态变量、JIT 编译后的代码等。
2.3 深入:PC 和两个栈到底在做什么
程序计数器 PC
PC 记录的是"当前线程下一条要执行的字节码指令地址"。它有两个作用:
- 字节码解释器通过改变 PC 来依次读取指令,从而实现顺序、选择、循环、异常处理等流程控制;
- 多线程下,PC 用于记录当前线程的执行位置,这样线程切换回来时能知道上次运行到哪了。
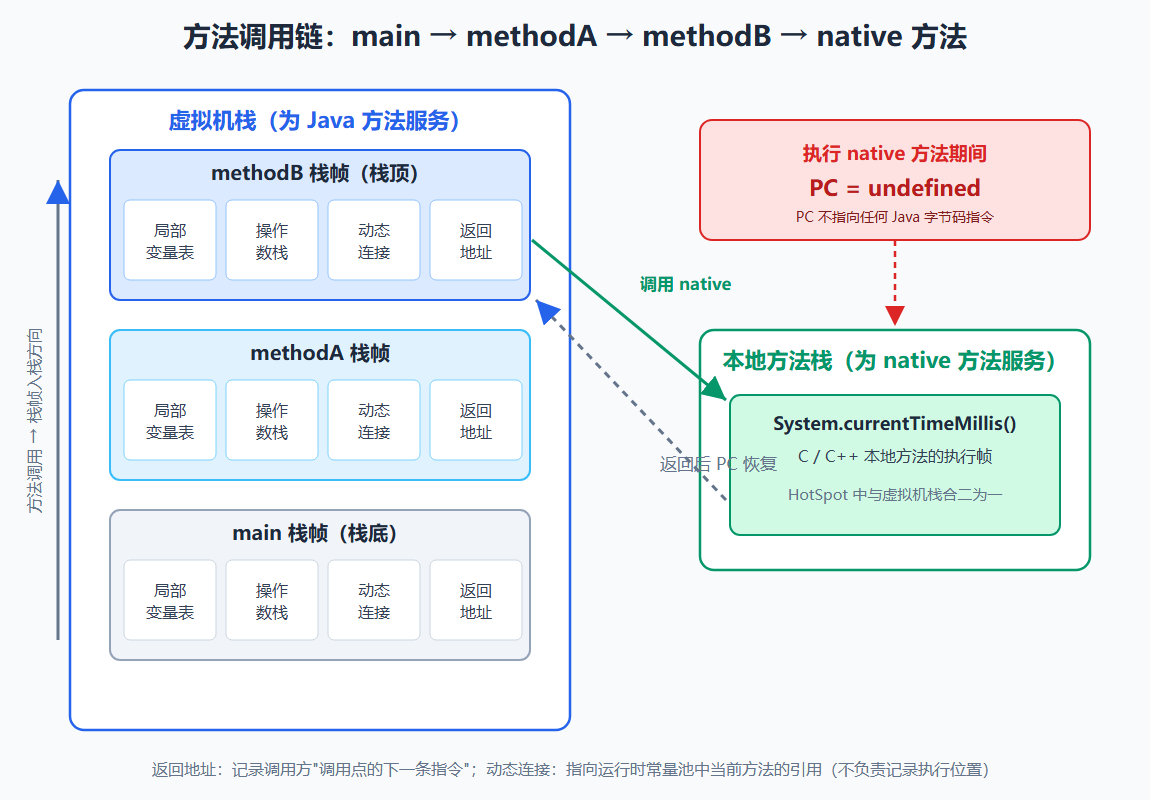
注意一个细节:当线程执行的是 native 方法时,PC 记录的是 undefined 地址;只有执行 Java 代码时,PC 记录的才是下一条指令的地址。
虚拟机栈与栈帧
每个 Java 方法在执行前都会创建一个栈帧(Stack Frame),一个栈帧包含四部分:
- 局部变量表:存这个方法里的局部变量;
- 操作数栈:专门用来做运算。比如执行
add(1,2),会把操作数按规则入栈,再按运算规则出栈计算——学过数据结构的话,这就是一个标准的栈式求值过程; - 动态连接:一个指向运行时常量池中"当前方法"的引用,用于把方法里的符号引用解析成直接引用。注意,它不是用来记录"代码执行到哪一行"的;
- 返回地址:记录调用方在"调用点下一条指令"的位置。方法返回后,程序靠它回到调用方继续往下走。真正负责"回到哪里"的是返回地址,不是动态连接,这一点很容易记混。
本地方法栈
本地方法栈和虚拟机栈作用相似,区别是:虚拟机栈为执行 Java 方法(字节码)服务,本地方法栈为执行 native 方法服务。在 HotSpot 虚拟机上,两者合二为一。
这里把 native 方法这个名词说清楚。native 是 Java 的一个关键字,被它标记的方法,在 Java 源码里没有实现体、只有一行声明,真正的逻辑由其他语言(通常是 C/C++)编写,调用时由 JVM 直接执行那段本地代码。为什么需要这种机制?因为有些能力 Java 侧根本不具备:取系统当前时间、读写硬件、创建和调度操作系统线程——这些都要走操作系统,而能触到操作系统的只有 C/C++ 代码。例如 System.currentTimeMillis() 就是一个 native 方法:Java 里只声明,真正取时间的逻辑在 JVM 的 C++ 代码里。
顺带把 HotSpot 也交代清楚:"JVM" 是一份规范,HotSpot 是这份规范的参考实现,也就是官方 OpenJDK / Oracle JDK 默认自带的那个 JVM(此外还有 Eclipse OpenJ9 等其他实现)。我们平时说"Java 虚拟机",指的基本都是 HotSpot;它名字里的"热点",来自其 JIT 编译器会在运行时识别执行特别频繁的"热点代码"并编译优化。
2.4 一个完整例子:把 PC、虚拟机栈、本地方法栈串起来
假设一个线程执行这样一条调用链:
1 | main() → methodA() → methodB() → System.currentTimeMillis()(native 方法) |
整个过程如下:
- 线程刚启动,虚拟机栈是空的;主线程开始执行
main(),压入main的栈帧,PC 指向main的第一条字节码。 main里调用methodA:返回地址记为"main中调用点的下一条指令",PC 指向methodA的字节码,methodA的栈帧入栈——栈变成了[main, methodA]。methodA里调用methodB:同理,methodB栈帧入栈——栈变成[main, methodA, methodB]。methodB里调用 native 方法System.currentTimeMillis():执行切到本地方法栈,此时 PC 值变为 undefined(不指向任何 Java 字节码)。- native 方法返回,PC 恢复,回到
methodB继续执行;methodB执行完,栈帧出栈,PC 恢复到methodA的返回地址,methodA继续。 methodA执行完,栈帧出栈,PC 恢复到main的返回地址,main继续,直到整个栈清空。
一句话记住:虚拟机栈负责"Java 方法一层层调用",本地方法栈负责"native 方法这一层",而 PC 只关心"当前这一层执行到哪条指令"——一旦进了 native,PC 就交白卷(undefined)。
2.5 为什么 PC、虚拟机栈、本地方法栈必须是私有的
原因只有一个词:多线程。
多线程下,线程会反复被切换。可能线程 1 跑到一半,来了个优先级更高的线程,或者它的时间片到期了,CPU 资源就被抽走、调度给了别的线程。如果线程 1 没有自己私有的 PC、虚拟机栈、本地方法栈,那么下次调度回来时,就完全不知道执行到哪了。
所以把这些执行现场做成线程私有,本质是:下次切回来时,还能准确恢复到上次的运行状态。
三、Java 线程与操作系统线程的关系
3.1 用户线程与内核线程
- 用户线程:由用户空间的运行时/程序自己管理和调度,运行在用户空间(专给应用程序使用)。
- 内核线程:由操作系统内核管理和调度,运行在内核空间(只有内核程序能访问)。
两者的特点对比:
- 用户级线程由运行库在用户空间调度,创建和切换成本较低;能否利用多核,取决于映射模型——多对一模型无法并行利用多核,多对多模型可以。
- 内核线程由操作系统调度,创建和切换成本通常更高,但可以直接利用多核。
3.2 三种线程模型
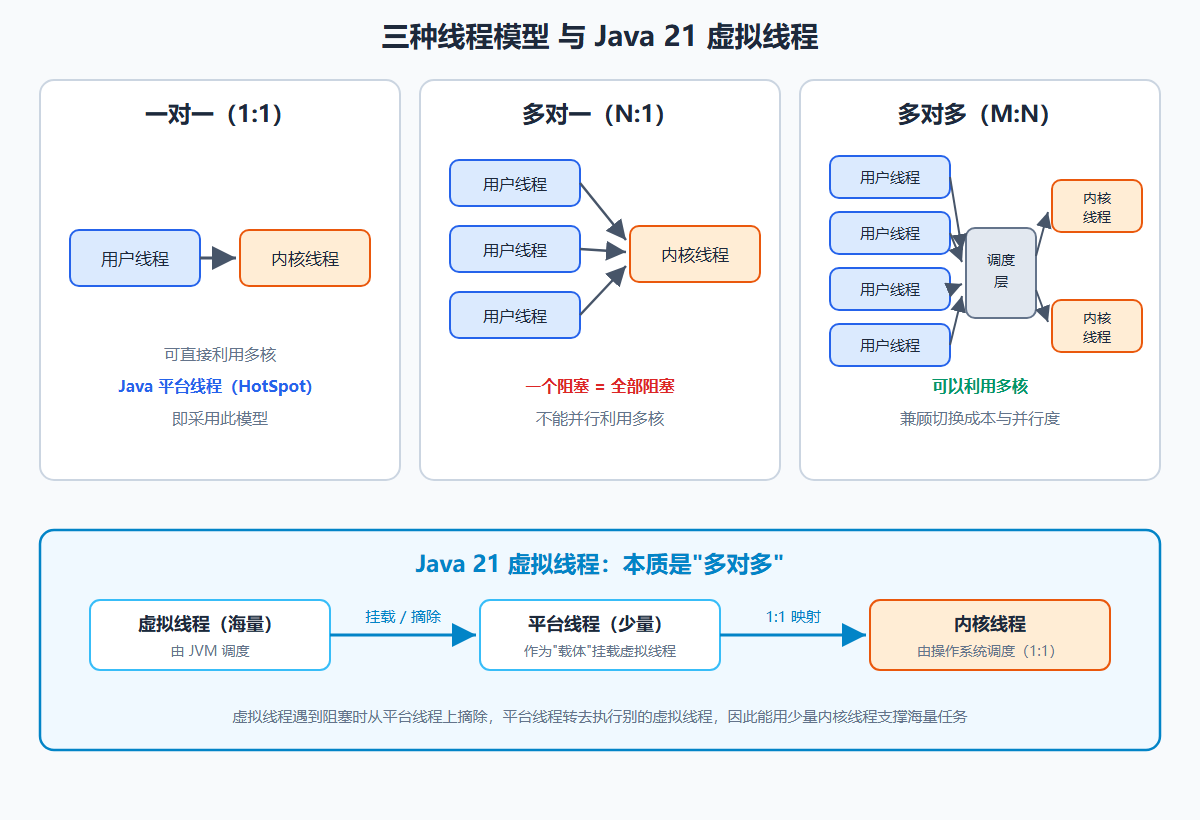
线程模型,就是"用户线程"与"内核线程"之间的关联方式,常见有三种:
- 一对一:一个用户线程对应一个内核线程;
- 多对一:多个用户线程映射到一个内核线程(不能并行利用多核);
- 多对多:多个用户线程映射到多个内核线程(可以利用多核)。
3.3 Java 的选择:平台线程一对一,虚拟线程多对多
Java 线程与操作系统线程的关系,一句话概括:
平台线程通常映射到操作系统线程,而虚拟线程由 JVM 调度并挂载到平台线程上执行。
具体来说:
- 早期 JDK 曾用绿色线程(Green Threads)实现用户级线程——由 JVM 自己在用户空间管理和调度、不绑定内核线程,这种方式后来被废弃;
- 后来通过
new Thread()创建的传统线程,在 HotSpot 中采用平台线程(Platform Thread)实现。平台线程是什么?说白了:它就是操作系统线程在 Java 侧的"包装壳"——你在 Java 代码里new Thread().start(),JVM 底层就调用操作系统 API 真正创建一个内核线程,两者一一绑定,之后的调度完全交给操作系统。所以它看起来像"用户线程"(Thread 对象在你自己的内存里),实际调度却发生在内核。在 Windows、Linux 等主流系统上,它以一对一(1:1)方式映射到操作系统线程; - Java 21 正式引入的虚拟线程(Virtual Thread)由 JVM 调度,大量虚拟线程可以复用少量平台线程作为载体——这才是真正意义上的"用户级线程",因此不能再把"所有 Java 线程"都等同于操作系统线程。
所以"Java 是一对一"这个说法,只对平台线程成立;虚拟线程走的是多对多——很多虚拟线程,挂载到少量平台线程上,由 JVM 自己调度,而不是简单地一对一对齐内核线程。
3.4 虚拟线程解决的是什么问题
传统平台线程是 1:1 映射内核线程的,所以:
- "一个线程占一个内核线程",线程数量受限于系统资源,动辄上千就吃力;
- 阻塞式 IO 时,线程连同它占用的内核线程一起被挂起,白白占着资源。
虚拟线程的思路是:把它和内核线程解耦。海量虚拟线程由 JVM 调度,只有在真正执行时才"挂载"到少量平台线程上;一旦遇到阻塞,JVM 就把它从平台线程上摘下来,让平台线程去跑别的虚拟线程。于是可以用极少的平台线程,撑起几十万级的阻塞任务。
这也是它最适合 IO 密集型场景(大量阻塞等待)的原因——先明白它"是什么、怎么工作",再看它"为什么被引入",就好理解多了。
四、并发 vs 并行、同步 vs 异步
在往下讲"为什么要用多线程"之前,得先把两组最基础的词定义清楚,不然后面全是空谈。
4.1 并发与并行
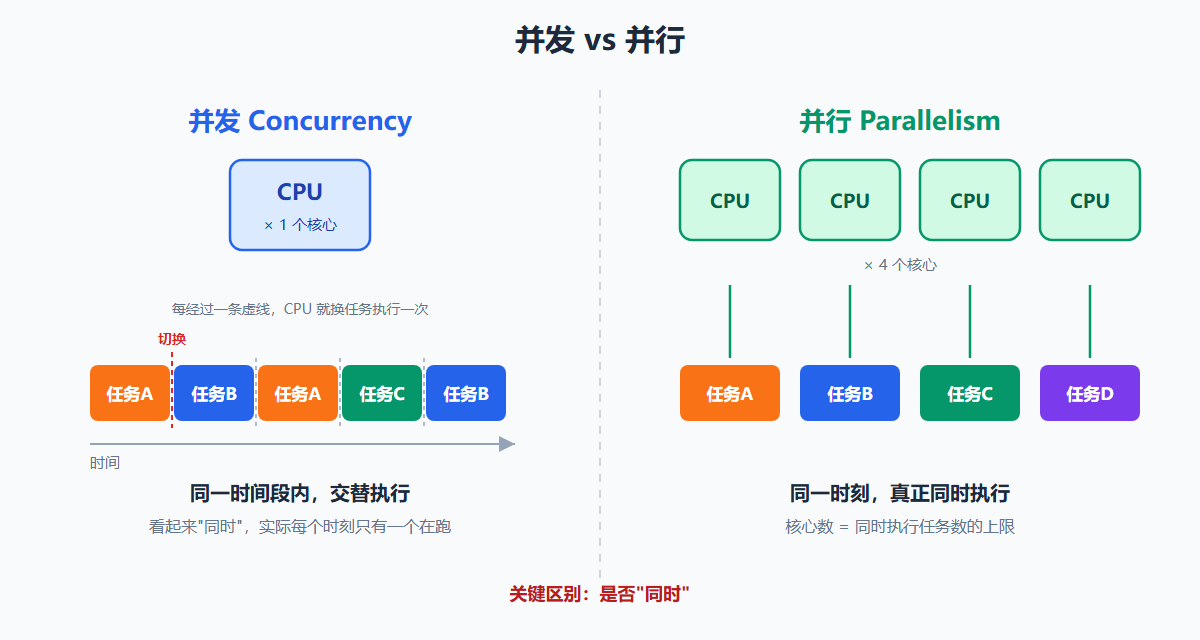
- 并发(Concurrency):两个及以上的作业在同一时间段内执行。
- 并行(Parallelism):两个及以上的作业在同一时刻执行。
区别的关键在于是否同时:
- 并行与 CPU 核心数有关——几个核心,最多就能同时运行几个线程,是真正的"同一时刻执行"。
- 并发则是"一个核心反复切换线程"——比如正在跑线程 1,方法还没结束就发生线程切换,换到线程 2 执行。
所以:并行是同一时刻执行,并发是同一时间段内执行,这就是最大的区别。
4.2 同步与异步
- 同步:发出一个调用后,在没有得到结果之前,该调用不能返回,一直等待。
- 异步:调用发出后,不等返回结果,直接返回。
两个贴近实际的例子:
- 同步:用 MyBatis 去查数据库,就是典型的同步——必须阻塞等待数据库返回结果,当前主流用法并不支持真正的异步读取。
- 异步:最经典的是消息队列。异步发送消息时,发送后就立刻结束,并不关心消息是否已经到达 Broker;同时注册一个回调函数,等持久化结果回来时,再根据成功或失败去更新对应状态。
提醒一个容易混的点:这里的"同步"指的是"同步/异步调用";而后面讲锁时会出现的"同步",指的是"互斥同步"。两者中文都叫"同步",含义完全不同。
五、为什么要用多线程
5.1 宏观:为什么整体"并发能力"能提升
先不如陷进某个细节,从两层来看:
从计算机底层看:
- 线程可以看作轻量级的进程,是程序执行的最小单位,线程间的切换和调度成本远小于进程;
- 多核 CPU 时代,多个线程可以真正同时运行,减少了线程上下文切换带来的开销。
从当代互联网趋势看:
- 现在的系统动不动就要求百万级、千万级的并发量,多线程并发编程正是开发高并发系统的基础。
那为什么用好多线程,"整体并发能力"就能提升?本质是两点:
- 让等待和计算重叠。单线程下一旦卡在 IO 等待,CPU 只能空转;多线程下,一个线程在等 IO 时,别的线程可以继续占用 CPU,系统资源不被浪费。
- 让多个核心同时干活。多核机器上单线程永远只能用一个核,多线程才能把其余核心真正用起来。
这两点叠加,单位时间内系统"能处理的请求数"就上去了,也就是并发能力提升。
5.2 单核时代:解决 CPU 与 IO 的矛盾
在单核时代,多线程(本质是并发)主要是为了提高单进程对 CPU 和 IO 的利用效率。
假设只运行一个 Java 进程、且进程里只有一个线程:当我们去请求 IO 时,这个线程被 IO 阻塞,于是整个进程都被阻塞。此时 CPU 和 IO 设备里只有一个在运行,可以简单认为此时系统整体利用率只有 50%。而用了多线程之后,一个线程被 IO 阻塞,另一个线程还能继续用 CPU,于是整体资源的利用效率就上去了。
5.3 多核时代:为了把多核用起来
多核时代,多线程主要是为了提高进程利用多核 CPU 的能力。
举例:我们要计算一个复杂的任务,里面有很多本来可以并列的子任务。如果只有一个线程,那么无论系统有几个 CPU 核心,都只会有一个核心被用到,任务只能串行执行。而创建多个线程后,这些线程可以被映射到底层多个 CPU 核心上执行——在多个线程之间没有资源竞争的情况下,执行效率会显著提高,约等于:
1 | 多线程耗时 ≈ 单核串行耗时 / CPU 核心数 |
5.4 单核 CPU 支持多线程吗?一定更快吗?
支持。 单核 CPU 通过时间片轮转,把 CPU 时间分给不同线程。虽然单核一次只能执行一个任务,但通过快速在多个线程间切换,可以让用户"感觉"多个任务在同时进行——这就是并发的直观体现。
但效率不一定更高,要看任务类型:
- IO 密集型:主要是读写文件、网络通信这类需要等待 IO 设备响应的任务。这类任务用多线程效率提升明显——等待 IO 的时候 CPU 是空闲的,正好去跑别的任务。就像做面:煮开水的时候可以同时备菜,等水开了再下锅,等待水开的这段时间厨师(CPU)并不闲着。
- CPU 密集型:主要是计算和逻辑处理,需要长时间占用 CPU。这类任务如果用多线程,反而会多出线程上下文切换的开销,越切越慢。
5.5 抢占式调度 vs 协同式调度
操作系统主要用两种方式管理多线程执行:
- 抢占式调度(Preemptive Scheduling):由操作系统决定何时暂停当前线程并切到另一个线程。切换通常由系统时钟中断(时间片轮转)或高优先级事件(如 IO 完成)触发。有上下文切换开销,但公平性和 CPU 利用率较好、不易阻塞。
- 协同式调度(Cooperative Scheduling):线程执行完毕后,主动通知系统切换。能减少切换开销,但公平性差、容易阻塞。
Java 采用的是抢占式调度:JVM 本身不负责线程调度,而是把调度委托给操作系统。操作系统通常基于线程优先级和时间片来调度,高优先级线程获得 CPU 时间片的机会更多。
六、线程的生命周期与状态
6.1 Java 线程的六种状态
Java 线程在生命周期中的任一时刻,只可能处于以下 6 种状态之一:
- NEW:初始状态,线程被创建出来,但还没有调用
start()。 - RUNNABLE:运行状态,线程调用了
start()、等待运行时的状态。 - BLOCKED:阻塞状态,需要等待锁释放。
- WAITING:等待状态,表示该线程需要等待其他线程做出特定动作(通知或中断)。
- TIMED_WAITING:超时等待状态,可在指定时间后自行返回,而不像 WAITING 那样一直等。
- TERMINATED:终止状态,表示线程已运行完毕。
线程在生命周期中并不固定在某一状态,而是随代码执行在不同状态间切换。
6.2 状态是怎么来回切换的
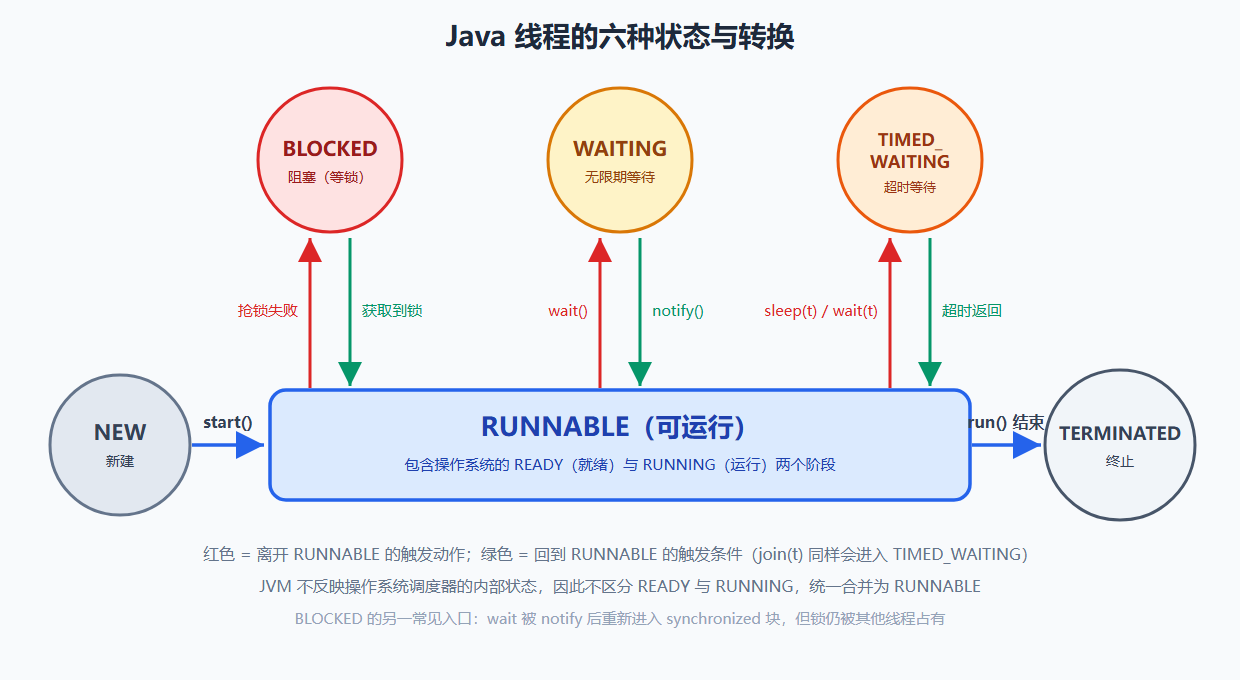
- 线程创建后处于 NEW;调用
start()后进入 RUNNABLE(可运行); - 执行
wait()后进入 WAITING,需要其他线程通知才能回到运行状态; - 带超时的等待,比如
sleep(millis)或wait(millis),进入 TIMED_WAITING,超时结束后回到 RUNNABLE; - 当线程进入
synchronized方法/块,或wait被notify后重新进入synchronized、但锁被别的线程占有时,进入 BLOCKED; - 执行完
run()方法后,进入 TERMINATED。
下表把"动作 → 状态"对应起来,方便记忆:
| 触发动作 | 进入的状态 | 如何离开 |
|---|---|---|
| 创建线程 | NEW | start() |
调用 start() |
RUNNABLE | 被调度或被阻塞 |
synchronized 抢锁失败 |
BLOCKED | 拿到锁 → RUNNABLE |
Object.wait() |
WAITING | notify()/notifyAll() → 重新抢锁 |
Thread.sleep(t) / wait(t) |
TIMED_WAITING | 超时到 → RUNNABLE |
run() 执行完毕 |
TERMINATED | 终态 |
6.3 为什么 Java 不区分"就绪"和"运行"
在操作系统层面,线程有 READY(就绪)和 RUNNING(运行)两种状态;但在 JVM 层面,我们只能看到 RUNNABLE——Java 把这两个状态统称为 RUNNABLE。
原因在于:Java 的 Thread.State 描述的是 JVM 层面的状态,它并不负责反映操作系统调度器的全部内部状态。对 Java 来说,调用 start() 之后,它已经把"启动线程"的通知交给了系统,接下来线程什么时候真正被调度、等待多久、时间片多长,都是操作系统的事。具体的调度策略、时间片长度、是否轮转,都由操作系统及其配置决定,JVM 无法也不该替它概括。
七、线程上下文切换
线程在执行过程中有自己的"运行条件和状态",也就是所谓的上下文,比如前面讲的 PC、栈信息等。当出现以下情况时,线程会从"占用 CPU"的状态中退出:
- 主动让出 CPU,比如调用了
sleep()、wait()等; - 时间片用完,操作系统要防止某个线程长时间占用 CPU 导致其他线程饿死;
- 调用了阻塞类型的系统中断,比如请求 IO 被阻塞;
- 被终止或结束运行。
其中前三种都会发生线程切换。所谓线程切换,就是:
- 保存当前线程的上下文,留待它下次占用 CPU 时恢复现场;
- 加载下一个将要占用 CPU 的线程的上下文。
这一存一取,就是上下文切换。
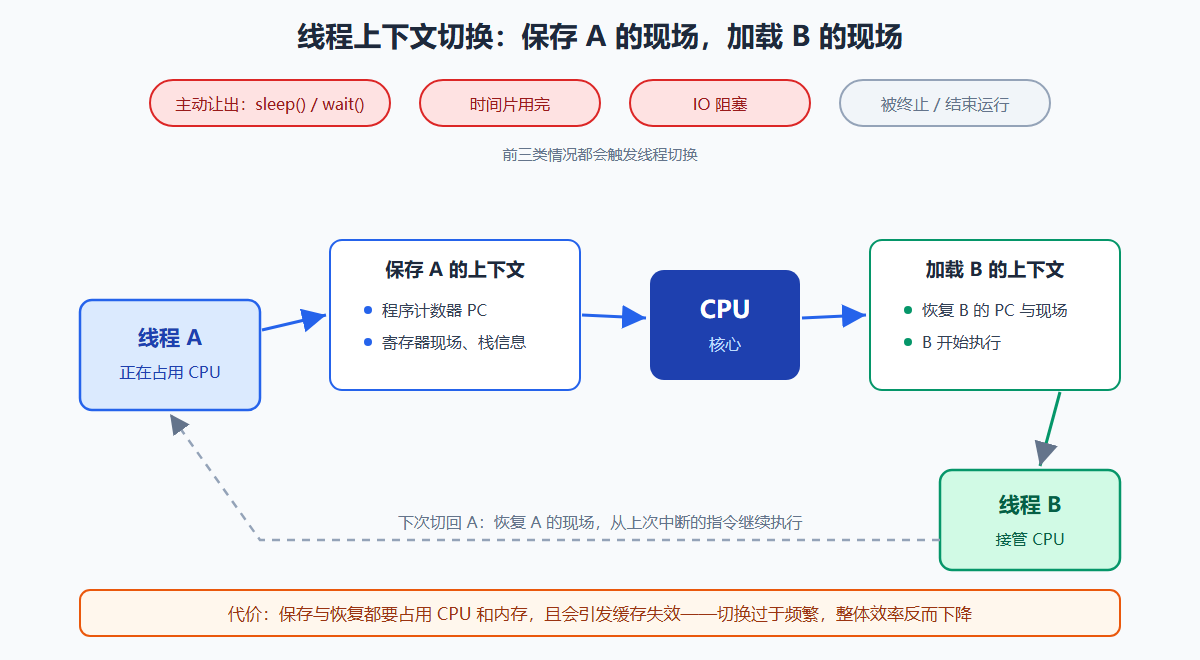
上下文切换是现代操作系统的基本功能。因为它每次都要保存信息、恢复信息,这些动作会占用 CPU、内存等资源,所以一定会有效率损耗——如果切换过于频繁,整体效率反而会明显下降。这也是 5.4 里"CPU 密集型任务多线程反而更慢"的根本原因。
八、sleep vs wait、run vs start
8.1 Thread#sleep() 与 Object#wait() 对比
共同点:两者都能暂停线程的执行。
区别:
sleep()不释放锁,而wait()会释放锁;wait()通常用于线程间交互/通信,sleep()通常用于暂停执行;wait()被调用后线程不会自动苏醒,需要别的线程调用同一个对象上的notify()或notifyAll();sleep()执行完成后线程会自动苏醒,wait(long timeout)超时后也会自动苏醒;sleep()是Thread类的静态本地方法,wait()则是Object类的本地方法。
8.2 为什么 wait() 不定义在 Thread 中?
wait() 是让"获得对象锁的线程"进入等待,并且会自动释放当前线程占有的对象锁。每个对象(Object)都拥有对象锁,既然要操作的是"对象锁",自然要定义在对象上,而不是定义在"线程"上。
类比着问:为什么 sleep() 定义在 Thread 中? 因为 sleep() 只是让当前线程暂停执行,不涉及对象类,也不需要获得对象锁——所以它属于线程自己。
8.3 可以直接调用 Thread 类的 run() 方法吗?
这是非常经典的一道题,start() 和 run() 的区别一定要弄清楚。
new一个Thread,线程进入新建(NEW)状态;- 调用
start()时,JVM 会启动一个新线程并让它进入就绪状态,分配到时间片后就执行run()方法的内容——这才是真正的多线程工作; - 而如果直接执行
run(),那么run()就只是被当成一个普通方法,在"调用它的那个线程"里执行——这并不产生多线程,就是当前线程串行地跑了一遍方法体。
用一个例子对比就清楚了:
1 | public class StartVsRun { |
总结:调用 start() 才能启动线程并进入就绪状态;直接调用 run(),不会以多线程方式执行。
九、多线程带来的问题
多线程带来了性能,也带来了麻烦。常见的有三类:内存泄漏、线程不安全、死锁。
9.1 线程安全与线程不安全
- 线程安全:不管有多少个线程同时访问,都能保证这份数据的正确性和一致性。
- 线程不安全:可能出现数据错乱甚至丢失。
最典型的不安全场景就发生在堆上——堆是同类线程共享的。当多个线程并发地"读—改—写"同一个共享变量时,就可能出现时间窗口,导致结果出错。
一个最直观的例子是共享计数器:
1 | public class LostUpdate { |
两个线程各加 10000 次,期望结果是 20000,实际往往小于 20000。原因就是 count++ 实际分成"读取 → 加一 → 写回"三步。若两个线程都读到了同一个旧值,各自加一后写回,就会有一次更新被覆盖丢失。
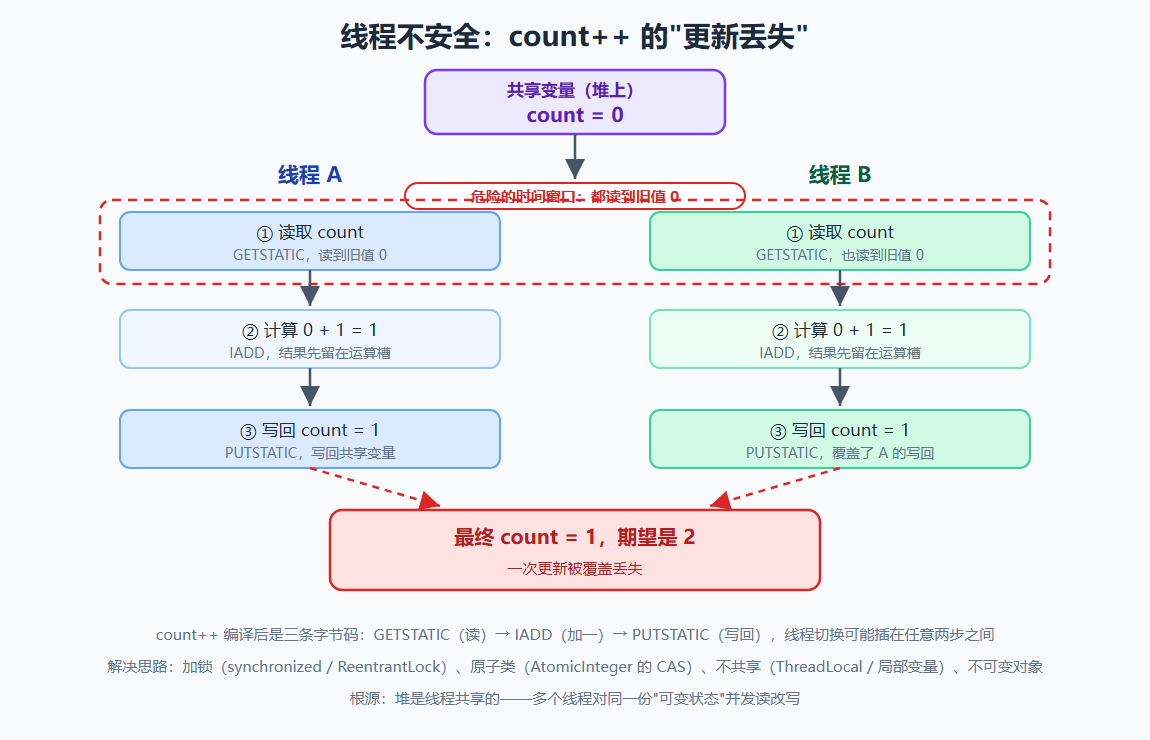
从更底层看,线程不安全可以归结为三个根源,每个根源都得先看"内部是怎么执行的":
- 原子性:
count++在源码里是一行,编译成字节码却是三条指令——GETSTATIC(把 count 读进运算槽)→IADD(加一)→PUTSTATIC(写回)。CPU 随时可能在任意两条指令之间切走线程,切回来时世界可能已经变了。所谓"不具备原子性",不是说它不执行,而是这三步可以被别的线程插队。 - 可见性:线程并不每次都老老实实去主内存读变量——CPU 核心有自己的高速缓存,JMM 把它抽象成"每个线程各持有一份共享变量的工作内存拷贝"。线程 A 改了 count,可能只更新到自己那份拷贝/缓存,还没刷回主内存;此时线程 B 去读,读到的仍是旧值——A 的修改对 B "不可见"。
- 有序性:编译器和 CPU 为了优化会重排指令,它们只保证"在单个线程内看结果不变"。可一旦跨线程,别的线程观察到的顺序就可能和源码写的不一样。典型例子是
new对象的三步——分配内存 → 初始化 → 把引用赋给变量——若被重排成"分配 → 赋引用 → 初始化",另一个线程就可能拿到一个还没初始化完的半成品对象。
对应的常见解决思路有:
- 加锁:
synchronized或ReentrantLock,把"读—改—写"整体变成互斥的; - CAS / 原子类:用
AtomicInteger这类基于 CAS 的原子类,避免显式加锁; - 不共享:把变量改为局部变量,或使用
ThreadLocal,从根上避开共享; - 不可变:使用不可变对象,从设计上杜绝被修改。
9.2 内存泄漏:多半是 ThreadLocal 惹的祸
内存泄漏指的是:对象已经不再被业务使用,却仍然被引用,无法被 GC 回收,导致内存占用持续增长。
在多线程场景下,最典型的内存泄漏来源是 ThreadLocal。它内部的 ThreadLocalMap 里:
- key 是对
ThreadLocal的弱引用; - value 是强引用。
这里的坑在于:如果 ThreadLocal 对象被回收了,而线程还活着(尤其是线程池里线程长期存活),那么 value 就失去了 key 的对应,却还被线程强引用着无法回收——于是泄漏。
更麻烦的是,在线程池里线程是复用的,如果这次用完不清理,下一个任务就可能读到上一个任务残留的数据,造成数据串场。所以既是内存泄漏,也是数据污染。
正确做法很简单但必须做:用完 ThreadLocal 一定要 remove(),并放进 finally。
1 | private static final ThreadLocal<User> CTX = new ThreadLocal<>(); |
9.3 死锁
什么是线程死锁? 死锁描述的是:多个线程同时被阻塞,其中一个或全部都在等待某个资源被释放。由于被无限期阻塞,程序无法正常终止。
经典的死锁形态:线程 A 持有资源 1、等待资源 2;线程 B 持有资源 2、等待资源 1——两者互不相让,等待链形成闭环。
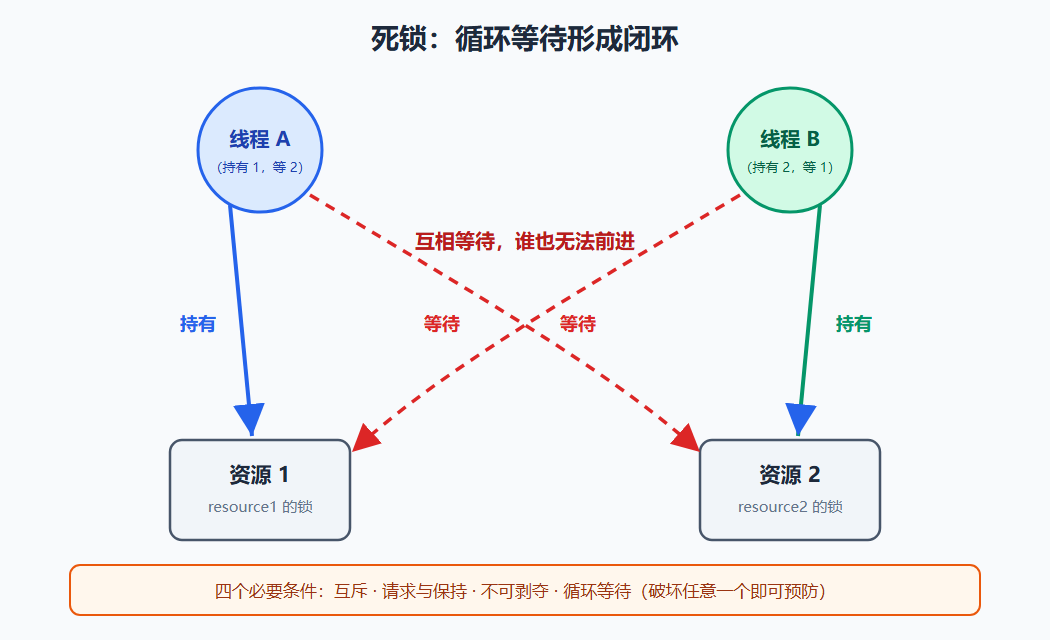
下面这段代码就模拟了上面的死锁:
1 | public class DeadLockDemo { |
线程 1 先拿到 resource1 的监视器锁,sleep(1000) 是为了让线程 2 先拿到 resource2。等两者都睡醒、又都想请求对方的资源时,就陷入互相等待——死锁产生。
这段代码符合产生死锁的四个必要条件:
- 互斥条件:资源在任意时刻只能被一个线程占用;
- 请求与保持条件:一个线程因请求资源而阻塞时,对已获得的资源保持不放;
- 不剥夺条件:线程已获得的资源,在未使用完之前不能被强行剥夺,只有自己用完才释放;
- 循环等待条件:若干线程之间形成一种头尾相接的循环等待资源关系。
如何检测死锁?
- 用
jstack <pid>或jcmd <pid> Thread.print -l查看线程栈和锁信息,若检测到 Java 级死锁,输出中会列出相关线程及其持有、等待的锁(jmap主要看堆,不是死锁诊断工具); - 用 VisualVM、JConsole 等工具排查——打开 JConsole 连接目标程序,进入"线程"界面点"检测死锁"即可。
如何预防和避免?
预防的思路是"破坏四个必要条件",比如:
- 破坏请求与保持:一次性申请所有资源;
- 破坏不剥夺:占用部分资源的线程再去申请其他资源时,若申请不到,就主动释放已占有的资源;
- 破坏循环等待:按某一固定顺序申请资源,释放时按反序释放。
避免死锁则是在资源分配时借助算法(如银行家算法)计算评估,使系统处于安全状态——即存在一个推进顺序 <P1, P2, …, Pn>,能依次为每个线程分配所需资源,直到它们都能顺利完成。
对上面的例子,只要把线程 2 也改成"先申请 resource1、再申请 resource2",打破循环等待,死锁就解除了:
1 | new Thread(() -> { |
此时两个线程都按"先 1 后 2"的顺序申请锁,不会再形成循环等待。
十、总结
把全文收成一条线:
- 地基:进程是资源分配的最小单位,线程是 CPU 调度的最小单位;线程借进程的资源,只保留自己的执行现场(PC、虚拟机栈、本地方法栈)。
- 为什么私有:因为多线程会反复切换,私有的执行现场让线程切回来时能准确恢复。
- 连接处:Java 平台线程 1:1 映射操作系统线程;虚拟线程则多对多,由 JVM 调度、复用少量平台线程。
- 收益:多线程让"等待与计算重叠、多核同时干活",从而提升系统并发能力;但单核上是否更快,取决于任务类型(IO 密集 vs CPU 密集)。
- 代价:共享带来线程不安全,切换带来性能损耗,加锁又可能带来死锁。
一句话记住:理解"共享可变状态 + 调度切换"这两件事,就拿到了理解一切并发问题的钥匙。