Hot 100 --- 单词拆分
本文概览:本文讲解单词拆分的核心思路:dp[i] 表示 s 的前 i 个字符能否拆成字典单词,枚举切割点 j,dp[j] 且 [j,i) 是单词则 dp[i] 为 true,从暴力 DFS 优化到 O(n²) 的 DP 判定
一、题目
二、题目分析
1. 题目要求
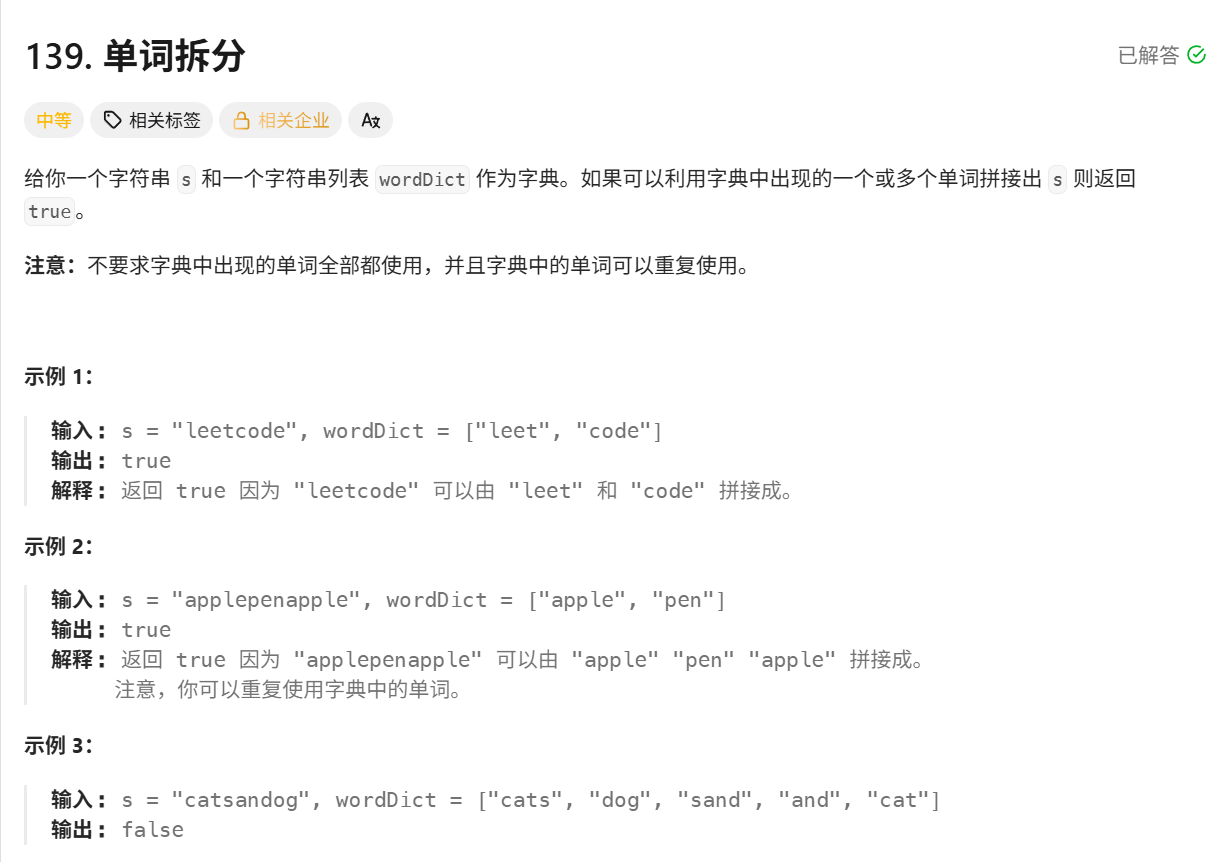
给你一个字符串 s 和一个字符串列表 wordDict 作为字典。如果可以利用字典中出现的一个或多个单词拼接出 s 则返回 true。
注意:不要求字典中的单词全部都使用,并且字典中的单词可以重复使用。
示例 1:s = "leetcode",wordDict = ["leet", "code"] → true(leet + code)
示例 2:s = "applepenapple",wordDict = ["apple", "pen"] → true(apple + pen + apple,apple 被重复使用)
示例 3:s = "catsandog",wordDict = ["cats", "dog", "sand", "and", "cat"] → false
1 | cats + and + ? → "og" 不是单词 ✗ |
2. 这题的几个关键点
第一:单词可以复用。示例 2 里 apple 出现了两次,用一次之后还能再用。这决定了字典要用 HashSet 存,查完不删。
第二:示例 3 揭示的陷阱。字典里有多个相似单词(cat 和 cats、and 和 sand),前缀对上了不代表能切下去。比如 "catsand..." 开头既可能是 cat 也可能是 cats,你根本不知道该切哪个。如果切错了,后面就走不通,但切之前看不出来。
第三:遍历每个字符是必然的,问题是怎么知道在哪里切割出一个单词。
3. 暴力思路的问题
最暴力的思路:从头开始,枚举每一个可能的单词切法,遇到一个字典里存在的单词就从这里往下继续 for 递归,走不通就回头换一个切法(DFS 回溯)。
问题:代码很难写,而且同一个前缀的失败会被反复验证。比如 "catsandog","cat" 切法失败后回溯,"cats" 切法走到 "andog" 时,"and" 后面的 "og" 又要从头验证一遍;换 "sand" 切法时 "og" 再验证一遍。切法的组合是指数级的,时间复杂度会超级大。
核心浪费:"og 能不能拆成单词"这个问题的答案,跟它是从哪条路走过来的完全无关,但暴力法把它算了无数遍。
4. 需要解决哪几个问题?
问题一:怎么记录"前面某段已经成功了"这个状态,让它不被反复计算?
问题二:状态之间怎么衔接?已知前面的状态,怎么推出当前的状态?
三、思路概览
1 | public boolean wordBreak(String s, List<String> wordDict) { |
思路简要说明:
- 状态定义:
dp[i]表示 s 的前 i 个字符(即 s[0..i))能否被字典单词拼出 - 转移方程:外层枚举结束位置 i,内层枚举切割点 j;如果
dp[j]为 true(前 j 个字符已拼出)且s.substring(j, i)是字典单词(第 j 到第 i-1 个字符是一个完整单词),则dp[i] = true - 初始条件:
dp[0] = true(空前缀,什么都不用拼,天然成立) - 答案:
dp[s.length()] - **时间复杂度 O(n²)**,空间 O(n)
四、思路详解
第一步:换个看法,从"数单词"到"数字符"
暴力法难写、难想的根源是以单词为单位往前推进:cat 还是 cats?切错就回溯。
换个角度,以字符为单位往前走,用示例 2 的 "applepenapple" 感受一下:
1 | a p p l e p e n a p p l e |
发现了吗:**"走到第 i 个字符时,前 i 个字符能不能拼出来"是一个确定的、只和 i 有关的状态**。它一旦是 true,不管后面怎么接、前面是怎么拼成的(一个词还是十个词),都不影响后续使用。无后效性,天然的 DP 结构。
第二步:解决状态定义
dp[i] 表示 s 的前 i 个字符(s[0..i))能否被字典单词拼出,boolean 型。
为什么定义成"前 i 个字符"而不是"从某处到 i"? 因为拼接是从左往右顺次进行的,任何合法的完整拆分,都可以看成"某个成功的前缀 + 紧跟其后的一个单词"。前缀状态只需一个下标就能定位,这是最省的刻画。
答案就是 dp[s.length()]。
第三步:解决转移方程
推导:前 i 个字符能拼出,意味着什么?意味着存在一个切割点 j,把前 i 个字符分成两段:
- 前段 s[0..j):它的成败由
dp[j]记录 - 后段 s[j..i):要求它正好是一个字典单词
1 | a p p l e p e n |
两段都成立,dp[i] 就是 true。写成代码:
1 | if (dp[j] && set.contains(s.substring(j, i))) dp[i] = true; |
j 是不知道的,所以从 0 到 i-1 全部枚举一遍,任何一个 j 成立就够(break 跳出)。
回看示例 3 为什么返回 false:"catsandog" 的每个 i 都找不到合法的 j:
1 | i=3 "cat" :dp[0]=true 且 "cat" 是单词 → dp[3]=true |
cat 和 cats 两个都试,不需要纠结切哪个,这就是枚举切割点对"相似单词陷阱"的化解。而 dp[8]、dp[9] 的失败被记录下来后,如果字符串后面还有内容,直接查 dp 就行,不会再被反复验证(对应暴力法回溯时 "og" 被反复检查的浪费)。
第四步:初始条件为什么是 dp[0] = true?
dp[0] 表示空前缀。一个字符都不用拼,空串天然"拼得出",所以是 true。
它不是随口设的,是转移的起点:算 dp[3]("cat")时 j=0 这条路走的就是 dp[0] && "cat" 是单词。dp[0] 若是 false,所有 i 的 j=0 分支全部死掉,整条链推不动。
对比一下:它和完全平方数的 dp[0] = 0(和为 0 用 0 个数)、零钱兑换的 dp[0] = 0(金额 0 用 0 枚硬币)是同一个角色,**"规模为零时问题平凡成立"**。
第五步:代码细节
字典存成 HashSet:contains 是 O(1)(算上 substring 的哈希开销是 O(单词长度))。如果用 List 存,每次 contains 都要线性扫整个字典,总复杂度会多乘一个字典大小。
substring(j, i) 的边界:左闭右开,正好取出第 j 到第 i-1 个字符,和"dp[j] 管前 j 个字符"的下标体系无缝对齐。dp 数组开 s.length() + 1,多出的那一格就是 dp[0]。
内层 break:dp[i] 是 boolean,找到一个成立的 j 就够了,再扫下去没有意义,直接跳出省时间。
枚举方向:j 从 0 往 i-1 走。也可以倒着从 i-1 往 0 走(先试短前缀还是长前缀),对本题的复杂度和正确性没有影响,只是命中成功 j 的早晚不同。
完整执行过程
以 s = "applepenapple",wordDict = ["apple", "pen"] 为例:
1 | 初始:dp = [true, false, false, ..., false](长度 13+1 = 14) |
dp 数组里 true 的位置(0、5、8、13)正好是每个成功切点的"落点",一眼能看出 apple / pen / apple 的拼接轨迹。
复杂度分析
时间复杂度 O(n²)(n 为 s 的长度):外层 i 走 n 个状态,内层 j 每次最多扫 i 个切割点。其中每次 substring + contains 的哈希开销正比于单词长度,最坏整体是 O(n³) 字符级操作,但状态数是 n² 级。对比暴力回溯的指数级,核心收益是每个前缀的成败只算一次。
**空间复杂度 O(n)**:dp 数组 + 字典集合。
五、总结
单词拆分的核心思路:
- 两个关键点:单词可复用(HashSet 查完不删);相似单词的切割陷阱(cat/cats 不知道切哪个)
- 化解陷阱的手法:不选边,枚举所有切割点,让成立的那个自己浮出来
- 状态定义:
dp[i]= 前 i 个字符能否拼出,boolean 型 - 转移方程:
dp[j] && set.contains(s.substring(j, i))则dp[i] = true - 初始条件:
dp[0] = true(空前缀平凡成立,一切转移的起点)
和前面枚举类 DP 的关系:完全平方数、零钱兑换枚举的是"最后一步选什么候选",这题枚举的是"最后一个单词从哪里切起"。都是站在 i 往回看、把前半段当子问题已知;差别只是这题的子问题答案是 boolean(能不能),不是数值(最少几个),转移从 min 变成了逻辑与。
暴力到 DP 的通用转化信号:当发现"某个中间结果的答案与来路无关,却被反复计算"(比如这题的 "og 能不能拆"),就说明可以把它抽成状态、记进 dp 数组,回溯的指数树就被压成了填表。