Hot 100 --- 最长公共子序列
本文概览:本文讲解最长公共子序列的核心思路:盯着两个字符串各自的最后一个字符,相等就接在前缀最优解后面加 1,不等就看丢掉任意一边哪种更长取较大者;方法一是二维 DP 表,方法二只保留上一行用一维数组把空间降到 O(n)。重点讲清转移方程为什么是这样,而不是只贴公式。
一、题目
二、题目分析
1. 题目要求
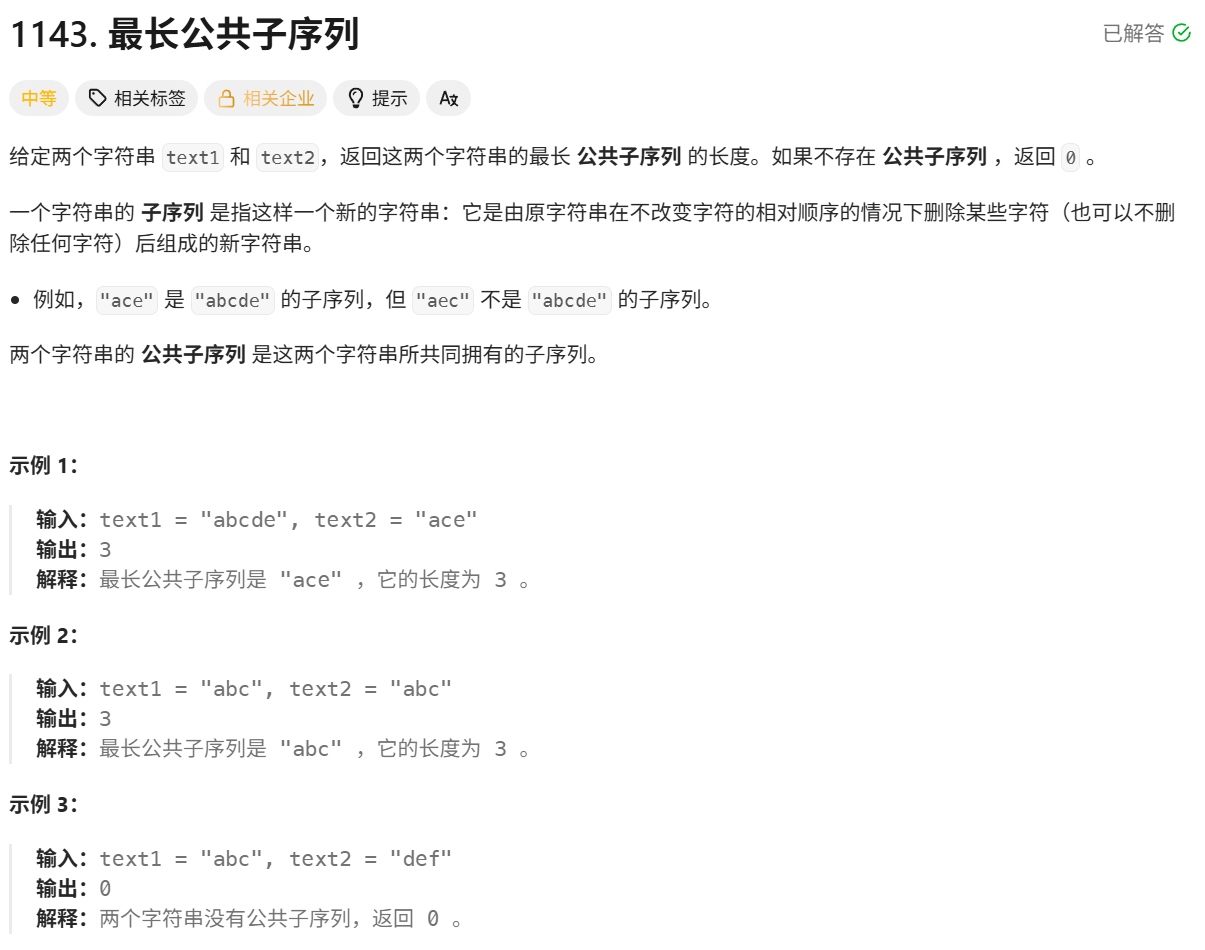
给定两个字符串 text1 和 text2,返回这两个字符串的最长公共子序列(LCS,Longest Common Subsequence)的长度。如果不存在公共子序列,返回 0。
子序列:从字符串中删除某些(也可以不删除)字符,但不改变剩余字符的顺序。例如 "ace" 是 "abcde" 的子序列,而 "aec" 不是。
示例 1:text1 = "abcde", text2 = "ace" → 3("ace")
示例 2:text1 = "abc", text2 = "def" → 0
示例 3:text1 = "abc", text2 = "abc" → 3
2. 怎么想这题?
先把题目翻译成人话:在 text1 和 text2 里各挑一串字符出来,这两串字符按各自原来的顺序、能一个对一个地对上,问最长能挑多长。注意对比一下"子串":子串必须连续,而这里挑出来的字符中间可以隔着别的字符跳过,只要顺序不颠倒就行。示例 1 里 "abcde" 中的 "ace",跳过了 b 和 d,但顺序对得上,所以它是合法的公共子序列。
第一步:自己手动比对,看答案是怎么找出来的
先别急着写代码,自己拿着两个串手动比一遍。用 text1 = "abc"、text2 = "cef"。
要把两个串的共同字符找出来,只能一个字符一个字符地比:
1 | text1 的 a,去和 text2 的每个字符比:c、e、f,都不是 a → a 淘汰 |
text1 走完,最后得到的公共子序列就是 "c",长度 1。
这里没有捷径:text1 的每一个字符,都得和 text2 的字符逐个比过,才知道它配不配得上。比一遍下来,两个串的字符会两两碰面一次,像一张表:
1 | text2 |
表里 - 表示这两个字符配不上,* 表示配上了。a、b 两行整行都是 -,说明它俩和 text2 里任何字符都对不上,全被淘汰;只有 c 行在 text2 的第一个字符上打出了 *。
关键的地方来了:这一遍遍比下来,我们手里始终捏着两个"进度"——text1 比到第几个字符了、text2 比到第几个字符了。上面那张表里,一行就是 text1 的一个进度,一列就是 text2 的一个进度,两个进度交在一起,就唯一确定了"现在比到哪儿、前面已经配出了多长"。
所以这道题的状态就是这两个进度:(i, j) 表示 text1 看到第 i 个字符、text2 看到第 j 个字符时的局面(这里的 i、j 都是从 1 开始数,第 i 个字符在代码里是下标 i-1)。
第二步:复杂度天生就是 O(n x m),关键是怎么别重复算
刚才那张碰面表就是这件事的缩影:text1 有 n 个字符、text2 有 m 个字符,两两碰面就是 n x m 种 (i, j) 组合。天真的做法是:每问一个 (i, j) 能配多长,就从头把两个串再比一遍——可同一个局面会被反复从头推很多次,纯属白费。
真正的做法是把每个局面算出来的结果记下来:某个进度上"最长能配多长"一旦算过,以后要用就直接查,不用再比一遍。这样每个 (i, j) 只算一次,一共 n x m 个局面,效率就省出来了。这也正是动态规划的做法——算过的就存住。所以接下来只剩一件事:给定一个 (i, j),怎么用已经记下来的、比它更靠前的局面,把它的值推出来。
第三步:从后往前看,(i, j) 的值怎么算?
想知道进度走到 (i, j) 时最长能配多长,就去看公共子序列的最后一个字符落在哪。此刻手里最新的两个字符,一个是 text1 的第 i 个,一个是 text2 的第 j 个,所以最后一个字符无非两种情况:
情况一:最后一个字符正好就是这一对。 前提是这个字符得两串里都有,也就是这两个字符必须先相等。相等时这一对可以充当公共子序列的收尾,把这一对去掉,前面那部分就是"进度走到 (i-1, j-1) 时配出的公共子序列"。于是
1 | (i, j) 的最长长度 = (i-1, j-1) 的最长长度 + 1 |
情况二:最后一个字符不是这一对。 要么这两个字符不相等,要么虽然相等但没用它。不管哪种,这一对里至少有一个字符没参与进来,最长长度就只能去更靠前的局面里找。
往哪儿找、怎么保证不漏,就是下面思路详解要补上的部分。这里先记住这条主线:每一步都盯着"最后一位配不配得上",配得上就接在上一个进度的长度后面加 1,配不上就往更前面退。
3. 需要解决哪几个问题?
问题一:状态怎么定义?dp[i][j] 到底表示"哪两个串"之间的公共子序列?
问题二(核心):转移方程为什么那样写?为什么两个字符串的末尾字符相等时可以直接接上去 +1,不相等时取两边的 max 就覆盖了所有可能?这背后"盯着最后一个字符"的思路是什么?
问题三:初值怎么填?空字符串怎么处理?
三、方法一:二维 DP,O(m x n) 空间
1. 思路概览
1 | public int longestCommonSubsequence(String text1, String text2) { |
思路简要说明:
- 状态定义:
dp[i][j]表示text1[0..i-1]和text2[0..j-1]的最长公共子序列长度(即前i个字符对前j个字符) - 转移分两支:末尾字符相等 →
dp[i-1][j-1] + 1;不等 →max(dp[i-1][j], dp[i][j-1]) - 初值:
dp[0][*] = dp[*][0] = 0(空串与任何串无公共字符) - 时间复杂度 O(m x n),空间 O(m x n)
2. 思路详解
第一步:解决状态定义——dp[i][j] 是哪两个串?
这是理解整题的钥匙。dp[i][j] 不是拿 text1 和 text2 的"整个串"去比,而是拿它们的前缀去比:
1 | dp[i][j] = text1 的前 i 个字符 与 text2 的前 j 个字符 的最长公共子序列长度 |
之所以这么定义,是因为递推必须以"越比越短"的方式推进。答案 dp[n][m] 正是两个完整字符串的结果——前缀推到尽头就是全串。
第二步:解决转移方程——为什么盯着最后一个字符?
顺着上面"从后往前看最后一位"的主线:进度走到 (i, j) 时,比前面局面多出来的新信息只有两个字符——text1 的第 i 个 text1[i-1],和 text2 的第 j 个 text2[j-1];而它俩之前的局面 (i-1, j-1) 的最优值已经算好了。递推就是在问:这两个新来的字符,能不能作为公共子序列的收尾配成一对? 答案取决于它俩是否相等。
分支一:末尾相等(text1[i-1] == text2[j-1])。
这时这对字符一定能、而且应该被选进最优解。为什么"一定"?用一个反证体会一下:假设最优公共子序列没用上这一对相等的字符,那它整个都落在"text1 前 i-1 个"和"text2 前 j-1 个"的范围里,长度至多 dp[i-1][j-1]。可是既然 text1[i-1] == text2[j-1],把这一对追加到那个解的最后,两个串的顺序都没乱,就得到了长度 dp[i-1][j-1] + 1 的子序列,比原来的还长。这说明"不用这对"不可能是最优,所以最优解必然收下这一对,接在前缀最优值后面:
1 | dp[i][j] = dp[i-1][j-1] + 1 |
分支二:末尾不等(text1[i-1] != text2[j-1])。
末尾这一对配不上,成不了公共子序列的收尾,那这两个字符里最多只能留下一个继续参与。所以最优解必然属于下面两种情况之一:
- 舍弃 text1 的第
i个字符(留着它对不上任何东西),问题退化成 text1 前i-1个 对 text2 前j个 →dp[i-1][j]; - 舍弃 text2 的第
j个字符,问题退化成 text1 前i个 对 text2 前j-1个 →dp[i][j-1]。
为什么两边都得看?只算一边会错在哪? 举个例子。text1 = "abc"、text2 = "ab",进度最后走到 (i = 3, j = 2):text1 末尾是 c、text2 末尾是 b,不相等。
- 舍弃 text1 末尾的
c(它谁都配不上),问题退化成"ab"对"ab"→ 长度 2,正好就是答案"ab"; - 舍弃 text2 末尾的
b(留着c也没用),问题退化成"abc"对"a"→ 长度 1。
如果只看"舍弃 text2 末尾"这一支,就会得到 1,把真正的 2 漏掉。反过来把两个串调换一下(text1 = "ab"、text2 = "abc"),该走的就变成"舍弃 text2 末尾"那一支了。所以两个方向都得算,取更大的那个:
1 | dp[i][j] = max(dp[i-1][j], dp[i][j-1]) |
(两边末尾都不用的情况,会被这两种方案同时覆盖,不影响结果。)
把两步合起来,就是这份转移方程。可以看到,它并不是凭空冒出来的公式,而是"盯着两个字符串各自的末尾字符"这一件事,按相等/不等两种情况自然推导出来的。比较两个字往往只要盯着末端想,别想着从头到尾捋一遍——这是这题最核心的直觉。
第三步:解决初值——空串怎么办?
dp[0][j]:text1 一个字符都不取(空串),和 text2 不存在任何公共子序列,恒 0。同理 dp[i][0] 恒 0。Java 数组默认初始化为 0,所以连显式赋值都不用,直接让循环从 i=1, j=1 开始即可。
第四步:完整执行过程
以示例 1,text1 = "abcde"、text2 = "ace"(答案是 3)为例。表里 dp[i][j] 用"text1 前 i 个 x text2 前 j 个"来标:
1 | text2 |
一步步看:
1 | i=1 (text1[0]='a'): |
注意 'b' 和 'd' 两个字符从头到尾都在复制上一行的 1 和 2——它们没有贡献任何新的匹配,只靠 max 把已有最优值"传递"了下来。这正好呼应转移方程里"不等取 max"那一支:一个用不上的字符,最优解就把它丢掉,长度不降。
3. 复杂度分析
时间复杂度 O(m x n):两层循环,每个格子常数次比较。
空间复杂度 O(m x n):完整二维表。
四、二维表里其实只用到"上一行"
回到转移方程,dp[i][j] 只依赖三个"邻居"。把表按行列摆好,i 是行、j 是列,它们的位置关系是:
1 | 列 j-1 列 j |
对照着看这三个依赖:
dp[i-1][j]:同一列、上一行 → 正上方dp[i][j-1]:同一行、上一列 → 正左方dp[i-1][j-1]:上一行、上一列 → 左上方(对角线)
也就是说,算第 i 行的时候,用到的是上一行(第 i-1 行)的整行,加上当前行刚算好的左边一个值。第 i-2 行及其更早的行,从此再也不会被用到。这和之前《不同路径》滚动的道理一样——把"上一行"和"当前行"挤进同一个一维数组,边算边原地覆盖,就能从 O(m x n) 省到 O(n)。
但这题比《不同路径》多一个坑:它要看对角线 dp[i-1][j-1]。滚动时这一格特别容易被先覆盖掉,得单独把它救下来。下面看怎么处理。
五、方法二:一维滚动数组,O(n) 空间
1. 思路概览
1 | public int longestCommonSubsequence(String text1, String text2) { |
思路简要说明:
- 状态定义:
dp[j]表示当前行第j列的值,随 i 行逐行滚动 - 核心难点是对角线:
dp[i-1][j-1]会在算dp[j-1]时就被覆盖,所以用prev提前存下它 - 转移:匹配用
prev+1;不匹配用旧dp[j](上方)和dp[j-1](左方)取 max - 时间复杂度 O(m x n),空间 O(n)
2. 思路详解
第一步:每次滚动前,dp[] 里装的是什么?
进入第 i 行遍历时,dp[j] 还留着上一行(i-1 行)第 j 列的值 dp[i-1][j]。我们要在遍历 j 的过程中,把它逐一改成本行的值 dp[i][j]。改完的这一行,正好就是下一行要用的"上一行"。
第二步:为什么必须用 prev 救对角线?
这是整份代码最关键的地方。回想转移方程,匹配分支要读 dp[i-1][j-1]——上一行、上一列的值。
但在滚动数组里,dp[j-1] 在前一个 j 的迭代里已经被覆盖成本行的值 dp[i][j-1] 了。也就是说,走到 j 这一步时,"对角线" dp[i-1][j-1] 在数组里已经找不到了——它被 dp[i][j-1] 顶掉了。
所以要在覆盖发生前,把对角线旧值留下来。看 j-1 那一步:dp[j-1] 覆盖前,它装的是 dp[i-1][j-1]。于是我们在 j-1 更新前记下它(temp),进入 j 时它就是 prev。循环里正是:
1 | int temp = dp[j]; // 这是 dp[i-1][j] |
一句话:prev 装的是"上一行、上一列"dp[i-1][j-1],专门喂给匹配分支,因为它在数组里被左方新值覆盖前必须被救下来。 这和之前《乘积最大子数组》里 tempMax、《不同路径(一维)》里"别让旧值提前被覆盖"是同一个问题的两种装法——都是"算新值要用旧值,旧值却在原地被覆盖"。
第三步:完整执行过程
延续示例 1(text1 = "abcde",text2 = "ace",m=3)。初始 dp = [0, 0, 0, 0]:
1 | i=1 (text1[0]='a'),prev=0: |
看 i=3 的 j=2 和 i=5 的 j=3 两处匹配:都用的是 prev(对角线旧值 1 和 2),加 1 得到 2 和 3。如果不用 prev 而去读已经被覆盖的 dp[j-1],就会用错值,2 和 3 都算不出来。对比方法一的二维表,每一行结束时 dp[] 的内容正好等于二维表里那一行,滚到最后就是完整答案。
dp[0] 从头到尾都是 0 不参与内层循环(j 从 1 开始),它正好对应"text1 前 i 个 x 空字符串 = 0"这条边界。
3. 复杂度分析
时间复杂度 O(m x n):循环规模没变。
空间复杂度 O(m):只留一行,从 O(m x n) 降到 O(m)。想让 m 取较小字符串长度可进一步减空间(两层循环里让内层对齐较短串)。
六、总结
| 维度 | 方法一 二维 DP | 方法二 一维滚动 |
|---|---|---|
| 状态 | dp[i][j] 两个前缀 |
dp[j] 只保留当前行 |
| 关键依赖 | 上方、左方、对角线 | 对角线旧值靠 prev 保存 |
| 空间 | O(m x n) | O(m) |
| 时间 | O(m x n) | O(m x n) |
| 难点 | 想通转移方程 | 别让对角线旧值被覆盖 |
解这题真正要跨过的一道坎是理解转移方程,而不是记住公式。整条思路就一句话:盯着两个字符串的最后一个字符。
- 末尾相等 → 这对字符一定进最优解,长度 = 去掉它俩后的最优值 + 1;
- 末尾不等 → 这对字符进不去,最优解要么丢掉前者、要么丢掉后者,取两者更大值。
把这个落成 dp[i][j](两个前缀之间)的递推,再从二维表发现"只用得到上一行",顺手把对角线用 prev 救下来压成一维——空间从 O(m x n) 降到 O(m)。这套"先想透状态与转移,再优化空间"的节奏,也适合后面更复杂的二维 DP 题。