Hot 100 --- 最长递增子序列
本文概览:本文讲解最长递增子序列的核心思路:方法一是 O(n²) 的 DP 枚举(以每个元素结尾的 dp[i]),方法二是 O(n log n) 的二分优化(维护各长度子序列的最小末尾值),从重复组合的浪费中提炼出"保留最小末尾"的剪枝
一、题目
二、题目分析
1. 题目要求
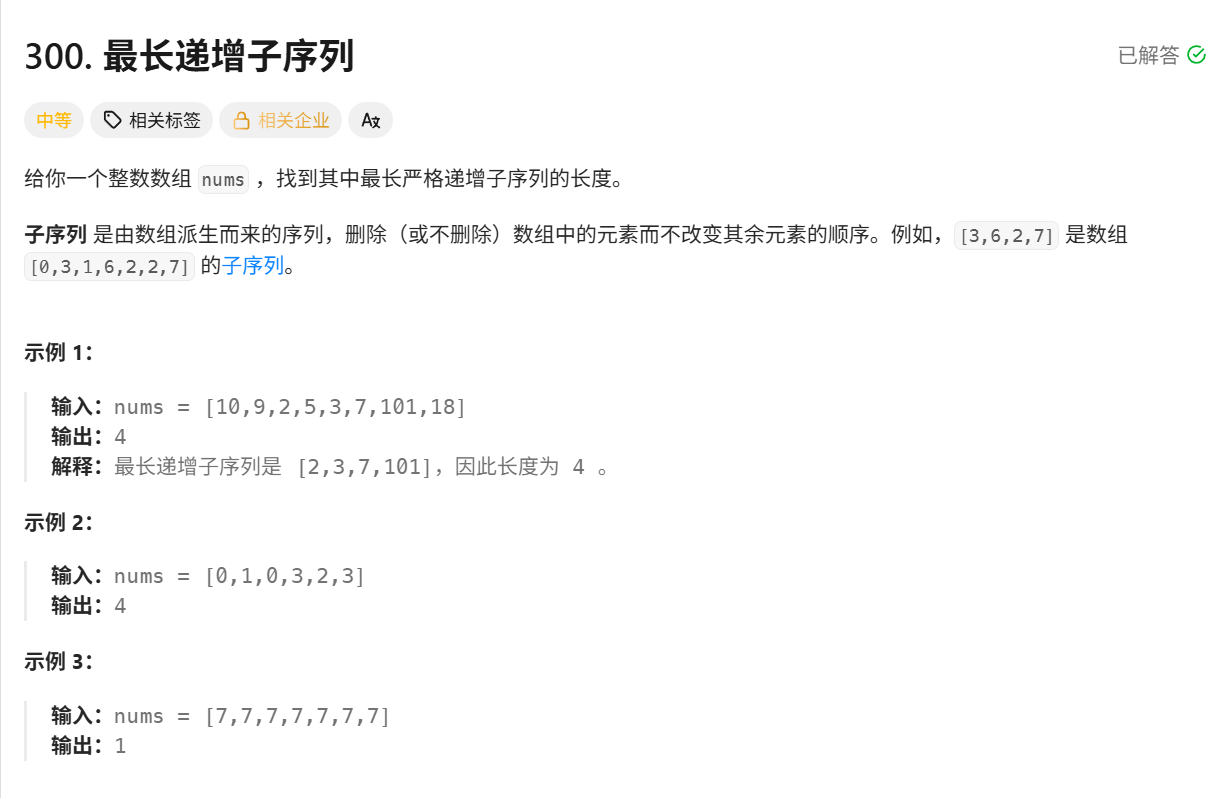
给你一个整数数组 nums,找到其中最长严格递增子序列的长度。
子序列是由数组派生而来的序列,删除(或不删除)数组中的元素而不改变其余元素的顺序。例如 [3,6,2,7] 是 [0,3,1,6,2,2,7] 的子序列。
示例 1:nums = [10, 9, 2, 5, 3, 7, 101, 18] → 4([2,3,7,101])
示例 2:nums = [0, 1, 0, 3, 2, 3] → 4([0,1,2,3])
2. 怎么想这题?
第一步:暴力枚举行不行?
面对"最长递增子序列",第一反应是枚举所有子序列看哪个最长。但动手前先想一想:每个元素只有"选"或"不选"两种状态,n 个元素就是 2ⁿ 种组合——指数级,肯定不行。
那能不能不枚举全部,只挑一些看起来有希望的子序列去试?比如"以 2 开头的递增子序列":
1 | 2, 5, 7, 101, ... |
还没走几步,分支就爆炸了——每到一个新元素都要决定要不要接,但当时看不出接下去能不能走到更长的路。除非把"每条路径未来能走多长"全部算清楚,否则没法剪枝;而这又回到了枚举。
这条路走不通,怎么办?
第二步:能不能只关心长度,不关心子序列本身?
既然完整构造一个子序列做不到,那就只关心长度,不关心具体长什么样。如果有一种方法能算出"以 nums[i] 为结尾能拼出多长",那全数组扫一遍取最大值就是答案——这正是动态规划擅长的路子。
第三步:什么时候可以 DP? 检查三个特征:
- 大问题可拆成子问题:以 nums[i] 结尾的最长长度,看起来和"以前面某个 nums[j] 结尾的最长长度"有关
- 无后效性:只看 nums[i] 的结尾长度,之后怎么算与之无关
- 求最优值:要的是最长长度
三个特征都满足,是 DP。
3. 需要解决哪几个问题?
问题一:状态怎么定义?以谁为结尾的最长长度?
问题二:转移方程怎么写?已知前面某个结尾的最长长度,怎么推出当前值结尾的最长长度?
问题三(进阶):O(n²) 的 DP 有没有优化空间?哪里组合了"没必要的子序列"?
三、方法一:DP 枚举,O(n²)
1 | public int lengthOfLIS(int[] nums) { |
思路简要说明:
- 状态定义:
dp[i]表示以nums[i]为结尾的最长递增子序列长度 - 转移方程:枚举前面所有比
nums[i]小的结尾nums[j],dp[i] = max(dp[i], dp[j] + 1) - 初始条件:
dp[i] = 1(最差就是只包含它自己) - 答案:
res,是所有 dp[i] 的最大值(最长子序列不一定在最后一个位置结束) - **时间复杂度 O(n²)**,空间 O(n)
第一步:解决状态定义——以谁为结尾?
子序列难枚举,是因为一个子序列既要看头也要看尾,还要看中间。但我们只关心最长长度,不关心子序列本身。所以可以这样想:
**枚举每个位置,单独问"以这个位置的元素结尾,能拼出多长的递增子序列"**——把它当成递增子序列的最后一个元素,从前面找一个能拼上来的接上去。
dp[i] 就定义为以 nums[i] 为结尾的最长递增子序列长度。
为什么可以这么定义?因为任何递增子序列都有且仅有一个结尾,把它和那个结尾绑在一起,整个子序列就唯一对应到了一个 dp 值,状态空间被完美切分。
第二步:解决转移方程——往前找一个接得上
思路:nums[i] 作为当前结尾,要拼上一个 nums[i - 1]、nums[i - 2]... 中比它小的元素,才能保持递增。设前面某个 j 满足 nums[j] < nums[i],那以 nums[j] 结尾的最长递增子序列长度是 dp[j],拼上 nums[i] 就是 dp[j] + 1。
j 不确定,从 0 到 i-1 全部枚举一遍,取 max:
1 | dp[i] = max(dp[j] + 1),前提 nums[j] < nums[i] |
初始条件:dp[i] = 1,最差情况就只包含自己一个元素(前面没有能接上的)。
答案为什么不是 dp[n-1]? 因为最长子序列不一定以最后一个元素结尾。比如把示例 2 的 6 个元素再延长一个,比如 nums = [0,1,0,3,2,3,1],最长子序列仍是 [0,1,2,3](长度 4),结尾的 3 在索引 5 而不是末尾 6。所以要遍历所有 dp[i] 取最大值 res。
复杂度:外层 n 个状态,内层最多扫 i 个 j,O(n²)。
第三步:用示例 1 走一遍 DP
nums = [10, 9, 2, 5, 3, 7, 101, 18],答案是 4。
1 | i=0 (10):dp[0]=1,前面没有可接的 |
注意 i=7 时的 [2,3,7,18] 也是 4,验证了"答案不一定在最后一位结束"。
复杂度分析(方法一)
**时间复杂度 O(n²)**:双重循环。
**空间复杂度 O(n)**:dp 数组。
四、引导思考:方法一能优化吗?
O(n²) 能解决问题,但 2000 个元素就是 400 万次比较,百万级元素要上万亿次——能不能更快?
哪里在浪费时间? 我们不引用具体题目,造一段小场景感受一下。假设前面已经出现了这三个长度为 2 的递增子序列:
1 | [1, 2], [1, 3], [2, 4] 长度都是 2,末尾值分别是 2、3、4 |
接下来来了个 5,三条都得接上:
1 | [1,2,5], [1,3,5], [2,4,5] 长度都是 3,末尾都是 5 |
三条完全等价——后续能扩展成什么样只取决于末尾的 5,跟前面具体是 1 还是 2 无关。O(n²) 的 DP 把三条全算了一遍,这是浪费。
再往后看:下一个值是 3。
1 | [1,2,3] ← 新冒出来的长度为 3 的子序列,末尾 3 |
[1,2,3] 比 [1,2,5] "更短但末尾更小"——3 比 5 小。如果后面来了 4、5,能从 [1,2,3] 接出 [1,2,3,4]、[1,2,3,5],但从末尾 5 的子序列一个都接不上(要严格递增,得 >5 才行)。可见 同样的长度里,末尾更小的那条更有可能更长。
关键观察:
- 当未来值大于某条子序列末尾时,能不能接上取决于这个末尾——末尾越小,未来能接上的概率越大,也更有可能更长
- 同一个长度有多条子序列,只需要保留末尾最小的那条——它最有可能继续增长,其他都是被它覆盖的"死路"
按这个思路重新组织状态:能不能用"长度为 i+1 的递增子序列中末尾元素的最小值"代替原来"以 nums[i] 为结尾的最长长度"?这样同一个长度只保留一条最有前途的,多余的全砍掉。
这就是方法二的核心思路。
五、方法二:二分优化,O(n log n)
1 | public int lengthOfLIS(int[] nums) { |
思路简要说明:
- tails[i] 的含义:长度为
i + 1的递增子序列中,末尾元素的最小值 - 遍历 num:二分找到 num 在 tails 里的位置(第一个 ≥ num 的位置),替换;找不到则追加到末尾
- 答案:size(tails 的有效长度 = 最长递增子序列长度)
- **时间复杂度 O(n log n)**:n 次遍历 × 每次二分 O(log n)
第一步:tails 数组的语义和操作
定义 tails[k] = 长度为 k+1 的递增子序列中,末尾元素的最小可能值。例:
1 | 子序列 [2,5,7] → tails[2] = 7 |
关键性质:tails 数组本身是严格递增的(长度更大的子序列,末尾最小值必然更大)。
遍历 nums 里的每个 num:
- 二分找到 tails 里第一个 ≥ num 的位置(即
lower_bound) - 把 num 填进去(替换掉该位置原值;找不到则说明 num 比所有都大,追加到 size 位置,size++)
为什么这样操作是对的?
- num ≥ tails[mid]:num 可以接在长度为 mid+1 的子序列后面,长度升级 → 跳到 mid+1 之后找
- num < tails[mid]:num 太短接不上 mid 长度的(不是递增),但可能作为更短长度的更优末尾 → 把 mid 收下来
- 找到的位置 left 就是"长度 left 的子序列的更优末尾"——把 num 填进去,因为 num < tails[left](原值),所以是"更小末尾"的覆盖
- 找不到(left == size):num 比所有 tails 都大,能接在最长子序列后面形成更长的 → size++
维护单调性的代价:tails 数组始终递增,binary search 走 O(log n)。
第二步:用示例 1 走一遍 tails
nums = [10, 9, 2, 5, 3, 7, 101, 18]
1 | num=10 :tails 空,10 追加 → tails=[10], size=1 |
注意 num=3 那步:tails[1] 原先是 5(对应子序列 [2,5],长度 2),被 num=3 替换后变成 3(对应 [2,3],长度 2)——同长度(2)下,更小的末尾 3 把更大的末尾 5 覆盖掉。如果之后来了 4,能从 [2,3] 接出 [2,3,4],但 [2,5] 接不上(要严格递增,4 ≤ 5 都不行)。这就是 tails 自动丢弃"死路"、保留"活路"的过程。
第三步:完整执行过程(示例 2)
nums = [0, 1, 0, 3, 2, 3],答案是 4。
1 | num=0 :追加 → tails=[0], size=1 |
第四步:代码细节
**right = size 而不是 tails.length**:只在 tails[0..size-1] 里二分,未填充的部分是垃圾数据。
**left + (right - left) / 2**:防 (left + right) / 2 在 left、right 都很大时溢出 int。
**二分条件 tails[mid] < num 用左闭右开 [left, right)**:lower_bound 标准写法,找第一个 ≥ num 的位置;最后 tails[left] 一定 ≥ num(若 left < size)或 left == size(追加)。
**if (left == size) size++**:分两种情况——二分落在 size 位置说明 num 比所有现有尾巴都大,扩展;落在 0..size-1 是替换,size 不变。
数组大小开 nums.length:虽然 size 最多到 n,但开 n 够了,简化代码(也可以开 n 配合 size 收紧边界,思路一样)。
复杂度分析(方法二)
**时间复杂度 O(n log n)**:n 次遍历 + 每次 O(log size) 的二分查找。
**空间复杂度 O(n)**:tails 数组。
优化本质:用 tails[i] 单一变量吸收了 DP 中"同一个长度的多条子序列",把所有保留价值的子序列压成 O(n) 个;二分把"找可接位置"从线性降到对数。
六、总结
最长递增子序列的核心思路:
- 状态定义两版:
- DP 版:
dp[i]= 以 nums[i] 为结尾的最长长度 - 优化版:
tails[k]= 长度为 k+1 的子序列的最小末尾值
- DP 版:
- DP 转移方程:
dp[i] = max(dp[j] + 1),j 满足nums[j] < nums[i] - 优化核心:同一长度多条子序列只留末尾最小的那条——它最有可能继续增长,其他都被覆盖
- tails 操作:二分找"第一个 ≥ num 的位置",替换;找不到则追加,size++
- tails 性质:严格递增 → 保证二分有效 → 保证 lower_bound 逻辑正确
和前面 DP 的关系:
- 这题是"以元素结尾"的经典二维降一维(不需要 i,j 两层下标,只看结尾一个位置)
- DP 给 O(n²),优化方法把"同一长度的多条子序列"压成一个数,进一步降到 O(n log n)
- 优化的本质是贪心:每一步选最优(最小末尾),全局最优由这些局部最优推出
DP 到贪心的转化信号:当发现"某个状态只用保留最有代表性的那个值(比如最小末尾、最大得分、最少消耗)"时,往往就能从 O(n²) 的枚举 DP 优化到 O(n log n) 甚至 O(n)——后者用更精的数据结构(堆、二分、单调栈)替代了"枚举所有候选"的循环。