Hot 100 --- 最长回文子串
本文概览:本文讲解最长回文子串的两种经典思路:方法一是中心拓展,遍历每个字符,以它为中心向两边扩展判断回文,注意中心有两种(奇数长度和偶数长度);方法二是动态规划,判断一段字符串是不是回文只需看首尾字符相等且内部子串是回文,但必须先按长度从小到大递推
一、题目
二、题目分析
1. 题目要求
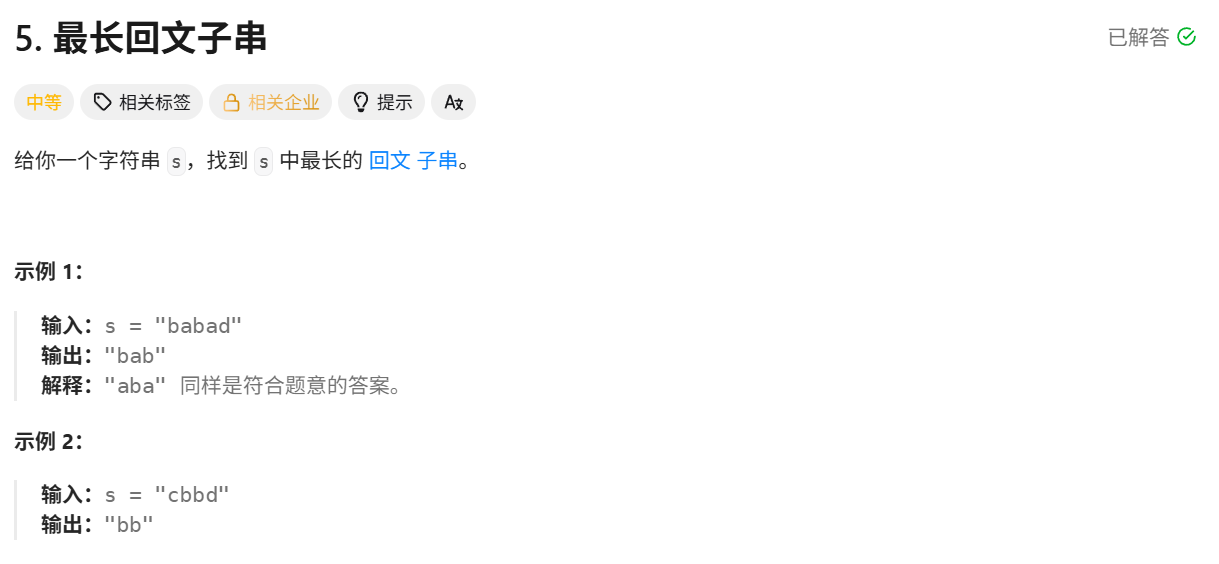
给你一个字符串 s,找到 s 中最长的回文子串。
回文串:正着读和反着读一样的字符串,比如 "aba"、"bb"。
示例 1:s = "babad" → "bab"("aba" 也符合,答案长度相同)
示例 2:s = "cbbd" → "bb"
2. 怎么想这题?
最直接的做法是枚举所有子串:s 有 O(n²) 个子串,每个再判断是不是回文 O(n),总复杂度 O(n³),肯定不行。
回文的本质是什么?正读反读一样,也就是关于中心对称。围绕"对称"这个词,长出了两条路:
- 从中心向外看:以某个位置为中心,向左右两边扩张,两边字符一直相等,就扩出一个回文——中心拓展。
- 从两端向内看:判断一段是不是回文,看它最左和最右的字符是否相等,同时内部那一小段是不是回文——递归定义,动态规划。
两条路都能解,但各有各的坑。中心拓展的坑在"中心到底有几种";动态规划的坑在"必须先算长度短的,顺序错了满盘皆输"。
3. 需要解决哪几个问题?
问题一:怎么把"关于中心对称"变成一个可以计算的流程?从中心向外扩展时,怎么判定、怎么记下长度?
问题二:中心一定是一个字符吗?偶数长度的回文,它的中心在哪?
问题三(DP 视角):判断 s[i..j] 是不是回文,能不能拆成更小的子问题?拆出来之后,计算顺序有什么要求?
三、方法一:中心拓展,O(n²)
1. 思路概览
1 | class Solution { |
思路简要说明:
- 遍历每个位置当中心:对每个
i,分别按"奇数中心"和"偶数中心"各扩一次 - expand 向外扩张:左右指针相等就继续扩,停住时
right - left - 1就是回文长度 - 记录答案:
start = i - (len - 1) / 2反推出回文起点 - **时间复杂度 O(n²)**,空间 O(1)
2. 思路详解
第一步:解决问题一——怎么从中心向外判定回文?
回文关于中心对称,所以从中心出发,同时向左、向右各看一眼:两个字符相等,就说明当前这一圈是对称的,回文还没到头,继续往外扩;一旦发现不等,或者撞到字符串边界,就停。
1 | private int expand(String s, int left, int right) { |
为什么返回 right - left - 1?循环退出时,left 和 right 已经多走了一步——它们停在了"不相等"或"越界"的位置。真正属于回文的部分是 (left+1) 到 (right-1),长度 = (right-1) - (left+1) + 1 = right - left - 1。
比如 "aba",中心 i=1,扩到 left=-1, right=3 时停,3 - (-1) - 1 = 3,正好是 "aba" 的长度。
第二步:解决问题二——中心为什么有两种?
这是最容易出错的地方。回文长度是奇数时,中心是单个字符;长度是偶数时,中心是相邻的两个字符之间的空隙。
- 奇数回文
"aba":中心是b,从(i, i)开始扩。 - 偶数回文
"abba":中心是b|b中间那道缝,要从(i, i+1)开始扩。
一个位置 i 同时是这两种中心的候选——奇数回文的中心是它本身,偶数回文的中心是它和右边相邻字符之间的空隙——所以每个 i 都要试两次:
1 | int len1 = expand(s, i, i); // 奇数中心,比如 "aba" |
漏掉其中任何一种,就会漏掉对应奇偶性的回文。比如示例 2 的 "bb",只有偶数中心能扩出来。
第三步:拿到长度后,起点怎么反推?
expand 只返回长度,不返回起点。有了中心下标 i 和长度 len,回文的起点是:
1 | start = i - (len - 1) / 2 |
验证一下:"bab"(奇数,中心 i=1,len=3)→ 1 - (3-1)/2 = 0 ✓;"bb"(偶数,中心是 (0,1) 之间的空隙,i=0,len=2)→ 0 - (2-1)/2 = 0 ✓。整数除法天然让奇数、偶数两种情况都对。
第四步:完整执行过程
以 s = "babad" 为例:
1 | i=0 ('b'): |
i=1 时扩出长度 3,i=2 时也扩出长度 3("aba"),但 len > maxLen 要求严格大于,所以保留先找到的 "bab"。
3. 复杂度分析
**时间复杂度 O(n²)**:n 个位置,每个位置最多两类中心,每类最坏向外扩 O(n)。
**空间复杂度 O(1)**:只有几个变量。
四、引导思考:换个方向看回文
中心拓展是从中心往两端看:以对称轴为起点向外扩。
能不能反过来,从两端往中心看?判断一段 s[i..j] 是不是回文,不需要先找中心——最左和最右的字符必须相等,同时中间那段 s[i+1..j-1] 也得是回文:
1 | s[i..j] 是回文 ⟺ s[i] == s[j] 且 s[i+1..j-1] 是回文 |
这就把"长串是不是回文"拆成了"短串是不是回文",大问题由小问题决定——动态规划的标志。
但这里藏着一个关键差异:递推关系是长度减 2,不是减 1。想判断长度 4 的串,得先知道长度 2 的;想判断长度 3 的,得先知道长度 1 的。所以计算顺序有讲究,不能像前面几题那样随便按位置扫。
五、方法二:动态规划,O(n²)
1. 思路概览
1 | class Solution { |
思路简要说明:
- 状态定义:
dp[i][j]表示s[i..j]是不是回文串 - 转移方程:
s[i] == s[j]且内部dp[i+1][j-1]为 true,则dp[i][j] = true - 边界:长度为 1 全 true;长度为 2 时首尾相等即 true(内部为空)
- 遍历顺序:外层枚举长度(短到长),内层枚举起点——这是关键,顺序反了会读到没算过的值
- **时间复杂度 O(n²)**,空间 O(n²)
2. 思路详解
第一步:解决状态定义——dp[i][j] 表示什么?
用二维布尔表,dp[i][j] = true 表示子串 s[i..j] 是回文。只存"是或不是",不用存内容。答案就藏在所有为 true 的区间里最长的那段。
第二步:解决转移方程——首尾夹逼怎么拆?
引导思考给的递推式直接翻译:
1 | dp[i][j] = true 当且仅当 s[i] == s[j] 且 dp[i+1][j-1] == true |
两个边界情况要单独处理:
- 长度 1:
s[i..i]只有一个字符,天然回文,初始化时全置 true。 - 长度 2:首尾相等就是回文(
"aa")。这时内部是空串,dp[i+1][j-1] = dp[i+1][i]是"左端大于右端"的无效区间,不能去读,所以单独写dp[i][j] = true。
代码里就是 if (len == 2) 那个分支。
第三步:为什么必须按长度从小到大,而不是按起点扫?
这是本方法最容易错的地方。dp[i][j] 依赖 dp[i+1][j-1],而 dp[i+1][j-1] 比 dp[i][j] 短 2 个字符。
如果外层按起点 i 枚举(i 从 0 到 n,内层 j 从 i+1 到 n),算 dp[0][3](长度 4)时,它需要的 dp[1][2](长度 2)要等到 i = 1 那一轮才算出来——还没算好,读到的就是 false,答案错。
只有外层按长度枚举才能保证:算长度 len 的串时,所有长度 < len 的串(尤其是 len-2)都已经算完了。所以两层循环的写法是固定的:
1 | for (int len = 2; len <= n; len++) { // 外层:长度,从短到长 |
第四步:完整执行过程
以 s = "babad" 为例(下标 0~4:b a b a d):
1 | 初始化:dp[i][i] 全 true;maxLen = 1 |
注意 (1,3)(即 "aba")也是回文,长度同为 3,但因为要求 len > maxLen 严格大于,保留先找到的 "bab"。
第五步:代码细节
n < 2提前返回:长度为 0 或 1 时直接返回s,省去下面整段逻辑。dp[i][i] = true初始化:长度为 1 的区间单独铺底,主循环从len = 2开始。start/maxLen只在len > maxLen时更新:保证存的是"最长",长度相同不覆盖,拿第一个。len == 2分支的原因:如上所述,内部区间不存在,不能读dp[i+1][j-1]。
3. 复杂度分析
**时间复杂度 O(n²)**:两层循环各枚举 O(n²) 个区间。
**空间复杂度 O(n²)**:二维布尔表。
六、总结
| 维度 | 方法一 中心拓展 | 方法二 动态规划 |
|---|---|---|
| 视角 | 从中心向外扩 | 从两端向内夹逼 |
| 判断依据 | 中心两侧字符逐对相等 | 首尾相等 且 内部是回文 |
| 中心/边界 | 两种中心(奇数/偶数) | 长度 1、2 单独处理 |
| 计算顺序 | 按位置扫即可 | 必须按长度从短到长 |
| 空间 | O(1) | O(n²) |
| 时间 | O(n²) | O(n²) |
两种方法都是围绕"回文关于中心对称"这一个性质展开的,区别只在观察方向:
- 中心拓展从里往外看,好处是天然不需要额外的判断结构,缺点是每个位置要处理两种中心。
- 动态规划从外往里看,把回文判断变成递推,思路更系统,代价是要管长度顺序,还要付 O(n²) 的空间。
面试时两种都值得掌握:中心拓展代码短、好记;DP 则是一类"区间 DP"的样板,后面遇到"最长回文子序列"之类的题,思路是同一套。