动态规划入门
本文概览:本文讲解动态规划入门:动态规划是解决什么问题的、这类型问题的特征、状态定义与状态转移方程等通用概念,并用斐波那契、爬楼梯、杨辉三角三个例题从暴力递归一步步演进到 DP 表格
一、什么是动态规划?
1. 动态规划是用来解决什么问题的?
动态规划(Dynamic Programming,简称 DP)是用来解决一类大问题可以拆成小问题的方法。
这类问题有一个共同的身影:要求解 n 规模的答案,必须先知道 n-1(或更小)规模的答案。比如:
- 求第 n 个斐波那契数,需要先知道第 n-1 和第 n-2 个
- 爬到第 n 阶楼梯的方法数,需要先知道爬到第 n-1 阶和第 n-2 阶的方法数
- 生成杨辉三角的第 i 行,需要先生成第 i-1 行
只要问题能这样一层层往下拆,拆到最小规模时答案又显而易见,就具备了用动态规划求解的资格。
2. 这类型问题一般有什么特征?
特征一:子问题重叠
拆出来的小问题会被反复用到。这里先说明一下记号:fib(5) 表示"第 5 个斐波那契数",fib(3) 表示"第 3 个斐波那契数"。
比如要求 fib(5),按定义 fib(5) = fib(4) + fib(3),要用到 fib(3);而求 fib(4) 时,fib(4) = fib(3) + fib(2),又要用到 fib(3)——同一个子问题在不同的计算路径里反复出现。如果每次都重新算,就是大量的重复计算(这也是后面"为什么需要动态规划"的根源)。
特征二:无后效性
一旦当前状态确定了,之后的过程就和"怎么到达这个状态"无关了。
比如爬楼梯:只要我知道"你在第 3 阶",那么从这里爬到楼顶的方法数就定了——你是 1+2 上来的还是 2+1 上来的、中途休息了几次,统统不影响后续。这个特征保证了我们只需要记录"状态"(在第几阶),不需要记录"路径"(怎么来的),问题才能被压缩成一个数组。
特征三:最优子结构(求最优解类的问题才有)
大问题的最优解由小问题的最优解构成。比如"爬到第 n 阶的最少花费" = 两条来路(n-1 阶、n-2 阶)里花费较小的那条加上当前花费。
3. 解这类问题的通用框架:三个关键要素
先说明一下记号:dp 这个名字就是 dynamic programming(动态规划)的缩写,它本质上就是一个普通数组,dp[i] 表示这个数组的第 i 格。我们解题的过程,就是想清楚"这个数组的每一格装什么、怎么一格一格填出来"。
不管具体的题目是什么,动态规划的解题框架永远是这三步:
- 状态定义:确定
dp[i](或dp[i][j])表示什么(即数组的第 i 格装什么) - 状态转移方程:确定
dp[i]怎么由更小的状态推导出来(即第 i 格怎么由前面填好的格子算出来) - 初始条件(边界):确定最小规模时答案是什么(转移方程推不出来的那部分,要手动给定)
这三个要素每个都是什么意思?光说概念很抽象,下面用最经典的斐波那契数列逐个说明。
4. 用斐波那契数列理解三个要素
斐波那契数列的定义:
1 | f(0) = 0, f(1) = 1 |
要素一:状态定义
状态定义回答的问题是:**dp[i] 这个格子装什么?**
对斐波那契:dp[i] 表示第 i 个斐波那契数。
dp[0] = 0,dp[1] = 1,dp[2] = 1,dp[3] = 2...
状态定义的本质,是给"子问题"起一个名字、编一个号。定义好了,"求解第 n 个斐波那契数"这个大问题,就变成了"求 dp[n]",而它的子问题天然就是 dp[n-1]、dp[n-2],以此类推。
要素二:状态转移方程
状态转移方程回答的问题是:**dp[i] 怎么由前面的小状态算出来?**
对斐波那契,定义里直接给了:
1 | dp[i] = dp[i-1] + dp[i-2] |
即:第 i 个数 = 前一个数 + 前两个数。
比如 dp[5] = dp[4] + dp[3] = 3 + 2 = 5。
状态转移方程是动态规划的灵魂,它描述了"大问题和小问题之间的推导关系"。有了它,任意规模的答案都可以从更小规模的答案推出来,一层层推到初始条件为止。
(斐波那契的转移方程是题目直接给的;后面例题里,转移方程需要我们从题意中分析推导出来,那才是做题的难点,也是本文例题的重点。)
要素三:初始条件
初始条件回答的问题是:最小的那几个状态是什么?
对斐波那契:dp[0] = 0,dp[1] = 1。
为什么必须要它?注意转移方程 dp[i] = dp[i-1] + dp[i-2] 在 i=1 时会用到 dp[-1],在 i=0 时会用到 dp[-2]——越界了,推不出来。转移方程只能从 i=2 开始生效,所以 i=0 和 i=1 的答案必须手动给定,作为整条推导链的起点。
就像多米诺骨牌:转移方程是"推倒的规则",初始条件是"第一张牌"。没有第一张牌,后面全倒不下去。
三要素合在一起,就是完整的解法:
1 | dp[0] = 0 ← 初始条件 |
二、为什么需要动态规划?
上面的推导方式看起来很自然,但一般人拿到斐波那契,第一反应是递归。我们就从这个最直觉的写法出发,看看它会遇到什么问题,一步步演变出动态规划。
1. 第一步:暴力递归——最直觉的写法
递归直接照着定义翻译:要求 f(n),就先求 f(n-1) 和 f(n-2),加起来。
1 | public int fib(int n) { |
代码很短,逻辑也对。但把它跑在大 n 上会慢得离谱。为什么?画出 fib(5) 的递归树看看:
1 | fib(5) |
数一数:fib(3) 被算了 2 次,fib(2) 被算了 3 次,fib(1) 被算了 5 次。
而且规模越大越夸张——n 每加 1,这棵树的规模几乎翻倍,时间复杂度是**指数级 O(2ⁿ)**。算 fib(50) 就要数十亿次计算。
问题的根源:这正是前面说的"子问题重叠"特征。fib(3) 在 fib(5) 的两条不同路径下被各算了一遍,每次都是从头算的,谁也不知道别人已经算过。
2. 第二步:记忆化搜索——算过的存起来
既然重复计算是病根,那治法就显而易见:准备一个本子(缓存),算过的子问题记下来,下次先查本子,查到就不重算。
1 | public int fib(int n) { |
对比暴力版,只加了两行代码,但效果天差地别:
fib(3)第一次算完就记在memo[3]里,第二次直接查表返回- 每个子问题只真正计算一次,时间复杂度从 O(2ⁿ) 降到 O(n)
- 递归树从"指数级爆炸"变成了"一条主链 + 查表"
这就是"记忆化搜索"。它和暴力递归的思路完全一样(都是自顶向下,从 fib(n) 往 fib(1) 拆),只是多了个缓存。
3. 第三步:动态规划——把递归"拍平"成递推
记忆化搜索已经很快了,但还有两个别扭的地方:
- 递归有栈开销:n 很大时,递归深度是 O(n),可能栈溢出
- 执行顺序不直观:到底先算哪个、后算哪个,全由递归调用栈隐式控制,我们说了不算
再观察一下:记忆化搜索绕了一大圈(从 n 递归到 1,再一层层返回),但真正干活的顺序其实是从 fib(1)、fib(2) 一路算到 fib(n)。既然如此,为什么要绕递归这个弯路?直接从小到大递推不就行了——把递归"拍平",改成循环:
1 | public int fib(int n) { |
这就是动态规划的标准形态:自底向上,从初始条件出发,按转移方程一格一格往上填表,填到 dp[n] 就是答案。
回头看,第一部分讲的"三要素"在这段代码里一一对应:dp[0]/dp[1] 是初始条件,dp[i] = dp[i-1] + dp[i-2] 是转移方程,循环顺序就是计算顺序。
4. 第四步:空间优化——只留必要的状态
再挑剔一点:填表过程中,dp[i] 只依赖 dp[i-1] 和 dp[i-2] 这两个格子,更早的格子(dp[i-3]、dp[i-4]...)用完就废了。那整张表根本不用存,两个滚动变量就够:
1 | public int fib(int n) { |
空间复杂度从 O(n) 降到 **O(1)**。
5. 演进全景
1 | 暴力递归 O(2ⁿ)时间 子问题重叠,重复计算 |
动态规划不是凭空掉下来的思想,而是"递归 + 缓存 + 调转方向"一步步演进出来的。理解了这个演进,后面看到任何 DP 题,都知道它本质上是一个"被拍平且加了缓存的递归"。
三、例题一:爬楼梯
1. 题目
2. 题目分析
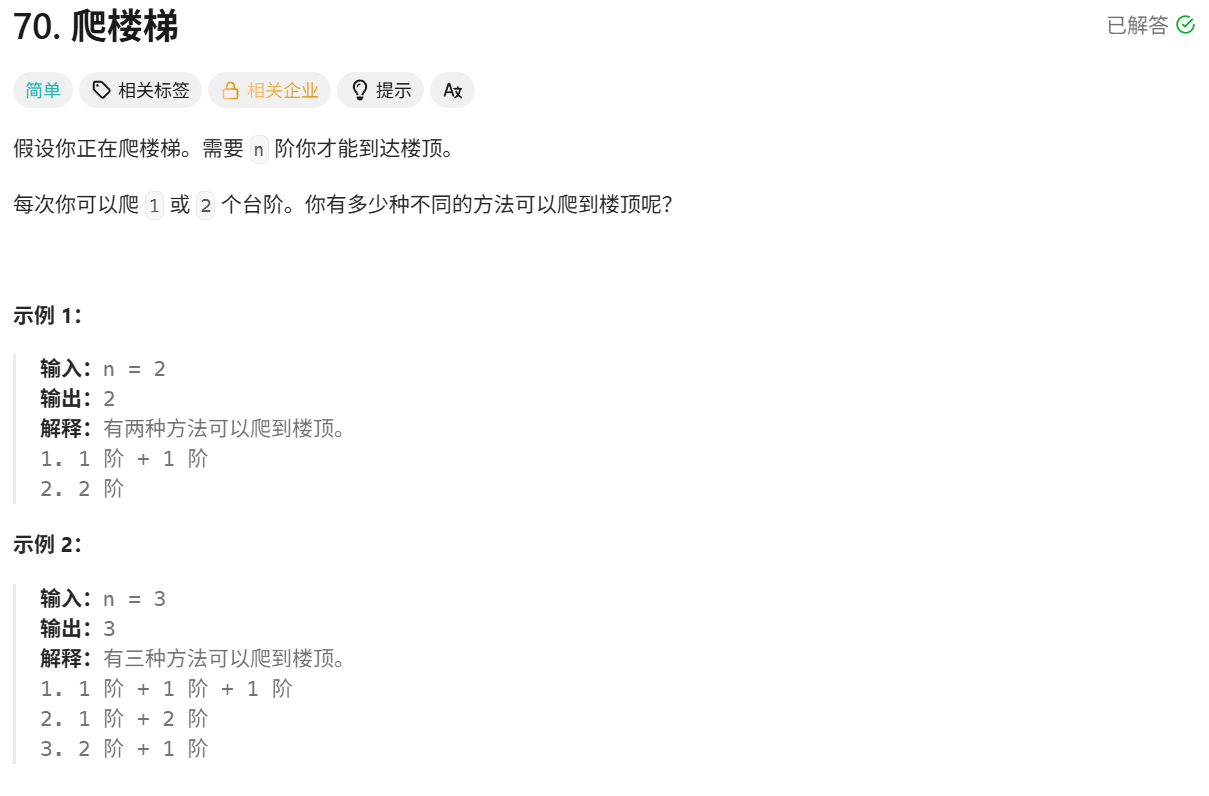
题意:n 阶楼梯,每次可以爬 1 或 2 个台阶,问有多少种不同的爬法。
先拿小例子找感觉,n = 3 时手动枚举:
1 | 方法1: 1 + 1 + 1 (每步爬1阶) |
怎么判断这是动态规划问题? 对照第一部分的两个特征:
- 大问题能拆成小问题:到达第 n 阶的方法数,看起来和"到达更矮台阶的方法数"有关——规模可拆
- 无后效性:只要知道"人在第 3 阶",之后怎么爬就和他的来路无关——状态可压缩
两个特征都满足,可以往 DP 方向想。
怎么拆解?站在第 n 阶台阶往回看
这是推导转移方程的关键动作:不要顺着想"我要怎么爬到 n",而是站在第 n 阶往回看——最后一步是什么?
最后一步只可能有两种情况:
1 | 第 n-1 阶 ──爬1步──→ 第 n 阶 |
因为每次只能爬 1 或 2 阶,不存在第三种到达方式。所以全部方法可以分成不重不漏的两类:
- A 类:最后一步是从第 n-1 阶爬 1 步上来的
- B 类:最后一步是从第 n-2 阶爬 2 步上来的
那 A 类有多少种?注意一个关键点:**"爬到第 n-1 阶"的每一种方法,后面接一步爬 1 阶,就唯一对应一种爬到第 n 阶的方法**。所以 A 类的数量 = 爬到第 n-1 阶的方法数。同理 B 类 = 爬到第 n-2 阶的方法数。
两类相加(不重不漏,直接加):
1 | 到达第 n 阶的方法数 = 到达第 n-1 阶的方法数 + 到达第 n-2 阶的方法数 |
大问题成功拆成了两个小问题,且形式和原问题完全一样——递推关系成立。
验证一下:n=3 时,方法数 = 到达第 2 阶的方法数 + 到达第 1 阶的方法数。
1 | 到达第 1 阶:1 种(爬1步) |
套用三要素:
状态定义:
dp[i]表示爬到第 i 阶的方法数状态转移方程:
dp[i] = dp[i-1] + dp[i-2]初始条件:
dp[1] = 1(爬 1 步,1 种)dp[2] = 2(1+1 或 2,2 种)
(转移方程在 i=2 时要用
dp[0],为方便也可以设dp[0] = 1(站着不动算 1 种),两种给法等价,本文代码采用dp[1]、dp[2]直接给定。)
3. 代码
1 | public int climbStairs(int n) { |
空间优化(照搬斐波那契的滚动变量,因为转移方程一模一样):
1 | public int climbStairs(int n) { |
时间复杂度 O(n),空间复杂度 O(1)。
一个有意思的观察:爬楼梯的转移方程 dp[i] = dp[i-1] + dp[i-2] 和斐波那契 f(n) = f(n-1) + f(n-2) 一模一样——只是初始值不同。两道看起来不相关的题,拆到最后是同一个递推结构,这正是 DP 的魅力:转移方程才是问题的骨架。
四、例题二:杨辉三角
1. 题目
2. 题目分析
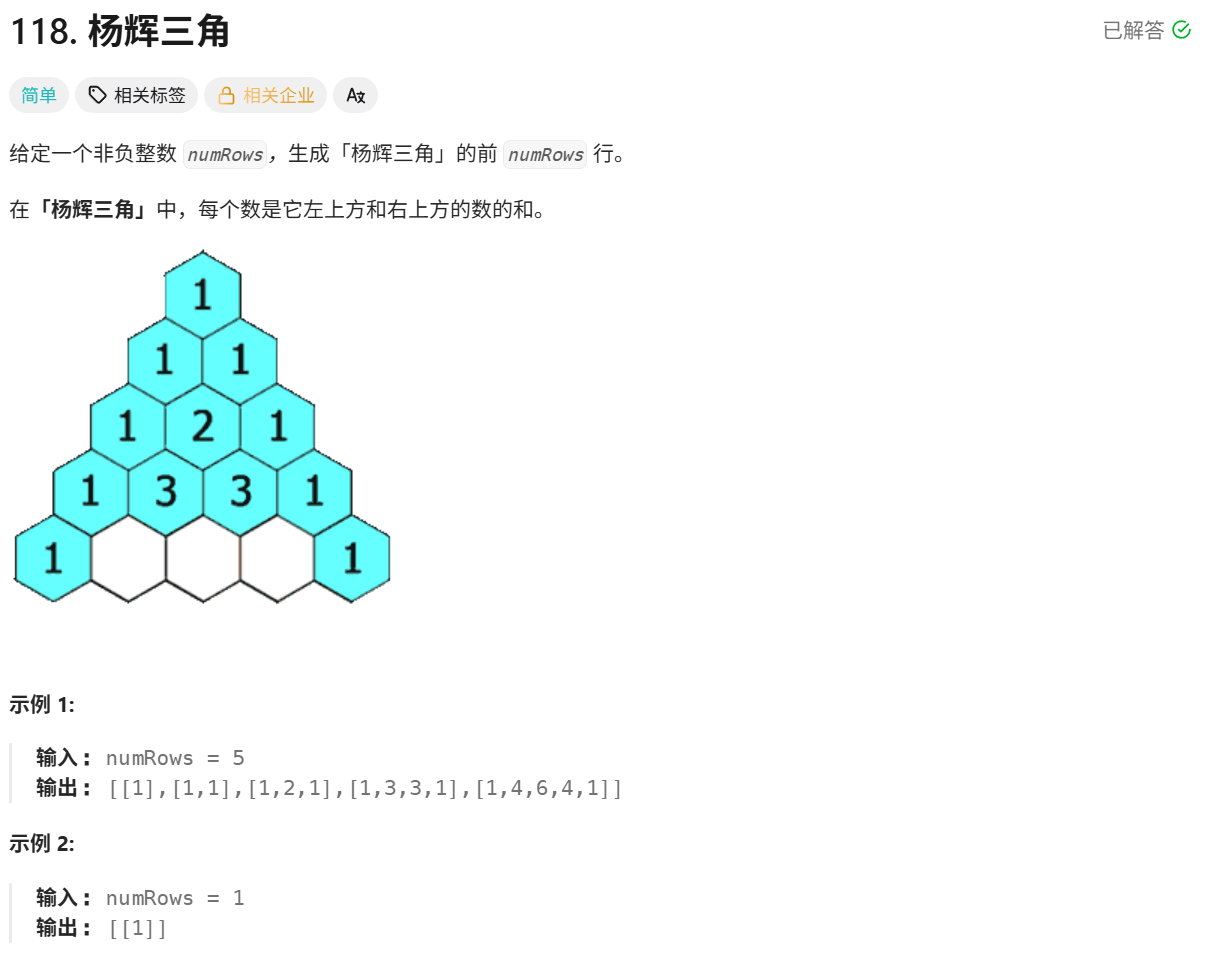
题意:给定行数 numRows,生成杨辉三角的前 numRows 行。
1 | 1 |
怎么判断这是动态规划问题?
- 大问题能拆成小问题:第 i 行的每个元素,看起来都和第 i-1 行有关——上面的行算好了,下面的行才能算
- 无后效性:第 i 行只依赖第 i-1 行的数值,不依赖"第 i-1 行是怎么算出来的"
满足特征,往 DP 方向想。而且这题的状态是二维的(行 + 列),正好看看二维 DP 长什么样。
怎么拆解?站在第 i 行第 j 列的位置往上看
和爬楼梯的"站在 n 阶往回看"一个套路:盯住三角形中间任意一个位置,看它由谁决定。
取第 4 行的 3(numRows=5,从 0 开始数是第 3 行):
1 | 1 |
1 | 第3行第1列的 3 = 第2行第0列的 1 + 第2行第1列的 2 |
规律:中间位置 (i, j) 的值 = 它左上方 (i-1, j-1) 与 正上方 (i-1, j) 两个数之和。
为什么?从组合数的角度,杨辉三角第 n 行是二项式系数,C(n, j) = C(n-1, j-1) + C(n-1, j) 是组合数的递推公式;从直观角度,每一个数正好"接收"上方两个分支的贡献。
那每行首尾的 1 呢? 它们头上只有一个数(首列头上缺左上、尾列头上缺正上),转移方程凑不齐两个加数,推不出来——这正是"初始条件/边界"要出场的地方:首尾位置直接给定 1,中间位置才走转移方程。
套用三要素:
- 状态定义:
dp[i][j]表示第 i 行第 j 列的元素 - 状态转移方程:
1 | dp[i][j] = dp[i-1][j-1] + dp[i-1][j] (0 < j < i,中间位置) |
初始条件:
dp[0][0] = 1(塔尖)计算顺序:逐行从上往下,行内从左往右——保证算
dp[i][j]时,dp[i-1]整行已经算好。
验证:dp[3][1] = dp[2][0] + dp[2][1] = 1 + 2 = 3 ✓,和三角形里的 3 一致。
3. 代码
1 | public List<List<Integer>> generate(int numRows) { |
复杂度:
- 时间复杂度 O(numRows²):总元素个数是 1+2+...+numRows ≈ numRows²/2
- 空间复杂度 O(numRows²):题目要求返回整个三角形,无法省略
关于空间优化:按套路,dp[i] 只依赖 dp[i-1],本可以只用一个滚动数组。但这题要返回完整的三角形,整张表本身就是答案,所以不优化——空间优化是"可选"动作,得看题目的要求。
五、动态规划的解题套路
1. 判断是不是 DP 问题
对照特征:
- 大问题能拆成同样形式的小问题?
- 当前状态定了之后,后续和来路无关(无后效性)?
2. 确定状态定义
问自己:dp[i] 或 dp[i][j] 表示什么?
- 爬楼梯:
dp[i]表示爬到第 i 阶的方法数 - 杨辉三角:
dp[i][j]表示第 i 行第 j 列的元素
3. 推导状态转移方程(最核心的一步)
问自己:站在目标状态往回看,最后一步从哪来?
- 爬楼梯:站在第 i 阶往回看,最后一步来自第 i-1 阶或第 i-2 阶 →
dp[i] = dp[i-1] + dp[i-2] - 杨辉三角:站在 (i,j) 往上看,来自左上和正上两个数 →
dp[i][j] = dp[i-1][j-1] + dp[i-1][j]
4. 确定初始条件和边界
问自己:转移方程推不出来的最小状态是哪些?手动给定。
- 爬楼梯:
dp[1] = 1,dp[2] = 2 - 杨辉三角:塔尖
dp[0][0] = 1,每行首尾dp[i][0] = dp[i][i] = 1
5. 确定计算顺序
问自己:算某个状态时,它依赖的状态必须已经算好。
- 爬楼梯:i 从小到大
- 杨辉三角:行从上到下、列从左到右
6. 优化空间复杂度(可选)
问自己:dp[i] 只依赖哪几个状态?只保留它们够不够?
- 爬楼梯:只依赖前两个 → 滚动变量,O(1)
- 杨辉三角:只依赖上一行 → 可滚动,但题目要完整答案,不优化
六、总结
动态规划是什么:解决"大问题可拆成小问题"类问题的方法,本质是"递归 + 缓存 + 自底向上"。
演进路径:暴力递归(O(2ⁿ))→ 记忆化搜索(O(n),自顶向下)→ DP 表格(O(n),自底向上)→ 空间优化(O(1))。
解题三要素:
- 状态定义:
dp[i]装什么 - 状态转移方程:
dp[i]怎么由小状态推出来(站在目标状态往回看,最后一步从哪来) - 初始条件:转移方程推不出来的起点
两道例题的共性:分析手法完全一样——爬楼梯是"站在第 i 阶往回看最后一步",杨辉三角是"站在 (i,j) 往上看由谁贡献"。转移方程从来不是背出来的,是站在目标位置回溯来路推出来的。