Hot 100 --- 跳跃游戏
本文概览:本文讲解跳跃游戏的核心思路:不关心具体走哪条路,只维护"最远可达位置"一个变量,覆盖不了的索引直接判 false,从路径枚举降到 O(n)
一、题目
二、题目分析
1. 题目要求
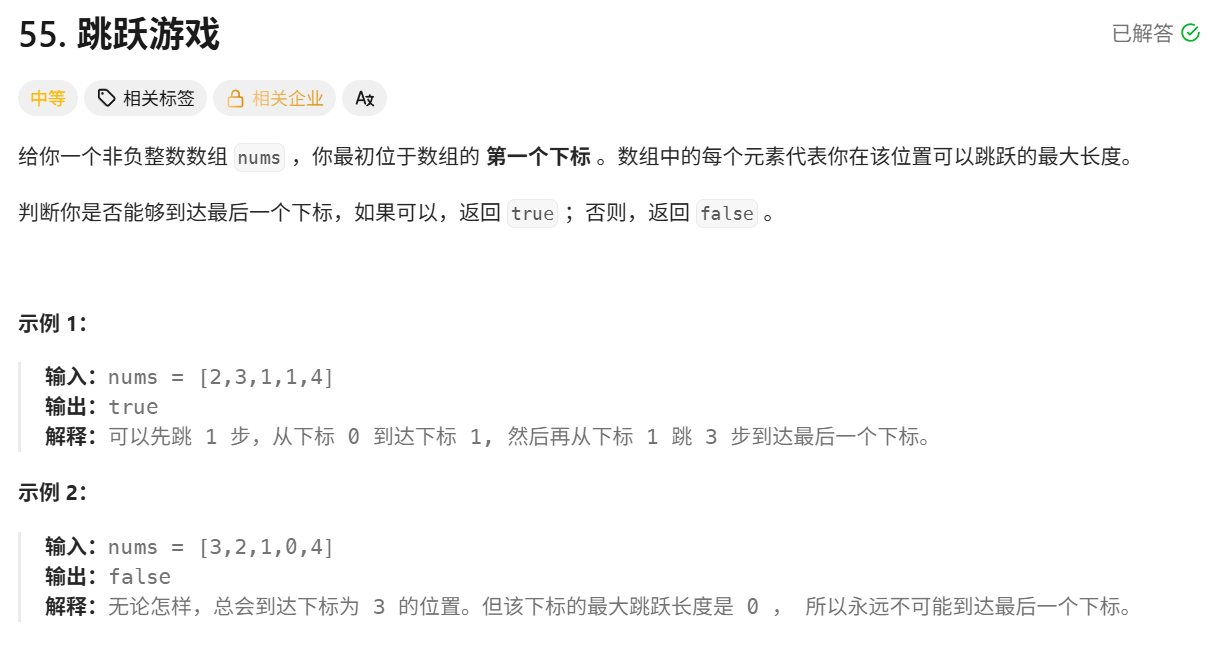
给定一个非负整数数组 nums,最初位于下标 0。每个元素代表在该位置能往前跳的最大步数(可以少跳)。判断是否能到达最后一个下标。
例子:nums = [2, 3, 1, 1, 4]
1 | 0 1 2 3 4 ← 索引 |
- 索引 0 的值是 2 → 从这里最多走 2 步,可以到达索引 1 或索引 2
- 索引 1 的值是 3 → 从这里最多走 3 步,可以到达索引 2、3、4
一条可行的路:先跳 1 步到下标 1,再从下标 1 跳 3 步到达最后一个下标 4 → 输出 true。
注意"最大步数"的含义:值是 3 不是必须跳 3 步,跳 1 步、2 步都可以。
2. 暴力思路:枚举所有路径
从 0 索引出发,值是 2,代表着可以去索引 1 和索引 2——这是两条不同的路。每到一个位置又分出若干条路,如果要暴力,必然是全部遍历:把所有可能的路都走一遍,看有没有一条能到终点(DFS 枚举)。
问题:路径数量是指数级的,每个位置最多分出 n 条分支,最坏 O(nⁿ) 或 O(2ⁿ),必然超时。
3. 核心观察:走法之间存在"覆盖"
转换一下想法,不要把目光放在每一步具体怎么跳。看这个例子:
1 | 0 1 2 3 4 ← 索引 |
对比索引 1 和索引 2 的覆盖范围:
- 索引 2 能到的地方(索引 3),索引 1 全都能到
- 索引 1 还能到索引 4,索引 2 到不了
也就是说,即使先走到索引 2 再去索引 3,先走索引 1 一样能去索引 3,完全没区别——走索引 2 这条路被索引 1 完全覆盖了,根本没必要走,索引 1 的可能性和路还更多。
结论:具体走哪条路根本不重要,重要的是目前所有走法合在一起,最远能到哪。只维护一个"最远可达距离",每遍历一个位置就用 i + nums[i] 尝试刷新它;一旦发现某个索引连最远可达距离都够不着,说明前面无论哪条路都到不了这里,直接返回 false。这就是贪心思路:只记录最远。
三、思路概览
1 | public boolean canJump(int[] nums) { |
思路简要说明:
- totalDistance:终点的索引,
nums.length - 1 - maxDistance:到目前为止,所有走法合起来能到达的最远索引
- 三步一循环:
i > maxDistance→ 索引 i 不可达,前面的路全断,返回 false- 刷新
maxDistance = max(maxDistance, i + nums[i])(站在 i 最多跳到 i + nums[i]) maxDistance >= totalDistance→ 已经够到终点,提前返回 true
- **时间复杂度 O(n)**:一遍遍历,O(nⁿ) 的路径枚举被压成一个变量
四、思路详解
第一步:暴力到底在重复算什么?
暴力把"经过索引 2 去索引 3"和"经过索引 1 去索引 3"当成两条不同的路分别验证。但从"能不能到达"这个角度看,这两条路结果完全一样——它们的终点集合有大量重合。
更糟的是这种重合会层层叠加:每往前走一步,都在为已经覆盖过的位置重新找路。指数级的路径里,绝大多数都是这种被覆盖的无效走法。
优化方向:如果一种走法的覆盖范围完全被另一种包含,前者可以直接丢弃。而"所有走法的并集",其实只需要一个数就能表示——最远可达距离。
第二步:为什么"最远可达距离"一个数就够了?
这里有两个性质支撑:
性质一:可达范围是连续的。nums[i] 表示能跳的最大步数,可以少跳。所以如果能到索引 5,那么途经的索引 1、2、3、4 全都能到(跳的时候少跳几步就行)。不存在"能到 5 却到不了 3"的情况。
性质二:前面所有走法的贡献可以合并。遍历到索引 i 时,[0, i-1] 所有位置的跳跃能力已经全部体现在 maxDistance 里了——每个位置都贡献过一次自己的 j + nums[j],取最大值就是并集的右边界。
1 | 索引0 贡献: 0 + 2 = 2 |
所以判断"索引 i 能不能到",只需要看 i <= maxDistance,一个比较就完成了暴力里所有路径的验证。
第三步:为什么 i > maxDistance 就直接 false?
遍历是按索引从小到大走的。如果走到索引 i 时发现 i > maxDistance:
maxDistance是[0, i-1]全部走法合力能达到的最远位置- 连这个最远位置都够不到
i,说明前面无论怎么组合,都不可能到 i
而且后面的索引更远,i 都到不了,后面的更别想——所以不用犹豫,直接返回 false,后面全不用看了。
第四步:为什么能提前返回 true?
maxDistance >= totalDistance 说明此时已经有某条路(不必知道是哪条)能到终点了,后面还没遍历的位置已经无所谓——它们只会把 maxDistance 刷得更远,不会改变"能到终点"这个事实。提前返回是个小剪枝,最直接的收益是像 [2, 3, 1, 1, 4] 这种例子,走到索引 1 就结束了,不用扫完全程。
(循环外的 return true 是兜底:实际能通过循环内判断覆盖所有情况,比如单元素数组 [0],totalDistance = 0,i=0 时 maxDistance = 0 >= 0 同样提前返回 true。)
完整执行过程
例子一:nums = [2, 3, 1, 1, 4](能到终点)
1 | 初始:totalDistance = 4,maxDistance = 0 |
例子二:nums = [3, 2, 1, 0, 4](卡在中间)
1 | 0 1 2 3 4 ← 索引 |
例子二正说明了 false 判断的正确性:索引 3 的值是 0,无论前面怎么走,maxDistance 死死卡在 3,索引 4 永远够不到——不是某条路选错了,而是所有路都到不了。
复杂度分析
**时间复杂度 O(n)**:一遍遍历,每个索引做常数次比较和取 max。对比暴力枚举所有路径的指数级复杂度,这是"只维护最远可达、丢弃所有被覆盖走法"换来的。
**空间复杂度 O(1)**:只用了两个变量。
五、总结
跳跃游戏的核心思路:
- 题意:每个值是能往前跳的最大步数(可以少跳),问能否到终点
- 暴力:DFS 枚举所有路径,指数级,必然超时
- 核心观察:走法之间存在覆盖——索引 1 的覆盖范围完全包含索引 2 的,走法被覆盖就无意义
- 贪心策略:不记录路径,只维护
maxDistance(最远可达索引),每到一个位置用i + nums[i]刷新 - 两个判断:
i > maxDistance→ 全断,false;maxDistance >= totalDistance→ 够到终点,true
贪心思想在本题的体现:把"无数条路径的并集"压缩成"最远可达位置"一个数。可达范围连续 + 各位置贡献可合并,这两个性质保证了一个变量就能代表全部路径信息。
这个套路和买卖股票的最佳时机如出一辙:**都是发现"细节信息可以丢弃"**——股票题丢弃的是"具体哪天买入"(只需历史最低价),这题丢弃的是"具体走哪条路"(只需最远可达)。遇到"枚举所有方案"型的暴力,先找找有没有能一个变量代表的聚合信息。