Redis 为什么又快又省内存?五大类型底层结构与编码切换全解
同一个
SET、同一个HSET,底层用的可能完全是两种数据结构——这正是 Redis"一套接口、多套内核"的设计。本文把八种底层结构、五种类型的编码切换阈值、版本演进和真实业务场景一次讲透,读完你能说清每个OBJECT ENCODING背后到底是什么。
阅读路线
本文分四块,可以按需跳读:
- 第一章:type 与 encoding 的设计思想、编码切换阈值总表、版本演进总表。
- 第二章:八种底层结构详解——SDS、双向链表、ziplist、listpack、quicklist、hashtable、intset、跳表。
- 第三、四章:五大基本类型与三种扩展类型的编码、完整命令与业务场景。
- 第五章:配置参数默认值与调优思路;第六章为总结。
一、一套接口,多套内核:type 与 encoding
在深入每种结构之前,先把 Redis 的设计思路说清楚,后面看每种结构时才知道它为什么要长成那样。
1.1 type 和 encoding 是两件事
Redis 里每存一个值,都会被包成一个 redisObject,其中最关键的两个字段是:
- type(类型):对外暴露的类型,就是
TYPE key返回的东西,五种基本类型分别是 String、List、Hash、Set、ZSet。对使用者是固定的。 - encoding(编码):真正的底层实现,就是
OBJECT ENCODING key返回的东西。对使用者透明,会随数据量和数据大小自动变化。
用一组命令直观感受一下——同一个 SET,底层可能完全不同:
1 | 127.0.0.1:6379> SET num 100 |
1.2 为什么同一个类型要有多种实现
因为"省内存"和"快"在数据结构上往往是矛盾的:
- 连续内存的紧凑结构(ziplist / listpack / intset):内存利用率高、CPU 缓存友好,但元素多了查找是 O(N),插入还可能触发整块搬移。
- 指针式的复杂结构(hashtable / skiplist):哈希表的增删查改是 O(1),跳表是 O(log N)(对数复杂度,元素翻倍只多查常数次),都远快于线性遍历;代价是每个元素都要额外的指针开销,小数据量下"杀鸡用牛刀"。
Redis 的策略是动态权衡:数据量小的时候用紧凑结构省内存,数据量大了自动切换成高性能结构。这就是"编码转换"的由来,也是全文要反复解释的主线。
1.3 五种类型的底层结构概览(新旧版本对比)
底层结构随版本演进变化不小,先用两张图把新旧版本的关系看清楚。
旧版(Redis 3.0 / 《Redis 设计与实现》所讲版本):
graph LR
    S[String] --> S1[int]
    S --> S2[SDS: embstr / raw]
    L[List] --> L1[ziplist 压缩列表]
    L --> L2[linkedlist 双向链表]
    H[Hash] --> H1[ziplist]
    H --> H2[hashtable]
    SE[Set] --> SE1[intset]
    SE --> SE2[hashtable]
    Z[ZSet] --> Z1[ziplist]
    Z --> Z2[skiplist + hashtable]
新版(Redis 7.x):
graph LR
    S[String] --> S1[int]
    S --> S2[SDS: embstr / raw]
    L[List] --> L1[listpack 小 List]
    L --> L2[quicklist 内含 listpack]
    H[Hash] --> H1[listpack]
    H --> H2[hashtable]
    SE[Set] --> SE1[intset]
    SE --> SE2[listpack 7.2+]
    SE --> SE3[hashtable]
    Z[ZSet] --> Z1[listpack]
    Z --> Z2[skiplist + hashtable]
1.4 编码切换阈值总表(含正确默认值)
这张表是全篇的"索引",后文每种结构都会解释这些数字的来历。符合左侧条件就用紧凑编码,一旦超过阈值就升级成右侧编码,且基本不可逆。
| 类型 | 紧凑编码 | 触发升级的条件(Redis 7.x 默认值) | 升级后编码 |
|---|---|---|---|
| String | int / embstr |
值为 64 位整数 → int;否则长度 > 44 字节 → raw |
raw |
| List | listpack |
由 list-max-listpack-size(默认 -2 = 8KB)控制每个 quicklist 节点大小 |
quicklist |
| Hash | listpack |
字段数 > hash-max-listpack-entries(默认 512)或任一 field/value 长度 > hash-max-listpack-value(默认 64) |
hashtable |
| Set | intset → listpack |
出现非整数,或数量 > set-max-intset-entries(默认 512)→ 触发编码转化:满足 ≤ set-max-listpack-entries(默认 128)且元素 ≤ 64 字节 → 转化为 listpack(7.2+);否则转化为 hashtable |
hashtable |
| ZSet | listpack |
元素数 > zset-max-listpack-entries(默认 128)或成员长度 > zset-max-listpack-value(默认 64) |
skiplist + hashtable |
记住三个关键数字:44(String 的长度阈值)、512(Hash 的字段数上限、Set 的 intset 元素上限)、128(ZSet 的元素上限、Set 的 listpack 元素上限)。
⚠️ 注意一个常见误区:Hash 的 entries 默认是 512,不是 128;ZSet 才是 128。网上不少文章把这两个数字记混了。
关于"不可逆":编码转换基本是单向的——从紧凑编码转成 hashtable / skiplist 后,即便之后元素减少,也不会转回来。因为降级要重新遍历、搬移数据,而且降完可能很快又升回去,来回折腾不划算,牺牲一点空间换实现简单与性能稳定。
1.5 底层结构的版本演进总表
Redis 在版本迭代中替换过不少底层结构,这也是面试常问的点:
| 对象 | Redis ≤ 6.2 | Redis 7.0 | Redis 7.2 |
|---|---|---|---|
| Hash / ZSet 的紧凑编码 | ziplist |
换成 listpack |
listpack |
| List 的紧凑容器 | ≤3.0:ziplist / linkedlist 二选一;3.2–6.2:quicklist(节点内是 ziplist) |
quicklist(节点内换成 listpack),小 List 可直接 listpack |
同 7.0 |
| Set 的紧凑编码 | intset / hashtable |
同 6.2 | 新增 listpack 一档 |
| 配置参数名 | hash-max-ziplist-entries 等 |
改名为 hash-max-listpack-entries 等 |
新增 set-max-listpack-entries |
一条主线:Redis 7.0 用 listpack 全面替换了 ziplist,原因是 ziplist 有一个叫"连锁更新"的致命缺陷,下面会详细讲。
二、八种底层数据结构详解
2.1 SDS:动态字符串
它要解决 C 字符串的什么问题
Redis 没有直接用 C 语言的原生字符串(char *),而是自研了 SDS(Simple Dynamic String,简单动态字符串)。原因是 C 字符串有几个硬伤:
- 获取长度 O(N):C 字符串靠末尾的
\0判断结束,求长度只能从头遍历到尾。 - 非二进制安全:一旦数据中间出现
\0,就会被当成字符串结束,导致提前截断、长度算错,没法存图片、视频这类二进制数据。 - 容易缓冲区溢出:比如
char *strcat(char *dest, const char *src);把src拼到dest后面,它默认你已经为 dest 分配了足够的内存,不会做二次分配。如果 dest 的连续内存不够,就会越界溢出,甚至导致程序崩溃。 - 拼接效率低:
strcat还是要先遍历找到第一个字符串的结尾,再拼接,复杂度高。
结构
SDS 的解法是:在字符串前面加一个头部,用元数据换性能。
1 | struct __attribute__ ((__packed__)) sdshdr8 { |
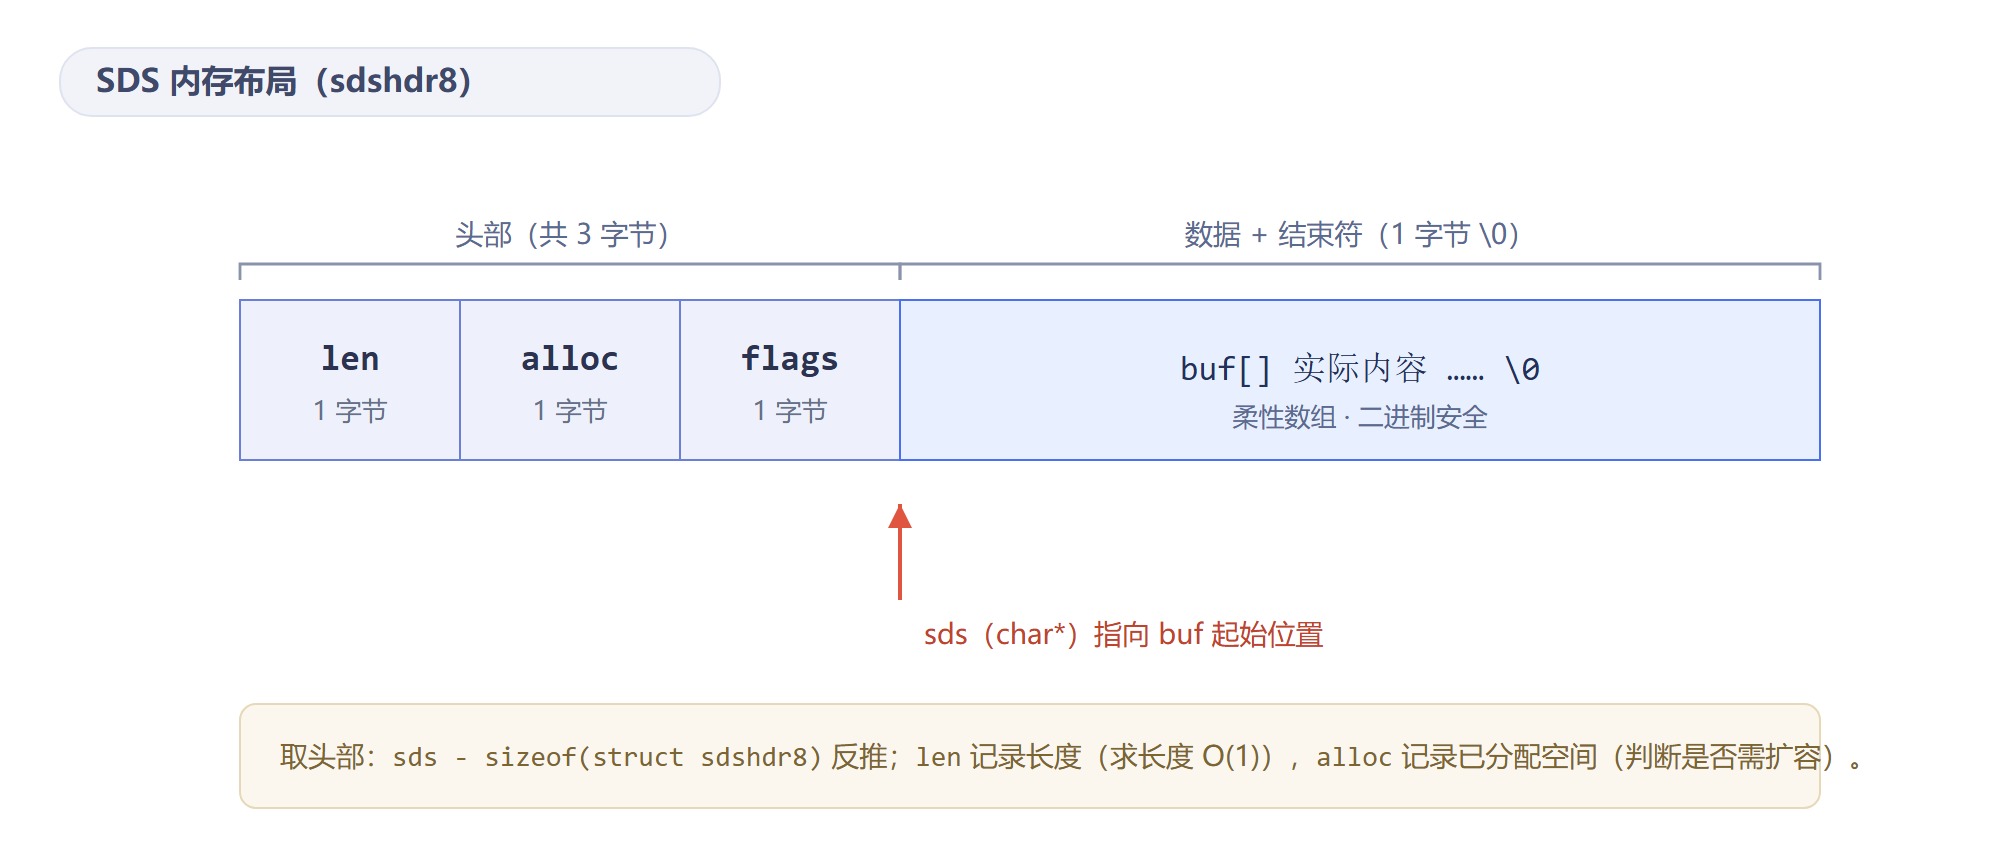
四个关键属性:
len:记录字符串长度。求长度时直接返回这个值即可,时间复杂度 O(1)。alloc:记录分配给字符数组的空间长度。修改字符串时用alloc - len就能算出剩余空间,判断是否够用;不够就自动扩展,所以既不需要手动扩容,也不会出现缓冲区溢出。- flags:标识 SDS 类型,一共 5 种:
sdshdr5、sdshdr8、sdshdr16、sdshdr32、sdshdr64。 buf[]:字节数组,保存实际数据。既能存字符串,也能存二进制数据。
三个核心优势
① O(1) 求长度:len 是 SDS 结构体里的一个属性,本身就记录了当前字符串的长度,求长度时直接读取这个属性即可,不需要遍历,STRLEN 命令也因此是 O(1)。
② 二进制安全:不再用 \0 标识结尾,而是用 len 记录长度,所以可以存包含 \0 的数据。同时为了兼容 C 标准库函数(如 printf),末尾仍会补一个 \0,但长度并不依赖它。并且 SDS 对传入的二进制数据不做任何修改、原样存储,因此能保存各种类型的数据。
③ 动态扩容,杜绝缓冲区溢出:扩容逻辑在 sdsMakeRoomFor 里:
1 | sds sdsMakeRoomFor(sds s, size_t addlen) { |
简单说:新长度小于 1MB 时容量翻倍,超过 1MB 时新空间 = 需要长度 + 1MB。
这个"多分配一点"的好处是:减少连续修改(尤其是 append 拼接)时的内存重分配次数。比如连续追加 N 次字符串,如果不预留,每次都要 realloc 一次,共 N 次;预留一倍空间后,可能只需要扩容 log 次。另外,SDS 缩短时也不立即释放多余空间(惰性释放),把空间记在 alloc - len 里留着下次复用,进一步减少重分配开销。
类型分档:用不同精度的头部省内存
SDS 有 5 种头部,区别在于 len 和 alloc 的数据类型不同,从而头部大小不同:
| 类型 | len/alloc 类型 | 头部大小 | 适用长度 |
|---|---|---|---|
sdshdr5 |
无独立 len/alloc,长度存在 flags 高 5 位 | 1 字节 | < 32(实际已基本不再用于新建) |
sdshdr8 |
uint8_t |
3 字节 | < 256 |
sdshdr16 |
uint16_t |
5 字节 | < 2^16 |
sdshdr32 |
uint32_t |
9 字节 | < 2^32 |
sdshdr64 |
uint64_t |
17 字节 | < 2^64 |
为什么这样设计? 如果只有一种头部(比如统一用 8 字节的 uint64_t 存长度),那存一个 "age=18" 这种 6 字节的短字符串,头部反而比数据还大。根据字符串实际长度选择"最小够用"的头部,能省下大量内存。以 sdshdr16 和 sdshdr32 为例:前者的 len/alloc 都是 uint16_t,上限 2^16;后者都是 uint32_t,上限 2^32。按需取用即可。
编译优化:__attribute__ ((packed))
除了设计多种头部,Redis 还用了一个编译层面的技巧——在 struct 声明上加 __attribute__ ((packed))。它的作用是告诉编译器取消结构体的内存对齐优化,按实际占用字节数来对齐。
举个例子:
1 | // 不加 packed:编译器为对齐会插入填充字节 |
SDS 的头部不需要按机器字对齐,用 packed 把填充字节去掉,头部更紧凑,也就更省内存。
版本差异:
embstr的长度阈值在 Redis 3.2 前后不同——3.2 之前是 39 字节,3.2 及以后是 44 字节(因为 SDS 头部结构改了)。字符串的三种编码详细对比见第三章。
2.2 双向链表
双向链表本身没什么特殊的设计,就是标准的链表节点:
1 | typedef struct listNode { |
在此基础上,Redis 又封装了一层 list,方便快速获取链表的各种属性:
1 | typedef struct list { |
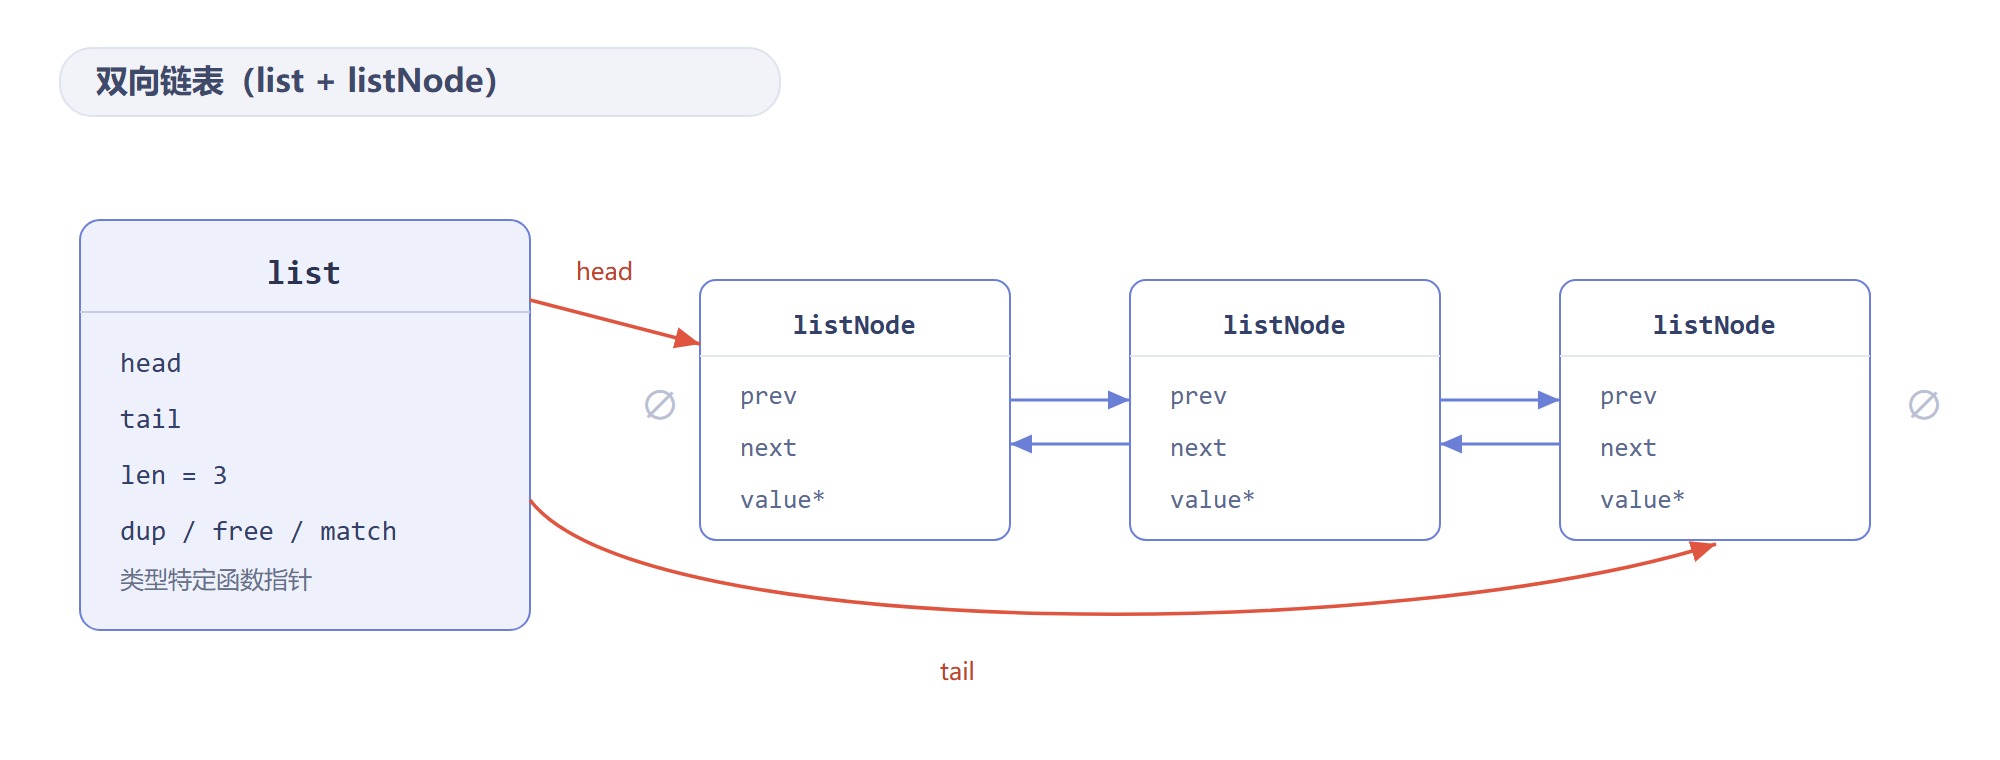
优点与原因:
- 获取前后节点 O(1):因为节点里直接存了
prev/next指针,想找相邻节点直接跳过去就行。 - 头尾节点、链表长度都是 O(1):因为外层
list结构体直接缓存了head、tail、len,读取是常量时间。 - 可保存任意类型值:因为
listNode用void *保存节点值,并且通过list的dup、free、match函数指针为节点设置类型特定的函数,所以同一套链表能装不同类型的数据。
缺点与原因:
- 内存不连续、碎片多:因为每个节点都是单独 malloc 出来的,地址分散,容易产生内存碎片,CPU 缓存也无法很好地利用。
- 指针开销大:每新增一个节点就要构造一个链表节点结构,很多时候值本身还没两个前后指针占的空间大。
正因为这两个缺点,Redis 在元素量比较少、且各元素内存占用不大的时候,会改用压缩列表(ziplist)来存储——也就是下面要讲的。
版本差异:双向链表(linkedlist 编码)在 Redis 3.2 引入 quicklist 后不再作为 List 的编码使用。不过源码里的 adlist.h(双向链表实现)仍然保留,作为 Redis 内部的通用结构服务于其他场景(如维护客户端列表、慢日志等)。
2.3 ziplist:压缩列表,以及它如何"不用指针也能当链表用"
压缩列表是 Redis 为了节约内存而开发的,它由连续内存块组成的顺序型数据结构,类似于数组。
整体结构
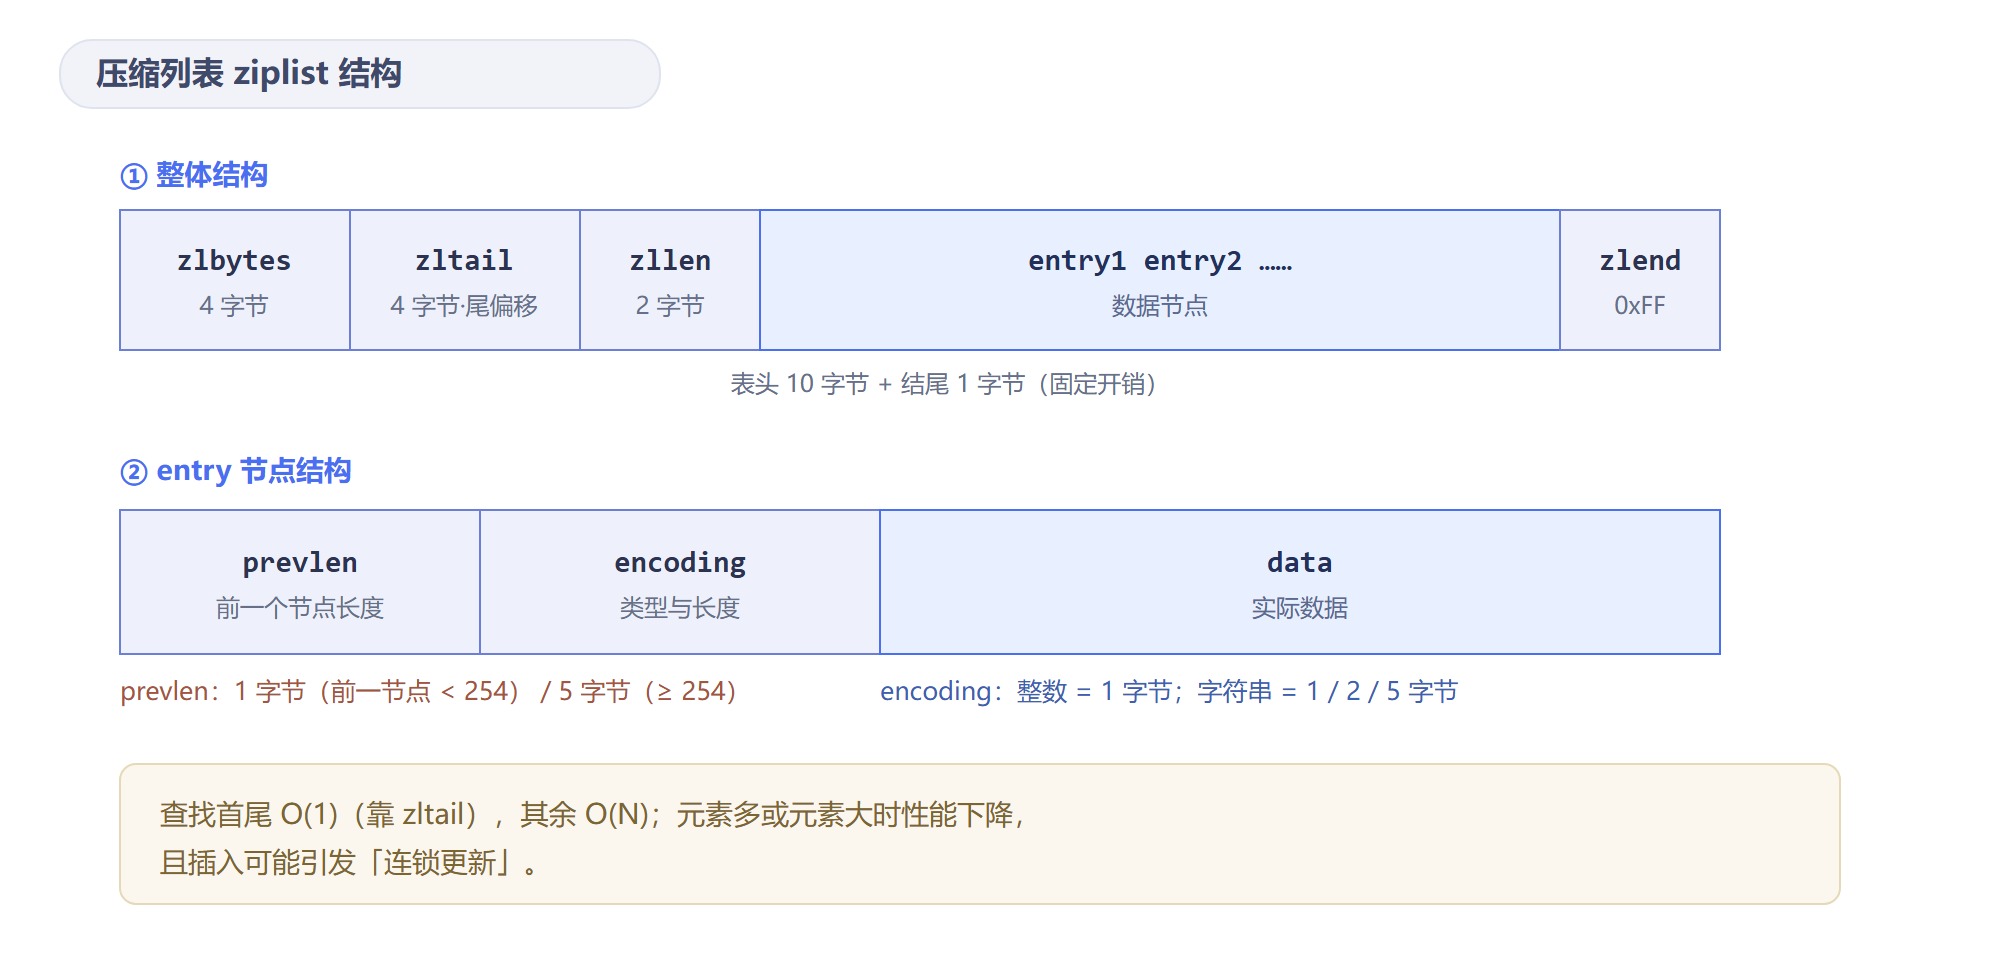
- zlbytes:记录整个压缩列表占用的内存字节数。
zltail:记录压缩列表「尾部」节点距离起始地址有多少字节,也就是列表尾的偏移量。- zllen:记录压缩列表包含的节点数量。
- zlend:标记压缩列表的结束点,固定值
0xFF(十进制 255)。 - entry:真正的数据节点。
查找效率:如果要定位第一个元素和最后一个元素,可以通过表头字段做到 O(1)(zltail 直接给出尾部偏移);而查找其他元素就只能逐个遍历,复杂度是 O(N)。因此压缩列表不适合保存过多的元素。
entry 的结构
entry 由 prevlen、encoding、data 三段组成:
prevlen:记录「前一个节点」的长度。- encoding:记录当前节点实际数据的「类型和长度」,类型主要有两种:字符串和整数,长度由 encoding 的具体值决定。
- data:当前节点的实际数据。
prevlen 和 encoding 都会根据数据大小进行变长分配,这本身就是一种省内存的优化:
| 字段 | 变长规则 |
|---|---|
prevlen |
前一个节点 < 254 字节 → 占 1 字节;≥ 254 字节 → 占 5 字节(首字节固定 0xFE,后跟 4 字节真实长度) |
encoding |
整数 → 占 1 字节(由编码类型确定 data 大小,如 int16 则 data 占 2 字节);字符串 → 按长度占 1 / 2 / 5 字节 |
简单说:encoding 的前两个 bit 标识数据类型(整数/字符串),后续 bit 标识字符串的实际长度。这样小数据只占很少的编码字节,非常省内存。
分界值取 254 而不是 255,是因为 255 已经被
zlend用作结束标记了。
它是怎么"不用指针也能当链表用"的
这是理解 ziplist 最关键的一点。ziplist 是一整块连续内存,节点之间没有任何 prev/next 指针,那它凭什么还能像链表一样前后遍历?答案是:用"长度信息"替代了"指针"。
- 从前往后遍历:靠当前 entry 的
encoding就能算出这个 entry 有多长,把指针往后挪这么多字节,就跳到下一个 entry。 - 从后往前遍历:靠当前 entry 的
prevlen。它记录了前一个 entry 的长度,用当前 entry 的起始地址 − prevlen,就得到前一个 entry 的起始地址,于是可以一路往前走。
一句话概括:正向遍历 = 当前地址 + 本 entry 长度;反向遍历 = 当前地址 − 前一个 entry 长度。
所以我们前面说"prevlen 是为了实现从后向前遍历"——这正是它存在的根本原因:没有指针的紧凑结构,只能靠记录长度来实现双向遍历(链表功能)。它用 1~5 字节的长度信息,替掉了指针式链表每个节点两个指针(8~16 字节)的开销,这就是 ziplist 省内存的核心来源。
致命缺陷:连锁更新
这套"记录前一个节点长度"的设计初衷是好的(方便反向遍历),但会引出一个严重问题——连锁更新。
假设现在这个压缩链表里,多个连续的 entry 长度都在 250~253 字节之间。因为每个 entry 都小于 254 字节,所以它们的 prevlen 都只用 1 个字节就够了。此时往最前面插入一个长度大于等于 254 字节的新节点,就会触发连锁扩张:
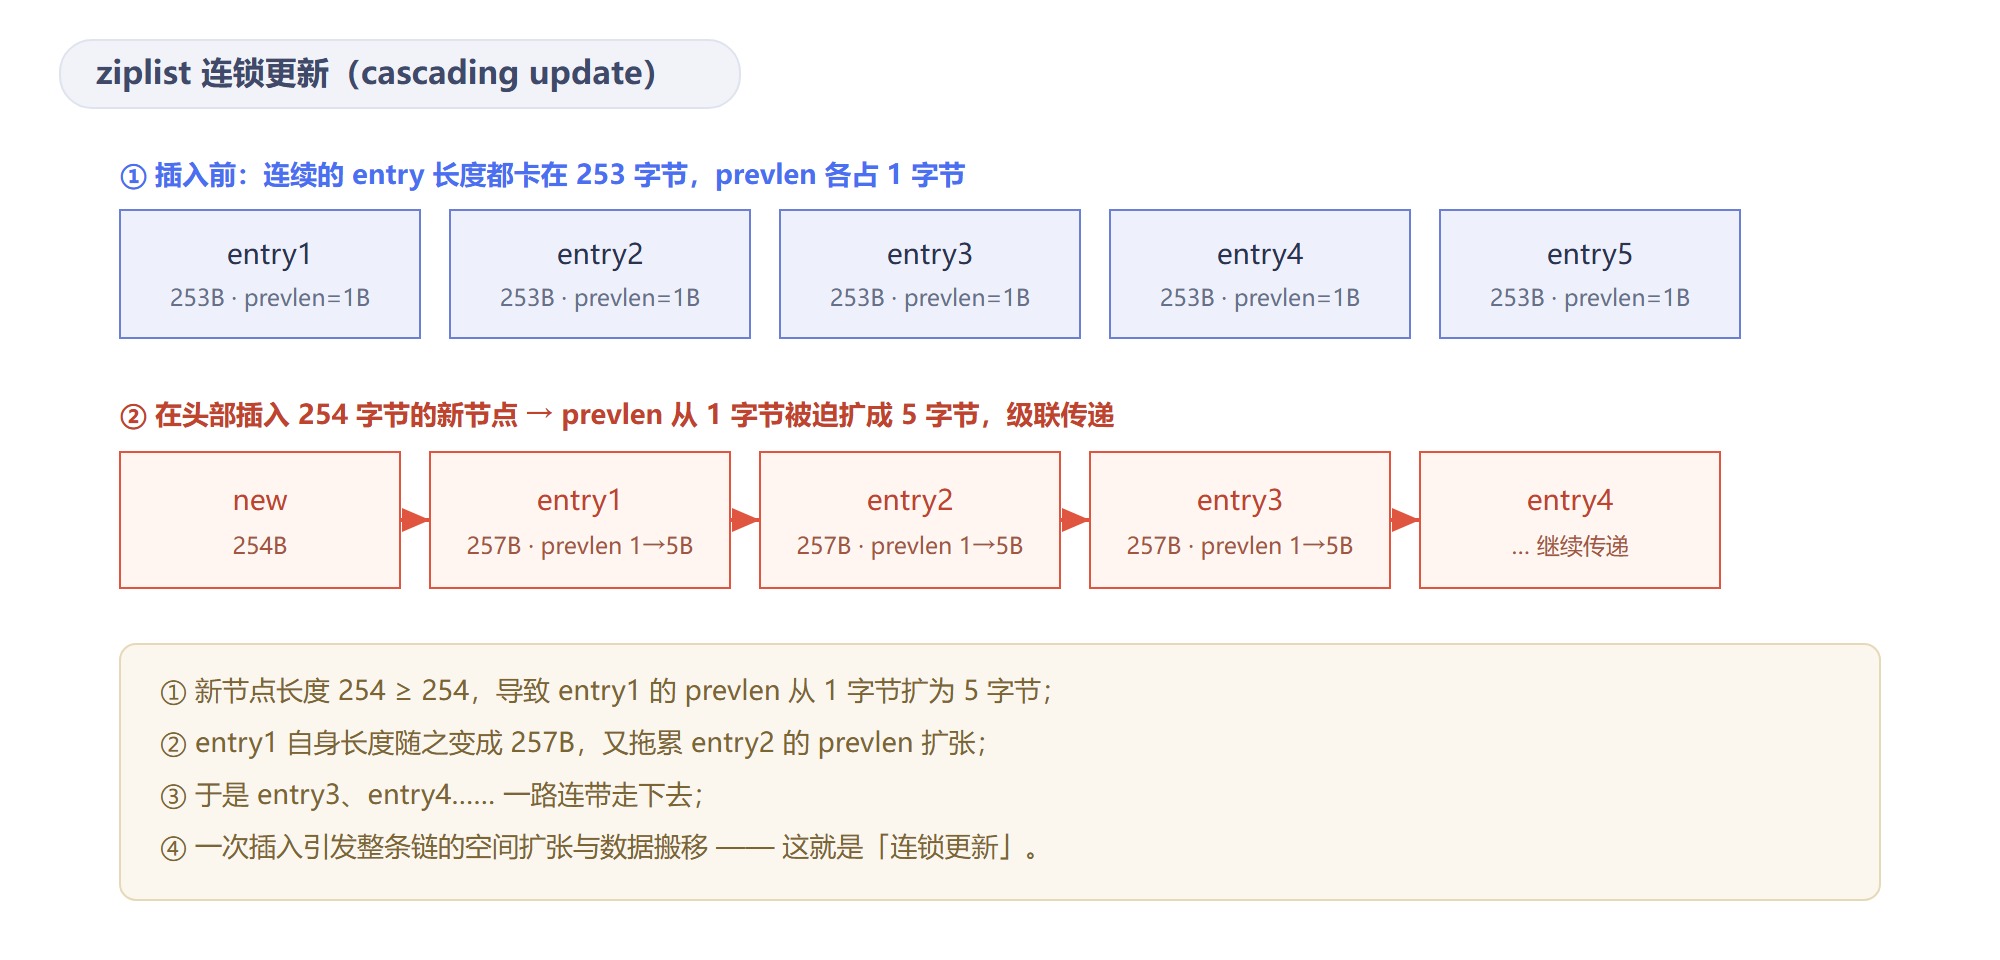
如上图所示:一次插入,可能引发整条链上所有 entry 的空间扩张与数据搬移,这就是连锁更新。虽然触发条件比较苛刻(需要连续多个 entry 长度卡在 250~253),但最坏情况下性能开销很大。所以压缩列表只适合保存节点不多、且单个元素内存占用不大的场景。
版本差异:ziplist 从 Redis 早期一直用到 6.2,作为 Hash / ZSet 的紧凑编码,以及 3.2~6.x 里 quicklist 节点的内部容器。到 Redis 7.0,它被 listpack 全面替换,原因就是上面这个连锁更新缺陷。
2.4 listpack:紧凑列表,以及它是怎么把"补丁"打上的
为了解决 ziplist 的连锁更新缺陷,Redis 引入了新结构体 listpack。它沿用了压缩列表的很多优秀设计:同样用一块连续内存紧凑地保存数据,同样为不同大小的数据采用不同编码。
整体结构
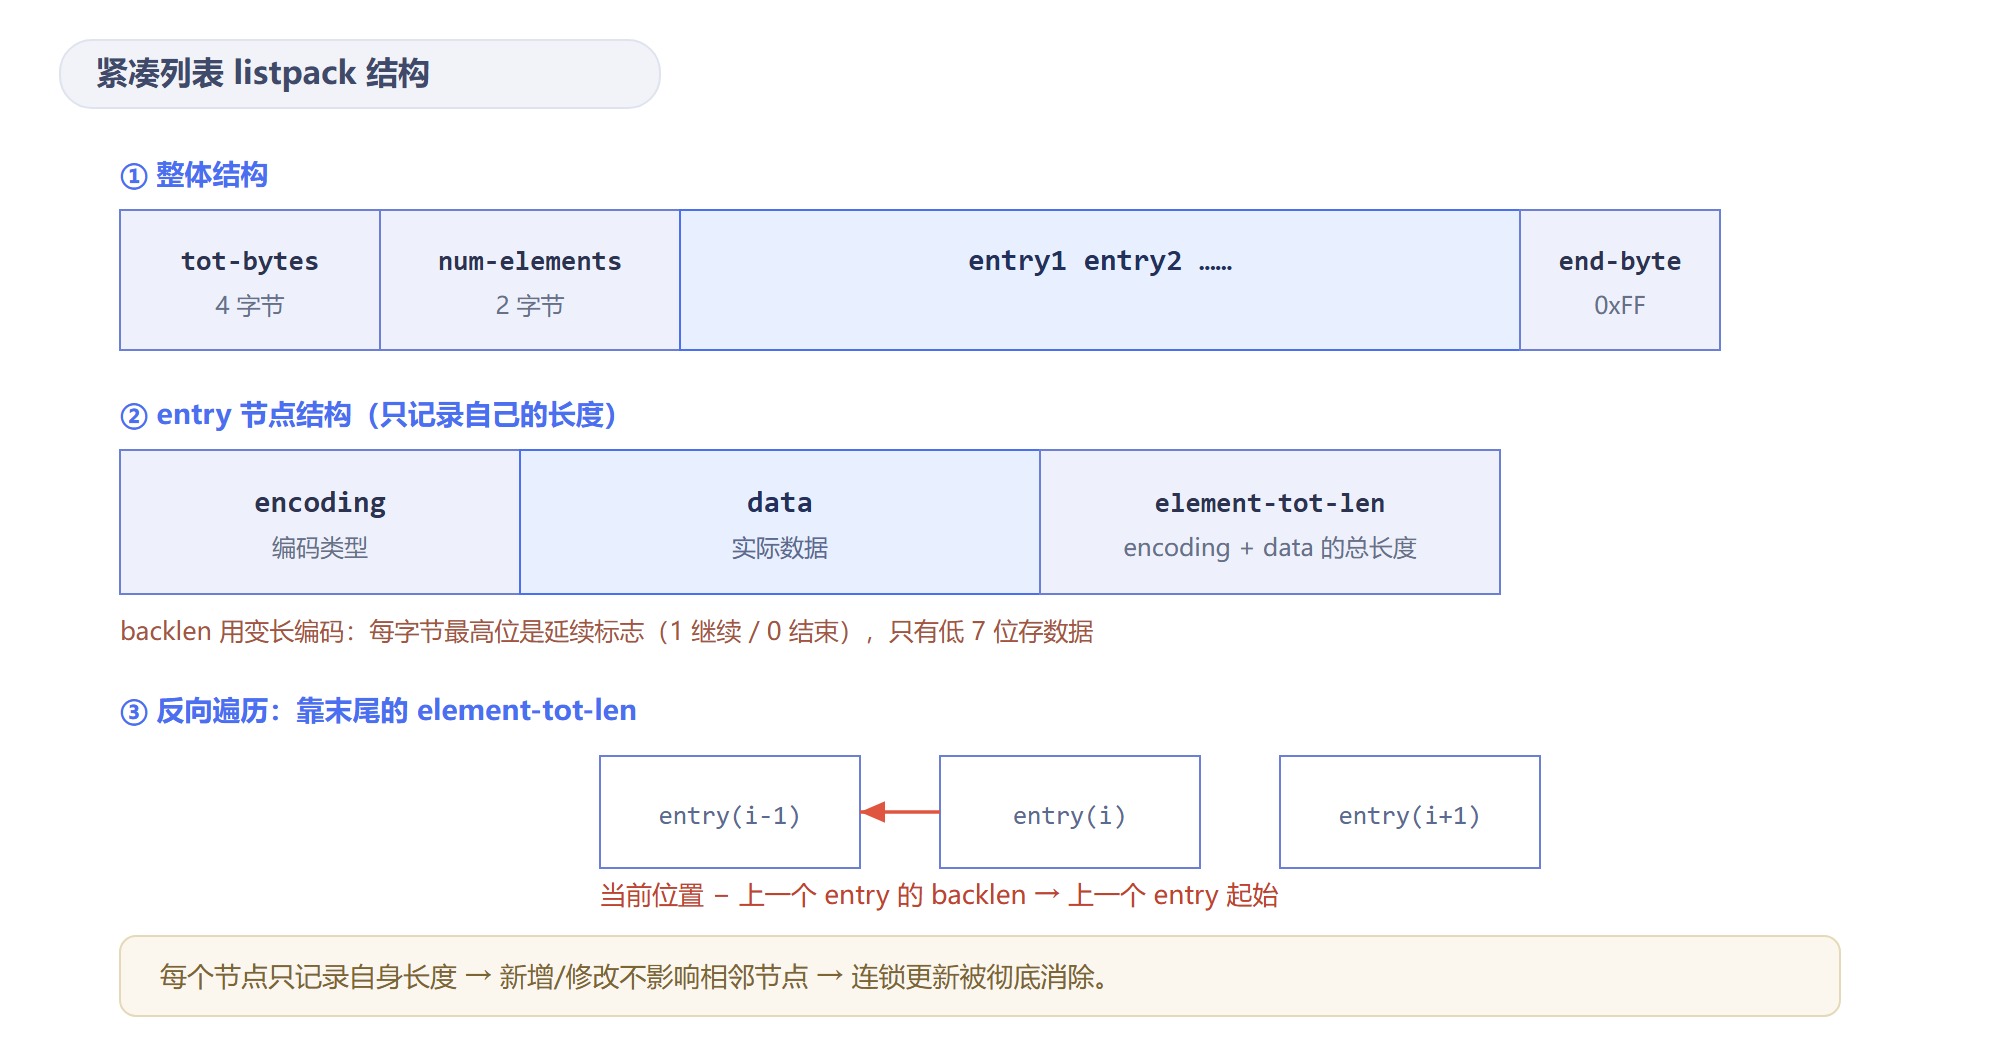
- tot-bytes:整个 listpack 的总字节数(4 字节,最大 4GB)。
num-elements:元素个数(2 字节)。注意:这不代表最多只能存 65535 个,当元素数 ≥ 65535 时该字段被置为 65535,此时要获取真实个数需要遍历整个 listpack。- end-byte:结束标识,固定
0xFF。
entry 的结构
listpack 的 entry 由 encoding、data、element-tot-len 三段组成:
- encoding:定义该元素的编码类型,会对不同长度的整数和字符串进行编码。
- data:实际存放的数据。
element-tot-len:encoding + data的总长度(不包含element-tot-len自身),最多占 5 字节。
关键区别就在于:listpack 的每个节点只记录「自己的长度」,而不是「前一个节点的长度」。 这样一来,新增或修改元素时只会涉及节点自己的操作,不会影响后续节点的长度变化,连锁更新问题就被彻底消除了。
那它还能像链表一样从后往前遍历吗
去掉 prevlen 之后,一个自然的问题就来了:listpack 不再记录前一个节点有多长,那它还怎么从后往前走?如果不能前后遍历,它就没法当链表用,也就不能替代 ziplist 了。
Redis 的解法是末尾那个 element-tot-len(源码里叫 backlen),它用了一种特殊的变长编码:每个字节的最高位是延续标识——0 表示这是长度字段的最后一个字节,1 表示还要继续往前读;每个字节只有低 7 bit 是有效数据。正因为带了延续标识,才能从后往前一个字节一个字节地把长度解析出来。
于是反向遍历的完整过程是(对应源码里的 lpPrev + lpDecodeBacklen):
- 给定当前 entry 的起始地址 p,先往前退 1 个字节到
p-1——这个位置是上一个 entry 的 backlen 字段的最后一个字节; - 从
p-1开始逐字节往前解码:读一个字节,若最高位是 1 就继续往前读下一个,直到遇到最高位为 0 的字节为止,拼出上一个 entry 的总长度 backlen,同时也知道了 backlen 字段自己占了几字节(1~5 字节); - 用
p − 1 − backlen 字段的字节数 − backlen,就落到上一个 entry 的起始地址; - 在这个起始地址上读
encoding,就能解析出这个 entry 存的数据(value); - 把"上一个 entry 的起始地址 − 1"作为新一轮的
p-1,重复上述过程,即可一路从后往前遍历。
一句话概括:先解码出"上一个 entry 有多长",再按这个长度往前跳,落到它的开头读数据;而它开头的前一个字节,正好又是再上一个 entry 的 backlen 末尾——就这样一环扣一环地往前走。而正向遍历更简单——靠 encoding 算出整个 entry 的长度,往后跳即可。
所以 listpack 和 ziplist 的区别,可以概括成一句话:
| 对比项 | ziplist | listpack |
|---|---|---|
| 节点记录的是 | 前一个节点的长度(prevlen) |
自己的长度(element-tot-len) |
| 反向遍历 | 靠 prevlen |
靠 element-tot-len 的延续位逐字节解析 |
| 连锁更新 | 存在 | 不存在 |
| 关系 | 老方案 | 在不牺牲反向遍历的前提下,把 ziplist 最疼的那个缺陷修掉 |
这是一次典型的"补丁式"演进:没有推翻"连续内存 + 紧凑编码"这条路,只把"记录前一个长度"改成"记录自己的长度",既保住了双向遍历,又根除了连锁更新。
版本差异:listpack 在 Redis 5.0 先被用于 Stream;7.0 起取代 ziplist,成为 Hash、ZSet 的紧凑编码以及 quicklist 节点的内部容器;7.2 起又新增为 Set 的紧凑编码。
2.5 quicklist:列表的折中方案
为什么需要 quicklist
对于 List 类型来说,纯双向链表和纯 ziplist 都不完美:
- 纯双向链表:两端操作快,但每个元素两个指针,内存开销大、碎片多。
- 纯 ziplist:省内存,但元素一多查找慢、插入还可能触发连锁更新。
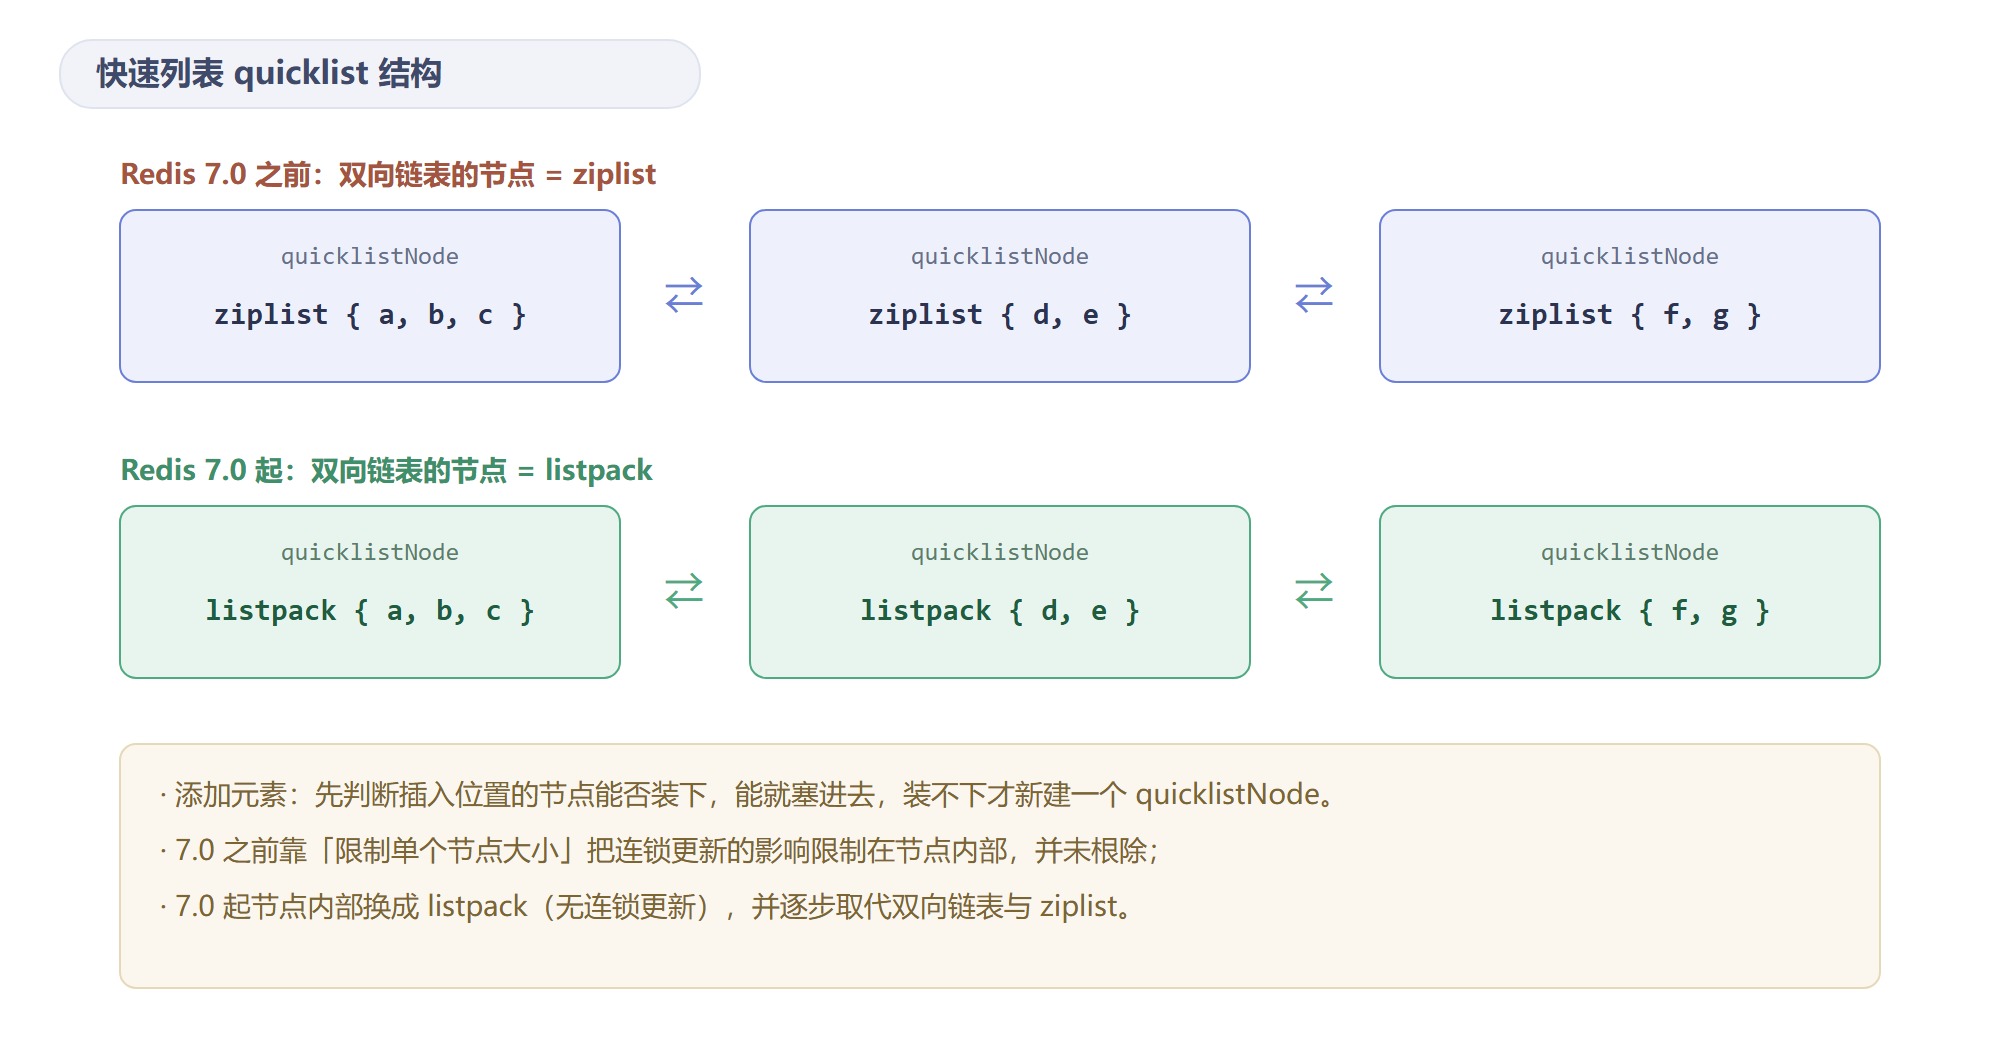
quicklist 的思路是把两者结合:外层是一个双向链表,链表的每个节点内部装一个 ziplist(7.0 起换成 listpack)。
结构
1 | typedef struct quicklist { |
⚠️ 版本差异:上面
zl是 Redis 7.0 之前的字段;Redis 7.0 的节点改用entry指针,普通 packed 节点保存的是 listpack。代码按旧版(ziplist)说明,理解思路一致。
结构示意(含 7.0 前后对比):
它怎么缓解 / 解决连锁更新
7.0 之前:靠控制每个 quicklistNode 的压缩列表大小和元素数量,让单个 ziplist 不会太大,从而把连锁更新的影响范围限制在单个节点内部,降低整体影响。但本质上并没有完全消除。
7.0 之后:节点内部换成 listpack,listpack 本身就没有连锁更新问题,于是彻底解决。
添加元素时的处理逻辑也是关键:向 quicklist 添加元素时,不会像普通链表那样直接新建一个链表节点,而是先检查插入位置的压缩列表能否容纳该元素——能容纳就直接存进去,不能容纳才新建一个 quicklistNode。
quicklist 的演进
一路变化可概括为三个阶段:≤ 3.0 List 的编码是 ziplist 或 linkedlist(二选一);3.2~6.x 统一成 quicklist,即「双向链表,节点是 ziplist」;7.0+ 仍是 quicklist,但节点内部换成了 listpack(小 List 也可直接用 listpack)。
一句话总结这一路的演进:从"链表 + 压缩列表"到 quicklist(把压缩列表切成小段挂在链表上,缓解连锁更新),再到把压缩列表整体换成 listpack(彻底消除连锁更新),最后 List 的底层全部统一到 listpack 系结构上。
2.6 hashtable:哈希表
数据量一大,查找效率必须提上来,这时就要用哈希表(dict)。
结构
1 | typedef struct dictht { |
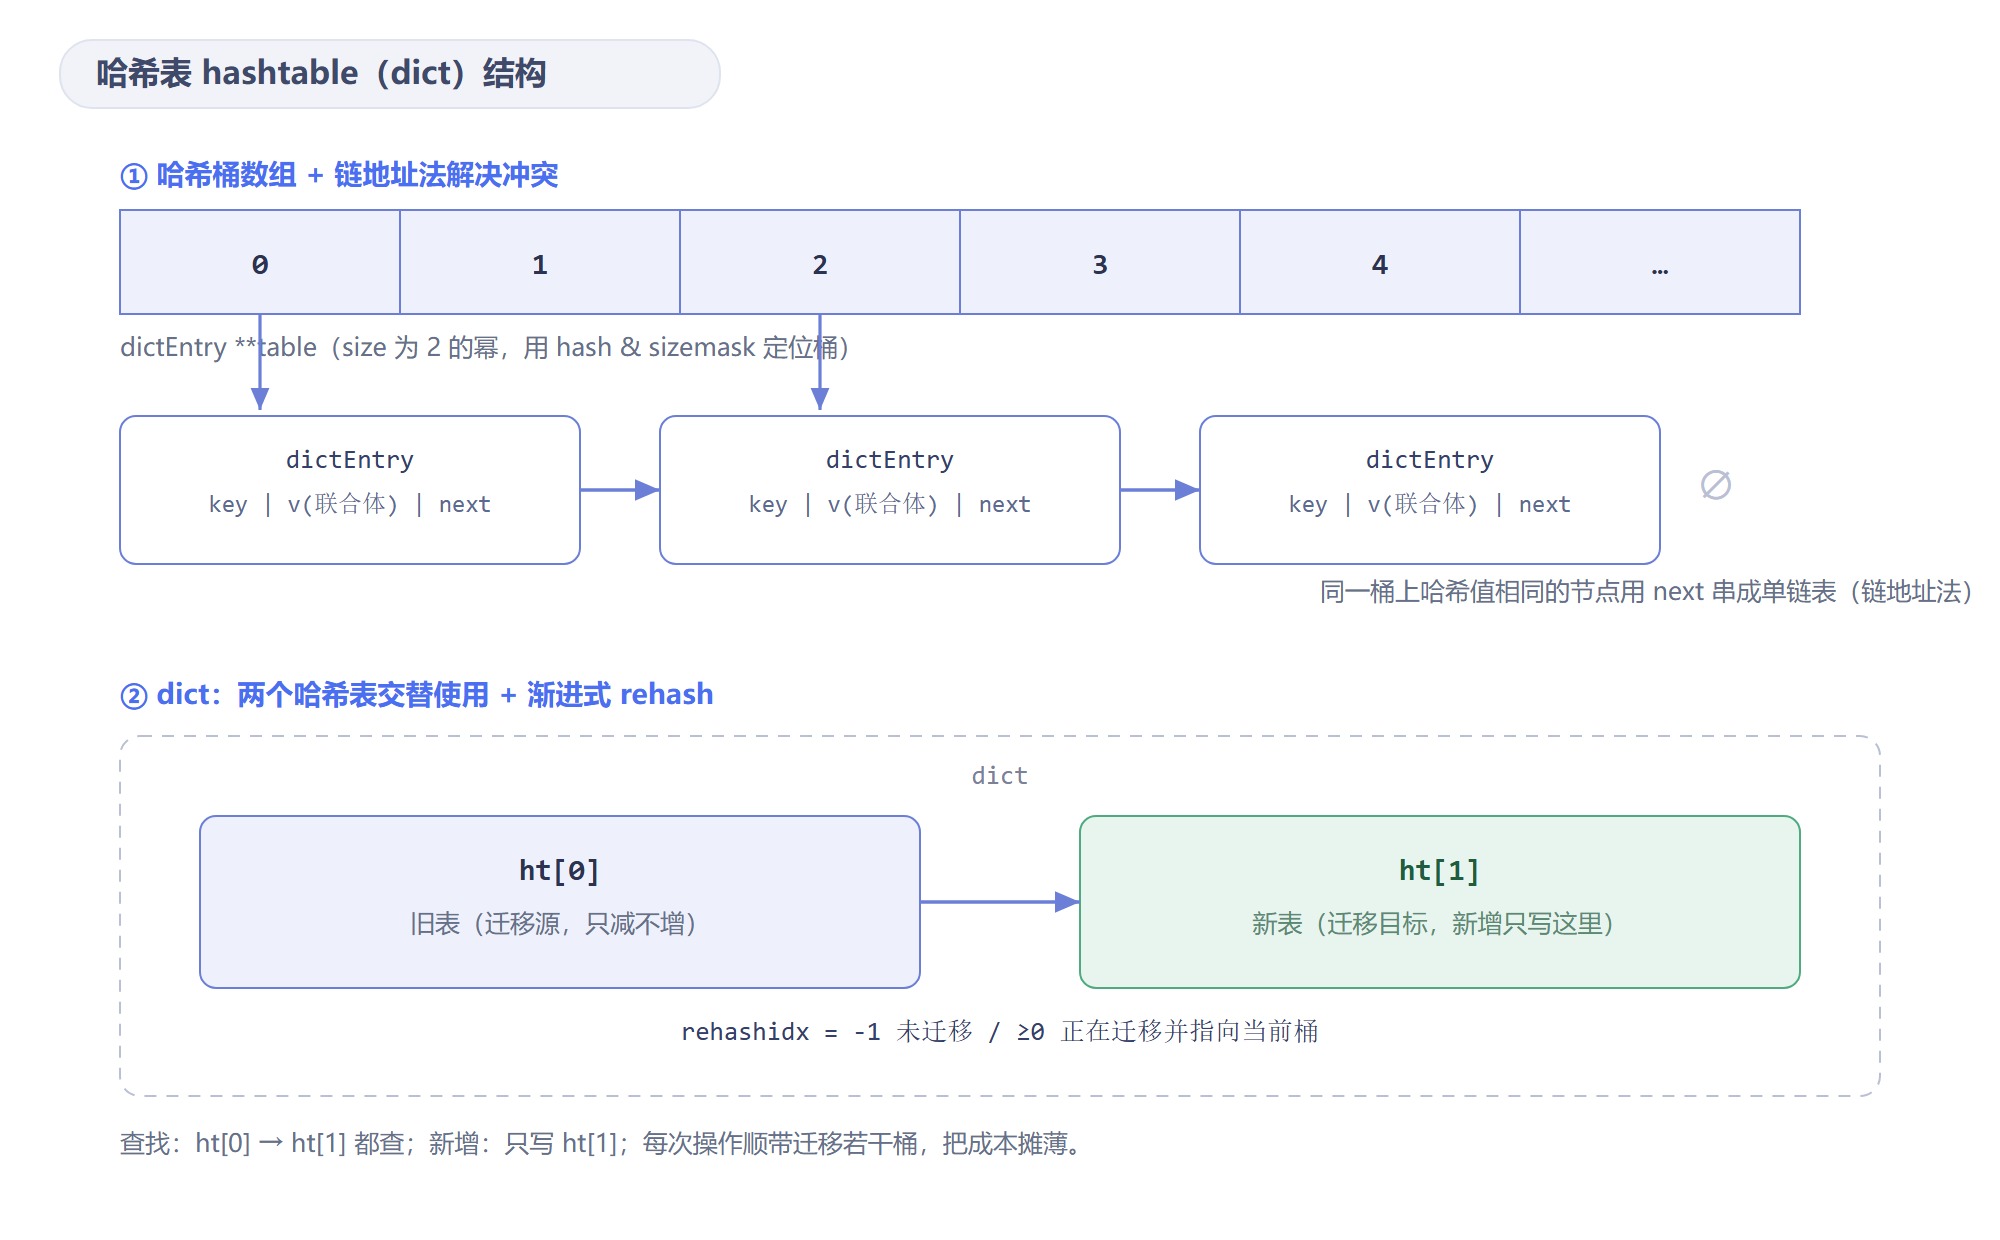
结构示意(上半部分为哈希桶数组 + 链地址法,下半部分为 dict 的双表结构):
值为什么用联合体
dictEntry 里的值不是简单的 void *,而是一个联合体 v,可以是 void * 指针,也可以直接是无符号/有符号 64 位整数或 double。好处是省内存:当「值」是整数或浮点数时,可以直接把值内嵌在 dictEntry 结构里,不必再用一个指针去指向另一块内存。
哈希冲突与链地址法
哈希表用一个哈希函数把任意长度的 key 映射到有限大小的桶数组上,不同的 key 算出同一个下标是必然的——这就是哈希冲突。Redis 解决冲突用的是链地址法(拉链法):dictEntry 里的 next 指针把同一个桶上的多个节点串成一条单链表。
举个具体的例子。假设哈希表 size = 8,那么 sizemask = 7,某个 key 落在哪个桶由 hash(key) & 7 决定:
1 | hash("user1") & 7 = 3 |
于是桶 3 上就形成一条链表:桶[3] → user9 → user1 → ∅(新节点插在链表头部,保证插入是 O(1))。
之后查找 user1 时,流程是:先用 hash("user1") & 7 定位到桶 3,再沿着这条链表逐个比较 key,直到找到 user1。所以链地址法的查找复杂度 = 定位桶 O(1) + 遍历链表 O(k),k 是这条链的长度。
这就引出了下一个问题:如果冲突太多,链表越拉越长,查找就会退化成 O(N)。这时就需要扩容,而扩容的关键机制就是 Redis 非常巧妙的渐进式 rehash。
渐进式 rehash
先看 dict 的结构:
1 | typedef struct dict { |
其中 ht[0]、ht[1] 与 rehashidx 的含义见上文哈希表结构图的下半部分。
普通"一次性拷贝"的问题:如果直接把一张哈希表里所有值逐个重新运算、插入到新表,当哈希表数据量很大时,会进行大量的数据拷贝,导致 Redis 主进程被阻塞。Redis 是单线程模型,这种卡顿对线上影响很大。
渐进式 rehash 的优化:
- 触发 rehash 时,先给
ht[1]分配好空间,此时rehashidx不再是 -1。 - 之后每次对这个哈希表进行操作时,Redis 除了执行对应命令,还会顺带按顺序把
ht[0]里的数据迁移一部分到ht[1],并把rehashidx往前推。 - 查找操作在两张表中都进行查询(先查
ht[0],再查ht[1]);新增只在新哈希表ht[1]做。 - 随着操作越来越多,最终整个
ht[0]完成迁移,再把ht[1]提升为ht[0],回收旧表。
流程如下:
flowchart TD
    A[触发 rehash] --> B[给 ht1 分配新空间]
    B --> C[rehashidx 置 0,开始逐步迁移]
    C --> D{每次对 dict 的增删改查}
    D --> E[顺带迁移 ht0 中若干桶到 ht1]
    E --> F[rehashidx 前移]
    F --> G{ht0 是否迁移完?}
    G -->|否| D
    G -->|是| H[ht1 提升为 ht0,释放旧表]
H --> I[rehashidx 置 -1]这样就把昂贵的迁移成本摊薄到了每一次操作上,避免了一次性阻塞——这就是"渐进式"的精髓。
rehash 的触发条件与负载因子
rehash 是否触发,和负载因子有关:
1 | 负载因子 = 哈希表已存的节点数量 / 哈希表大小(used / size) |
| 场景 | 触发条件 | 说明 |
|---|---|---|
| 扩容 | 负载因子 ≥ 1,且没有在执行 BGSAVE / BGREWRITEAOF |
也就是没有在执行 RDB 快照或 AOF 重写时,才扩容 |
| 强制扩容 | 负载因子 ≥ 5 | 哈希冲突非常严重了,不管有没有在执行 RDB/AOF,都强制 rehash |
| 缩容 | 负载因子 < 0.1 | 空间浪费太多时收缩 |
为什么"执行 BGSAVE / BGREWRITEAOF 时尽量不扩容"?因为这两个命令会 fork 子进程,父子进程通过写时复制(Copy-On-Write)共享内存页。如果此时扩容,会大量修改内存,触发大量页复制,反而更费内存。所以负载因子不到 5 时,Redis 会尽量不扩容。
2.7 intset:整数集合
结构
如果 Set 里存的都是整数,用哈希表就太浪费了——每个整数都要一个 dictEntry(两个指针 + next 指针)。用一个有序的整数数组就够了,既省内存,又能二分查找。
1 | typedef struct intset { |
结构示意:
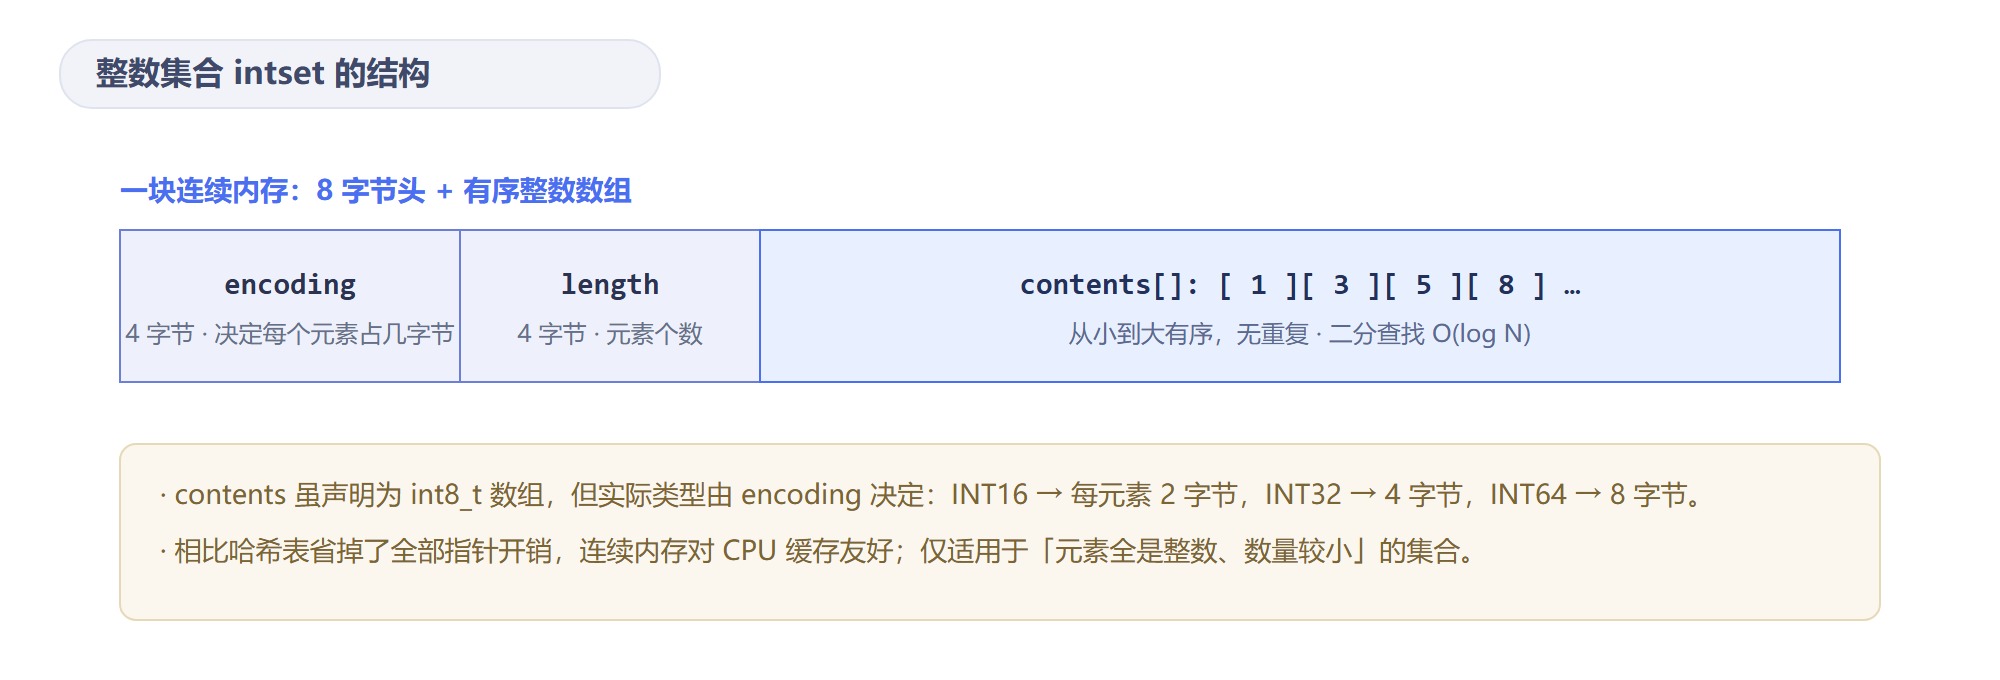
它也是一块连续内存。注意:contents 虽然被声明为 int8_t 数组,但实际上并不保存任何 int8_t 类型的元素——数组的真正类型取决于 encoding 的值:
| encoding | contents 实际类型 |
|---|---|
INTSET_ENC_INT16 |
int16_t 数组,每个元素 16 位 |
INTSET_ENC_INT32 |
int32_t 数组,每个元素 32 位 |
INTSET_ENC_INT64 |
int64_t 数组,每个元素 64 位 |
升级机制
整数集合有一条升级规则:当往集合里加入一个新元素,如果新元素的类型比集合现有所有元素的类型都要长(例如现有都是 int16_t,新元素是 int32_t),整数集合需要先升级——按新元素的类型扩展 contents 数组的空间大小,然后才能把新元素加进去,并且升级过程中要维持元素的有序性。
关键点:升级不会重新分配一个新类型的数组,而是在原本的数组上扩展空间,再把每个元素按新类型大小重新分割、挪位。
升级过程举例(原地转换)
假设现在有一个整数集合,里面有 3 个 int16_t 元素:[1, 3, 5]。现在要插入 70000,它超过了 16 位的表示范围(int16_t 最大 32767),需要升级为 int32_t——整个过程如下图所示:
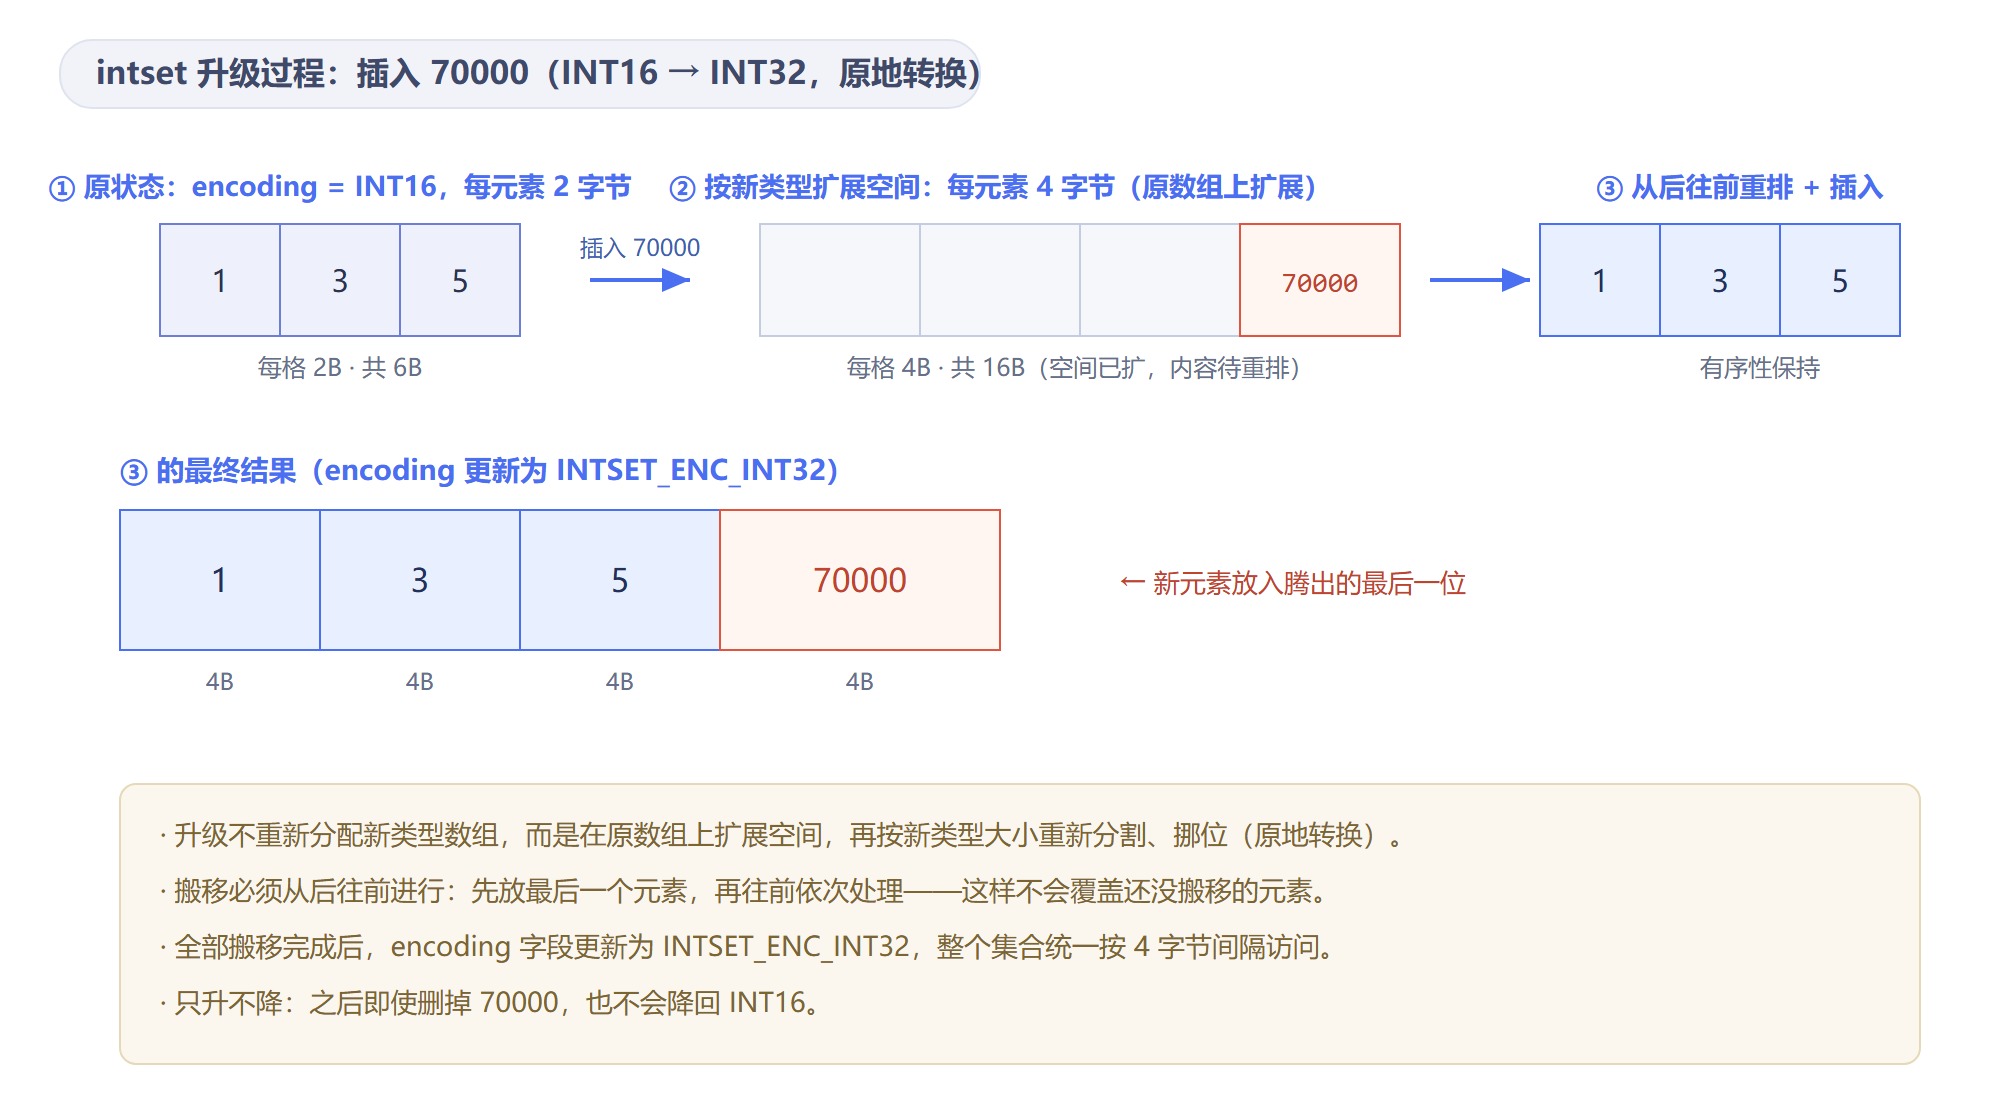
如图分三步:① 原数组每个元素只占 2 字节;② 按新类型把数组扩展成每元素 4 字节(共 4 个元素 16 字节);③ 从后往前把原元素按 4 字节间隔重新排位(从后往前是为了防止覆盖还没搬移的元素),腾出的最后一位放入新元素,encoding 更新为 INTSET_ENC_INT32。
升级的步骤归纳为:
- 根据新元素类型,扩展
contents数组空间; - 把原有元素从后往前依次转换成新类型并放到正确位置(从后往前是为了防止覆盖);
- 修改
encoding字段为新类型。
为什么只升级、不降级
整数集合升级之后不支持降级:即使你删掉了那个 int64 的元素,整个集合只剩 int32 了,也不会降级。
原因:降级需要重新遍历、搬移数据,成本不低;而且如果之后又插入大数,还得再升回来,来回折腾不划算。所以设计成"只升不降",牺牲一点空间换实现简单与性能稳定。
适用场景
| 维度 | 说明 |
|---|---|
| 省内存 | 相比哈希表,省掉了大量指针和额外属性开销 |
| 缓存友好 | 连续内存,CPU 缓存利用率高 |
| 适用前提 | 数据量比较小、且必须是整数 |
| 转换 | 一旦出现非整数元素或数量超限,转为 hashtable(或 7.2+ 的 listpack),且不可逆 |
2.8 跳表:ZSet 的核心结构
问题:既要 O(log N) 查找,又要支持范围查询
ZSet(有序集合)需要同时满足:按 score 排序、支持 ZRANGE 这类范围查询、支持 ZRANK 查排名,并且增删查改都是 O(log N)。
有序数组查询快但插入慢;普通链表插入快但查询慢。跳表(skiplist)就是在两者之间找平衡的方案。
结构:多层链表 + 随机层高
先用一张直观的图理解跳表的核心思想——在链表上"加索引":
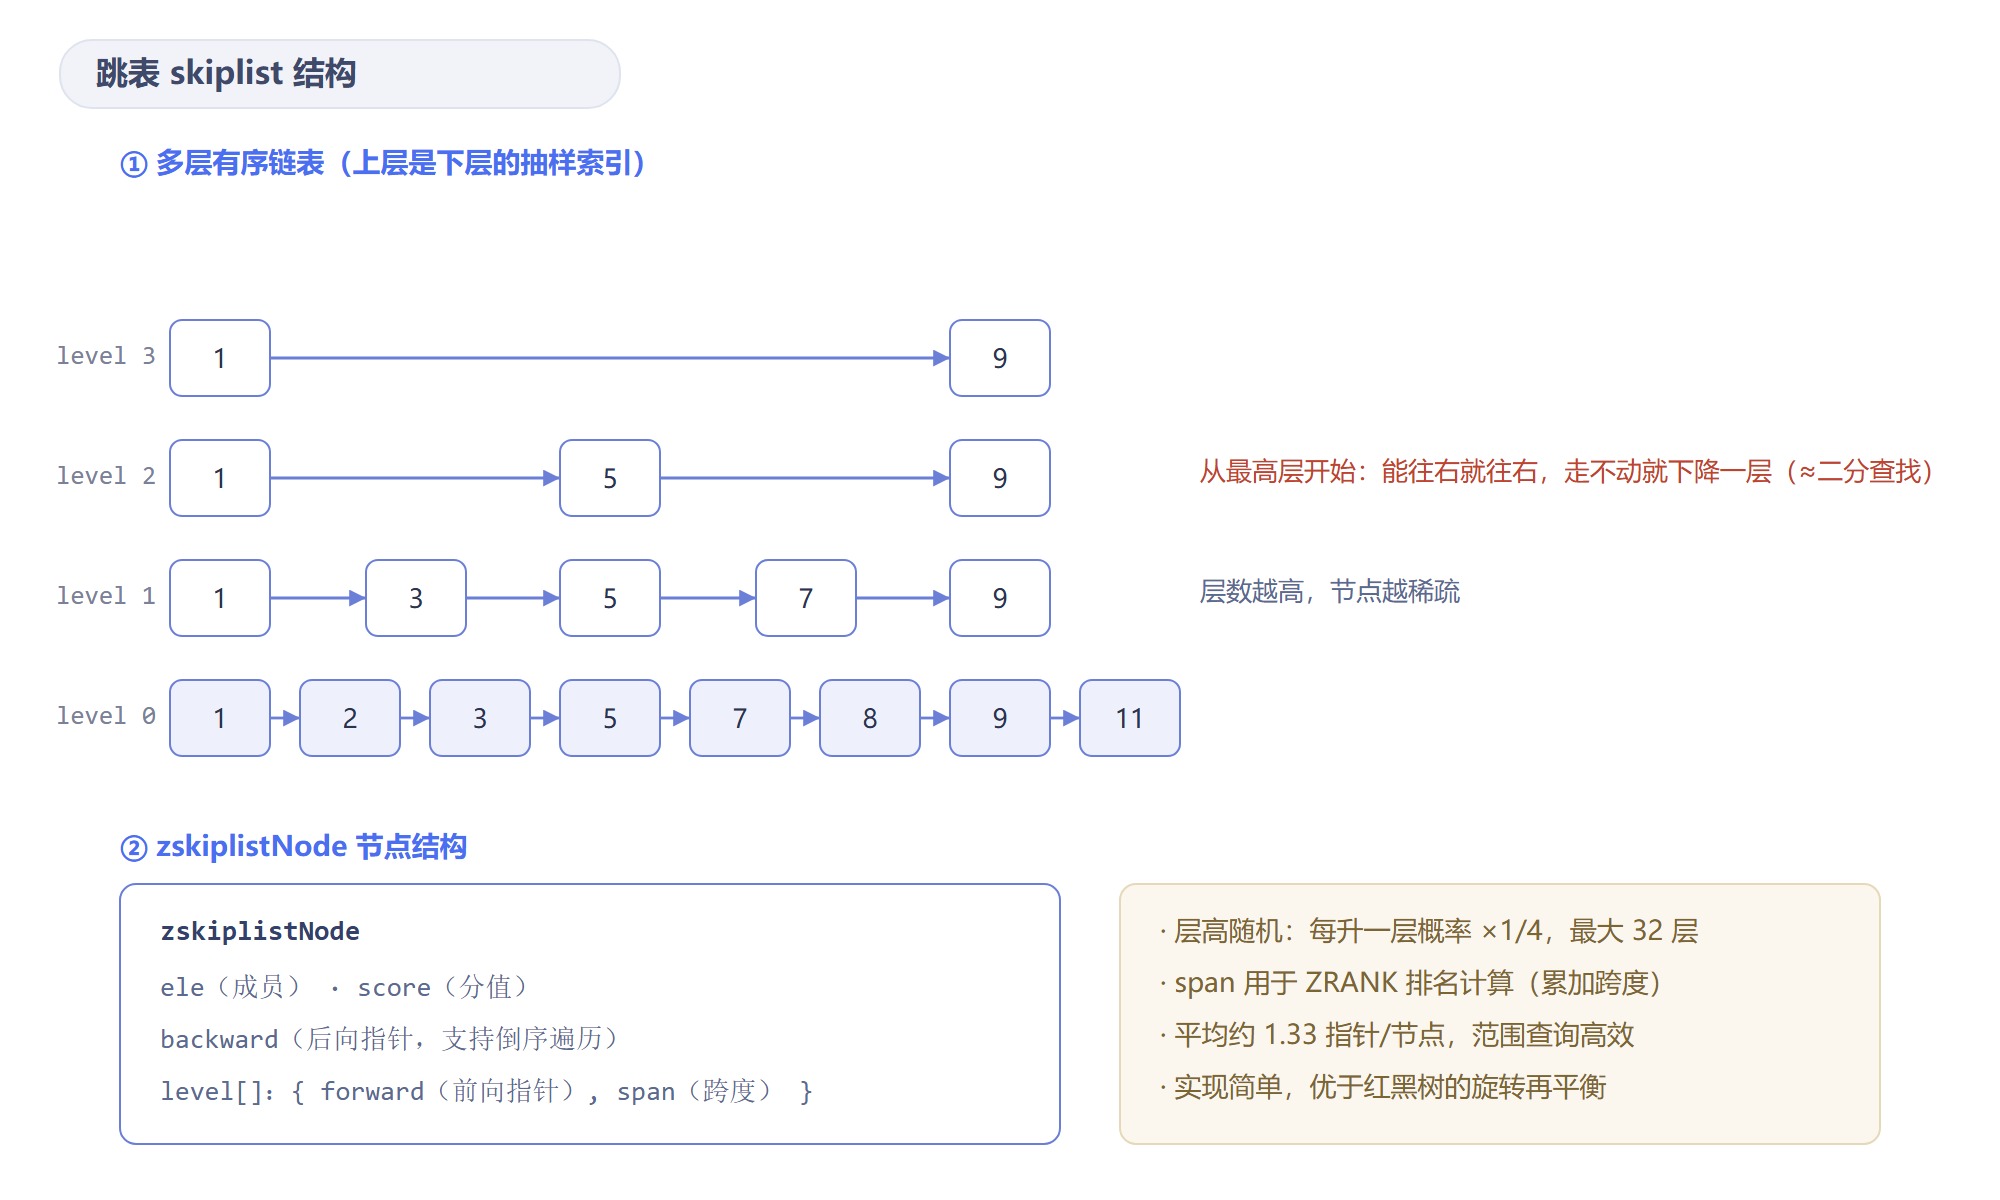
- 最底层(level 0)是完整的、有序的全量链表;
- 上面每一层都是下一层的"抽样索引",层数越高节点越稀疏;
- 查询时从最高层开始,能往右就往右,走不动就下降一层,平均复杂度 O(log N)。
先看它的节点结构体:
1 | typedef struct zskiplistNode { |
对照结构体可以看到,Redis 在标准跳表上做了三处改造:
backward后向指针:普通跳表只有前向指针,Redis 额外加了后向指针,方便从尾结点反向遍历(支撑ZREVRANGE)。span跨度字段:每层除了forward还记录"到下一个节点跨过了几个节点",查排名时靠它累加即可(支撑ZRANK)。- 随机层高:每个节点有几层,是插入时随机决定的,下一节详细说。
节点层数是怎么来的(这一点很重要)
首先要澄清一个关键点:随机只发生在"插入某个新节点"的那一刻,且只决定这一个节点自己的层数——不是每次插入都对整个跳表重新随机,已有节点的层数在插入后就固定不变了。
随机的过程类似"逐层抛硬币",以插入元素 5 为例:
- 第 1 层必中——任何节点都一定存在于第 1 层(也就是结构图里的 level 0);
- 以 1/4 的概率决定有没有第 2 层:命中就继续;
- 再以 1/4 的概率决定有没有第 3 层:命中就继续;
- ……如此反复,直到某次没命中、或达到最大层数 32 为止。
假设元素 5 一路命中到第 3 层、第 4 次没命中,那么这个节点就同时存在于第 1、2、3 层——level 0、1、2 上都有它,其他节点完全不受影响:
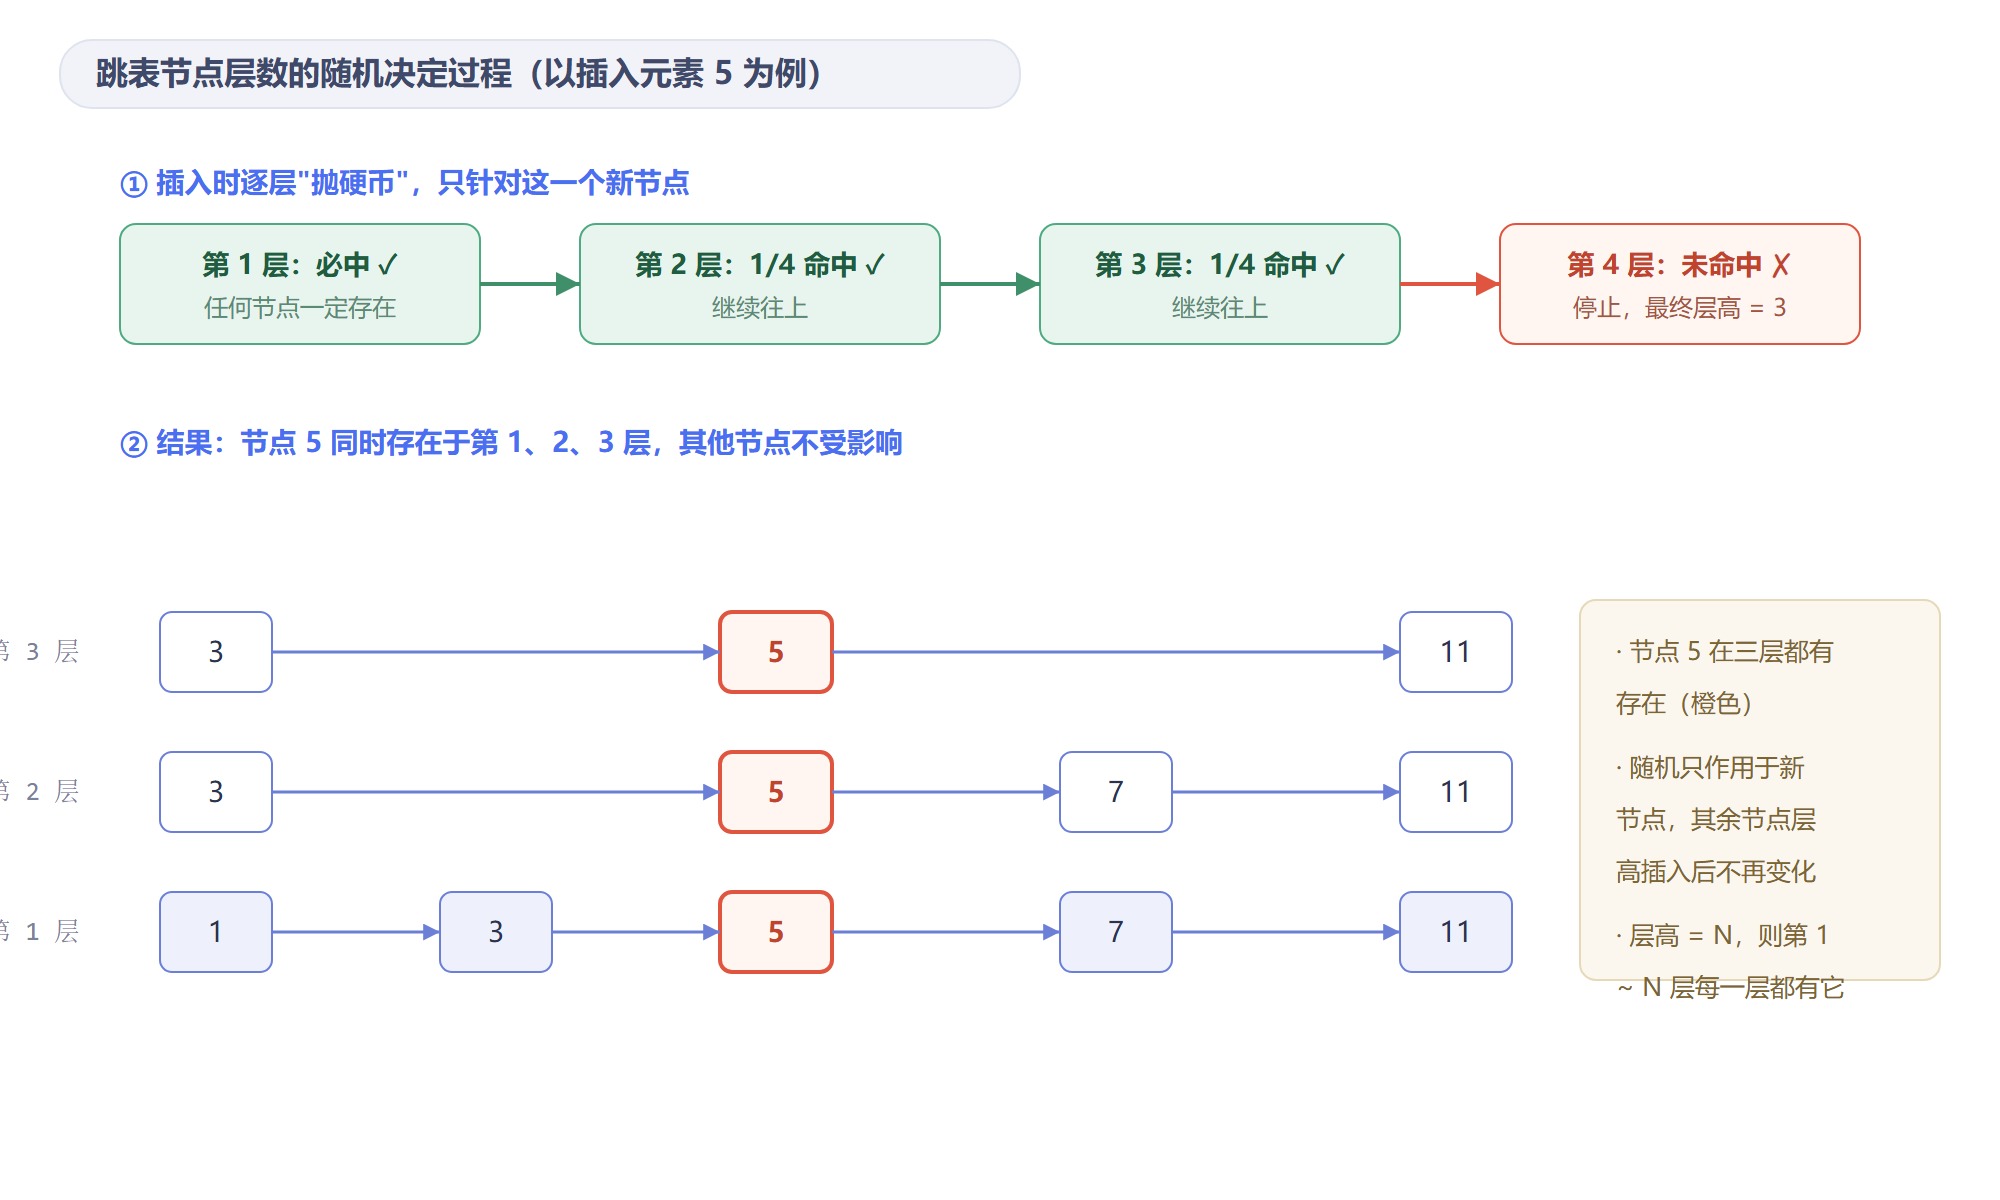
源码里对应 zslRandomLevel:
1 |
|
也就是:新节点初始 1 层,然后以 1/4 的概率往上加一层,一直叠加,最多到 32 层——随机出的层高是多少,这个节点就出现在从第 1 层到第 N 层的每一层上。
⚠️ 这里要纠正一个常见记法:这个概率是 1/4,不是 1/2。有些资料(尤其是其他语言的跳表实现)用的是 0.5,但 Redis 用的是 0.25。
举一组例子,假设依次插入 5 个节点,随机到的层数分别是:
| 节点 | 随机层数 |
|---|---|
| node1 | 3 |
| node2 | 1 |
| node3 | 2 |
| node4 | 1 |
| node5 | 4 |
可以看到大部分节点只有 1 层,少数节点被"提拔"到更高的层。因为每往上一层概率都乘 1/4,所以越高层节点越稀疏,自然形成了"索引层"。按这个概率分布,平均每个节点约 1.33 个指针。
为什么这样设计?
- 如果改用"严格每两个节点抽一个做索引",节点个数会严格减半、索引结构非常规整,但一旦插入/删除节点,就要重新调整后面所有节点来维持这个比例,复杂度直接退化到 O(N)。
- 用随机化的概率提升,插入/删除只需要改动局部指针,不需要全局重排;同时概率分布又保证了"高层稀疏",让查找期望复杂度稳定在 O(log N)。这就是跳表把"严格平衡"换成"概率平衡"的核心原因。
- 至于为什么概率取 1/4 而不是 1/2:P 越大,节点平均层数越高、索引越密,指针开销越大(P=1/2 时平均约 2 个指针/节点)。取 1/4 是内存与查询速度的折中,平均 1.33 个指针就能达到 O(log N)。
- 最大层数定为 32:源码注释称足以支撑 2^64 量级的元素规模;早期 Redis 5 是 64,Redis 6/7 降为 32,避免为极端规模浪费内存。
查询过程(举例)
光看结构不好理解"能往右就往右,走不动就下降一层",用一个具体例子走一遍。假设底层有序链表是 1 → 11 → 21 → 31 → 41 → 51 → 61,它的索引层是:
- level 2:
1 → 41 - level 1:
1 → 21 → 41 → 61 - level 0:
1 → 11 → 21 → 31 → 41 → 51 → 61
现在要查 51,从最高层(level 2)的头节点出发:
- level 2:当前在
1,往右是41,41 < 51,继续往右;再往右是 NULL,往右走不动了 → 下降一层; - level 1:当前在
41,往右是61,61 > 51(越过了目标),不能往右 → 下降一层; - level 0:当前在
41,往右是51,命中!
整个过程的比较路径是 1 → 41 → 61 → 51,大约 4 步。而如果直接在底层普通链表上从头找,要走 1 → 11 → 21 → 31 → 41 → 51 共 6 步。数据量越大,这个差距越明显——这就是"多层索引把查找近似成二分"的效果。
跳表在 ZSet 里负责什么
ZSet 的编码是 skiplist + hashtable,两者分工,跳表主要承担"有序 / 范围"这一类操作——而它能做到,正是因为上文那三个字段:
- 按 score 的范围查询(
ZRANGE、ZRANGEBYSCORE):level 0 本身就是一条有序链表,范围查找顺着这条链表扫即可。 - 排名查询(
ZRANK):靠span在查找路径上累加,就能算出这个元素排第几,不用真的遍历一遍。 - 倒序遍历(
ZREVRANGE):靠backward后向指针,从尾结点往回走。
为什么选跳表而不是红黑树
这是高频面试题,本质上是在问"有序结构为什么不用平衡树"。四点原因,每一点都对应 ZSet 的实际需求:
- 范围查询更自然:跳表的 level 0 是物理相邻的有序链表,范围查询顺着走即可;红黑树是树形结构,节点之间没有相邻关系,做范围查询要走中序遍历、还要反复找前驱/后继,实现更绕、常数更大。
- 实现更简单:红黑树插入/删除要处理左旋、右旋、节点变色、双黑修正等一整套规则;跳表只改查找路径上的局部指针,不需要全局再平衡,代码量和出错面都小得多。Redis 作者 antirez 也公开表示过,跳表更简单、更易维护和扩展。
- 内存更省:红黑树每个节点要存颜色(以及父/孩子指针)来维持平衡;跳表靠 1/4 概率的层高分布控制指针数量,平均约 1.33 个/节点。
- 可维护、并发友好:跳表逻辑直观、易调试,修改更"局部"(只动相邻几个节点),并发时锁的范围更小,这也是 LevelDB 等系统选择跳表的原因之一。
一句话总结:不是红黑树做不到,而是在"需要频繁范围查询和排名"这个前提下,跳表实现更简单、内存更省、范围扫描更自然,综合胜出。
为什么 ZSet 同时用跳表和哈希表
ZSet 的编码写的是"skiplist + hashtable",因为两个结构各司其职:
- 跳表:负责按 score 的范围查询和排名(
ZRANGE、ZRANK),O(log N); - 哈希表 dict:负责按 member 查 score(
ZSCORE),O(1)。
1 | typedef struct zset { |
如果只有跳表,ZSCORE 就得 O(log N);如果只有哈希表,范围查询就没法做。两者结合,才能同时高效支持范围查询和单点查询——这是单一索引结构很难达到的效果。
三、五大基本类型:编码、命令与业务场景
前面讲了八种"积木",这一节把它们拼回五大基本类型,并补上完整命令示例和真实业务场景——学底层不是为了炫技,而是为了选对工具。
3.1 String(字符串)
底层编码
SDS。三种编码——int(整数,直接内嵌在 ptr 里)、embstr(≤ 44 字节)、raw(> 44 字节)。
编码切换:整数走 int;长度 ≤ 44 字节走 embstr;超过 44 字节转 raw(可用 OBJECT ENCODING key 验证)。
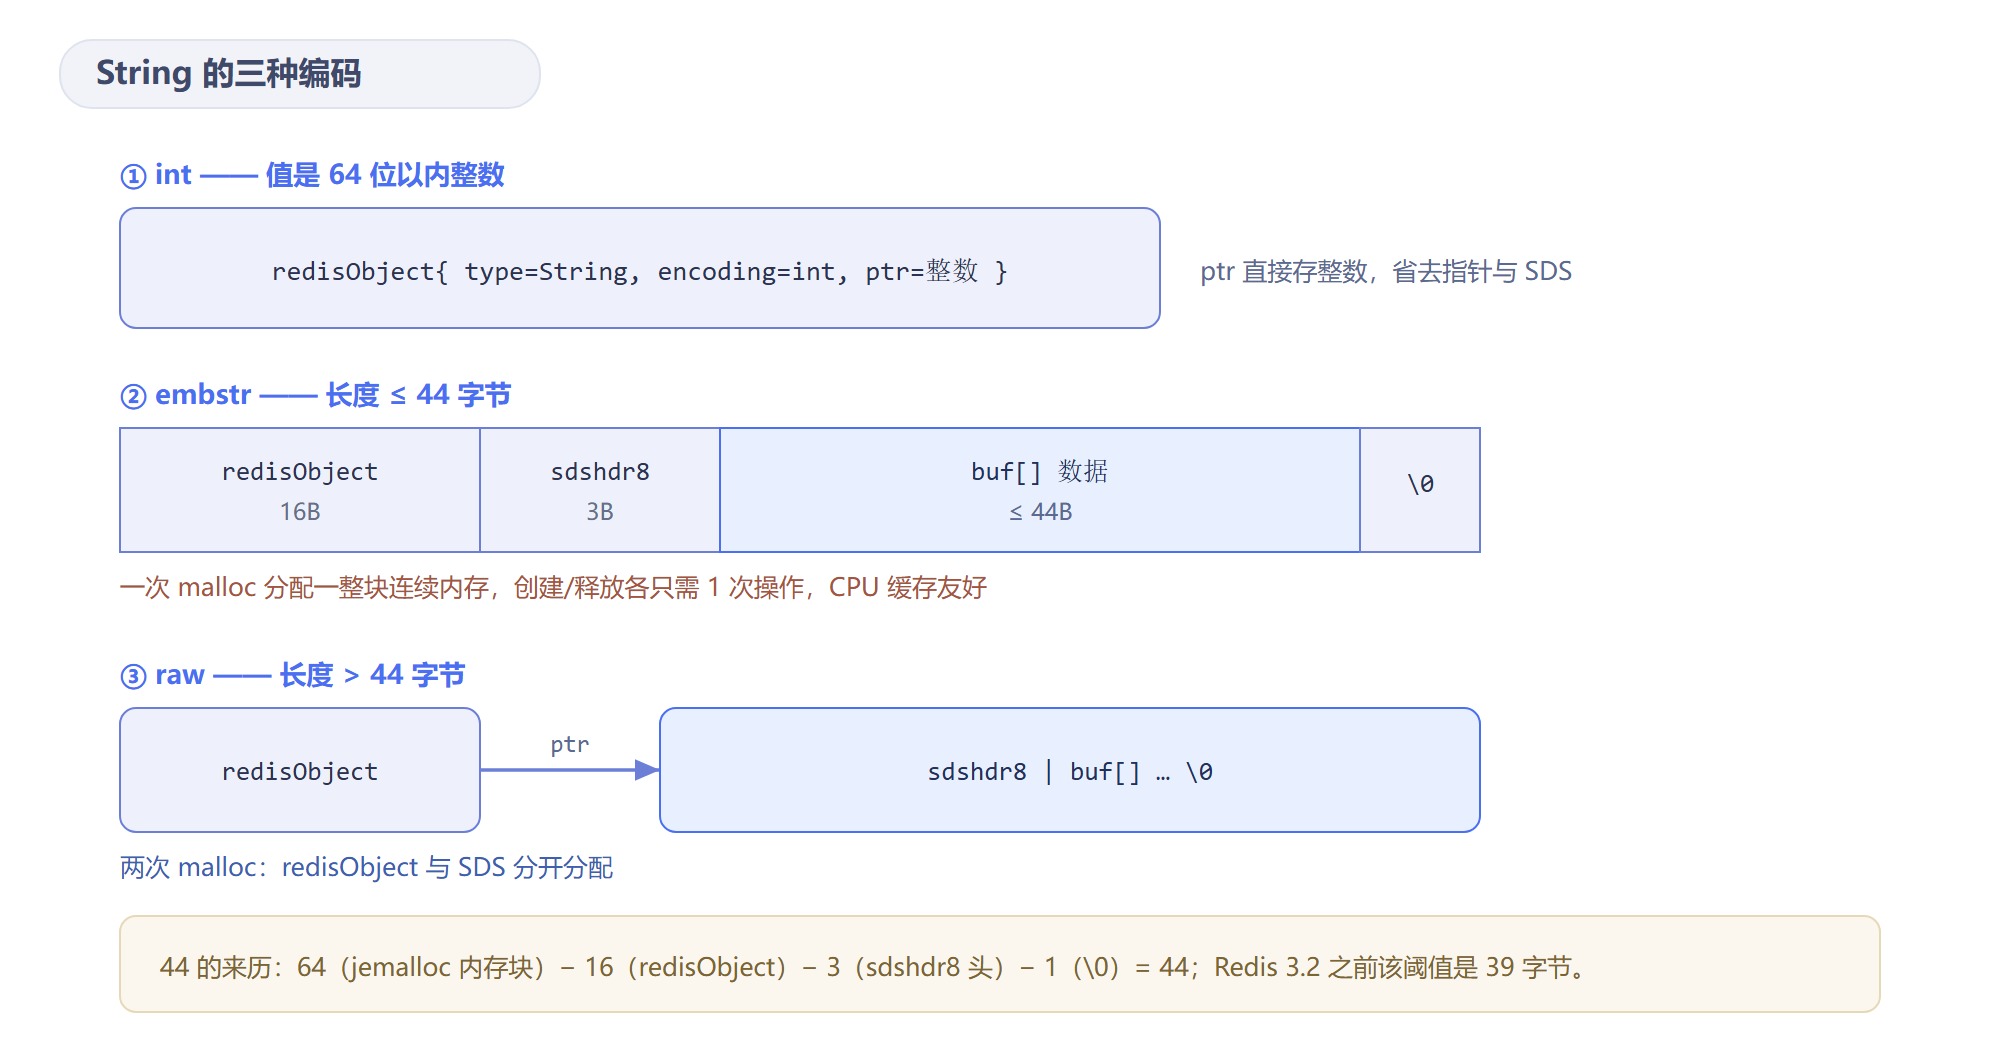
三种编码的内存布局各有不同:
int:值本身就是一个 64 位有符号整数(如SET age 20),Redis 直接把这个整数塞进redisObject的ptr指针字段里(把指针当 8 字节的 long 用),不再分配任何 SDS。所以int编码的对象只有redisObject本身,没有第二块内存。embstr:值是 ≤ 44 字节的短字符串。Redis 用一次内存分配拿下一块连续内存,里面依次放着redisObject(16 字节)+ SDS 头sdshdr8(3 字节)+ 字符串内容 + 结尾\0,ptr直接指向同一块内存里的 SDS。之所以上限是 44,是因为 jemalloc 按 64 字节的规格分配,64 − 16 − 3 − 1 = 44。raw:值 > 44 字节。一块 64 字节的内存装不下 SDS 了,Redis 改为两次分配:一块给redisObject,另一块(按需扩容)给 SDS,ptr在两者之间做桥梁。
为什么这样设计
三种编码本质上是在"为不同大小的值匹配不同成本的内存方案":
- 整数为什么单独走
int:计数器、年龄、库存这类值几乎全是整数,如果也走 SDS,就要为"存一个 8 字节的数字"额外分配一块带头部的字符串内存,还要在读取时做一次指针解引用。直接内嵌进ptr后,零额外分配、零解引用,INCR时改的就是指针本身。 - 短字符串为什么用
embstr:短字符串数量最庞大(用户名、状态标记、JSON 里的小字段),embstr把对象头和 SDS 拼成一块连续内存,带来三个好处——创建/释放只调一次分配器;对象头和数据的内存地址相邻,CPU 缓存一次就能全部载入;没有指针跳转。而且 embstr 被设计为只读:SET之后不做原地修改,要改就整个重建,省掉了 SDS 里alloc预分配那套动态扩容逻辑的开销。 - 长字符串为什么退回 raw:超过 44 字节后连续小块装不下,而且长文本往往还会继续增长(追加、修改),这时 SDS 的空间预分配和惰性释放就有价值了,两次分配的固定开销相对于数据本身已经可以忽略。
完整命令示例
1 | # 1) 存整数 → int 编码 |
业务场景
| 业务场景 | 典型命令 | 说明 |
|---|---|---|
| 商品详情页缓存:把整个商品对象序列化成 JSON 存一个 String,读时命中直接返回,避免每次都查 MySQL | SET cache:product:1001 "{...}" EX 600 / GET |
读多写少时最省事 |
| 文章阅读量/视频播放量:每被访问一次就加一,要求并发下不丢计数 | INCR article:1001:views |
原子自增 |
| 接口限流:限制某用户/IP 每分钟最多请求 100 次 | INCR limit:user:88 + EXPIRE limit:user:88 60 |
固定窗口计数 |
| 分布式锁:下单时保证同一订单不会被并发处理,且进程崩溃后锁能自动释放 | SET lock:order:1001 uuid NX EX 30 |
NX + EX |
| 分布式 Session:多台机器共享登录态 | SETEX session:abc 3600 "uid=1001" |
集中存储会话 |
注意:String 存对象时部分更新不方便(要整体读出再写回)。如果一个对象经常只改某个字段,考虑用 Hash。
3.2 List(列表)
底层编码
listpack(小 List)/ quicklist(大 List,双向链表 + listpack 节点)。
编码切换:小 List 直接用 listpack;元素变多、超出单个节点容量(由 list-max-listpack-size 控制)后由 quicklist 承载。
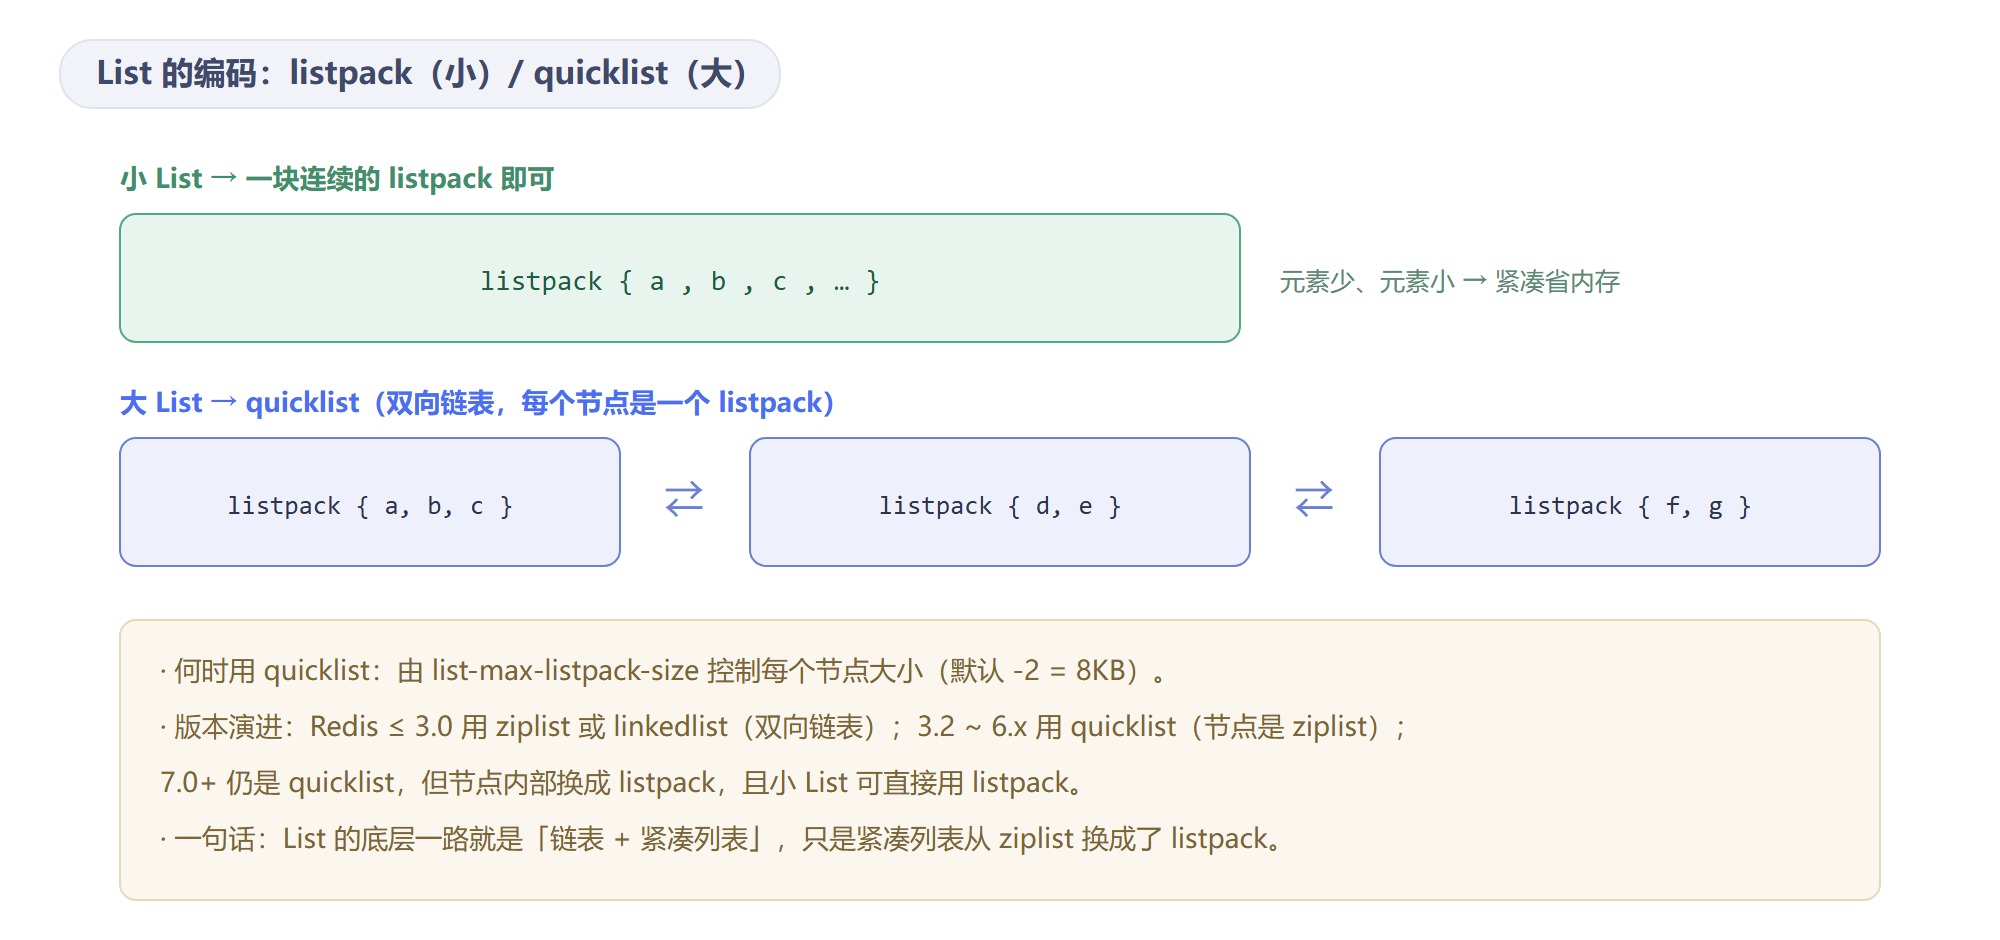
两种编码的形态完全不同:
listpack:整个 List 就是一块连续内存,元素按插入顺序一个挨一个排着,每个 entry 只存数据本身加很少的编码开销。适合元素少的小 List。quicklist:外层是一条双向链表,链表的每个节点(quicklistNode)内部装着一块 listpack。可以理解为"把一条长 listpack 切成若干小段,再用链表把小段串起来"。头尾节点挂着head/tail指针,所以两端操作只碰头尾两块小内存。
为什么这样设计
List 的操作特点是两端快插快删(队列、最新动态),两种"纯"结构各有一头不行:
- 纯双向链表:
LPUSH/RPOP确实 O(1),但每个元素都要单独 malloc 一个节点,节点里除了值还有 prev/next 两个指针——存一个几字节的值要付出十几字节的指针成本,而且节点内存不连续,缓存命中率差。 - 纯 listpack:省内存、缓存友好,但它本质是连续数组,任何一端插入都可能导致整块内存重分配和搬移;元素一多,单次插入的代价就失控了(旧版用 ziplist 时还有连锁更新风险)。
quicklist 的折中正好掐住两者的优点:两端操作只发生在头尾节点上,往头节点里塞元素,塞满了才新建一个节点挂到链表头部——单次操作只涉及一个几 KB 的小 listpack,不会搬移整个 List;而节点内部又是紧凑的 listpack,指针开销只按"节点"付、不按"元素"付。list-max-listpack-size(默认 -2 = 8KB)控制的就是每个节点的大小:节点越小,两端操作越轻快,但链表节点数越多;节点越大越省指针,但单节点内操作越重。
完整命令示例
1 | # 1) 从右侧推入,模拟"最新动态"(越新越靠右) |
业务场景
| 业务场景 | 典型命令 | 说明 |
|---|---|---|
| 消息列表/最新动态:用户主页只展示最近 100 条,新动态从左边插入、超出就从右边裁掉 | LPUSH + LTRIM |
天然有序 |
简易消息队列:生产者 LPUSH 投递邮件任务,多个消费者 BRPOP 阻塞拉取 |
LPUSH + BRPOP |
左进右出,FIFO |
| 浏览历史/操作记录:按时间顺序保存最近看过的东西,超出长度自动截断 | RPUSH + LTRIM |
有序存储 |
| 栈式回退:如「撤销」功能,最后一步最先回退 | LPUSH + LPOP |
LIFO |
坑点:用 List 做消息队列没有 ACK 机制——消息被
LPOP弹出后若消费失败就丢了。需要可靠性时应该用 Stream。
3.3 Hash(哈希)
底层编码
listpack(小 Hash)/ hashtable(大 Hash)。
编码切换:字段数 > hash-max-listpack-entries(512)或任一 field/value > hash-max-listpack-value(64 字节)即转 hashtable,不可逆。
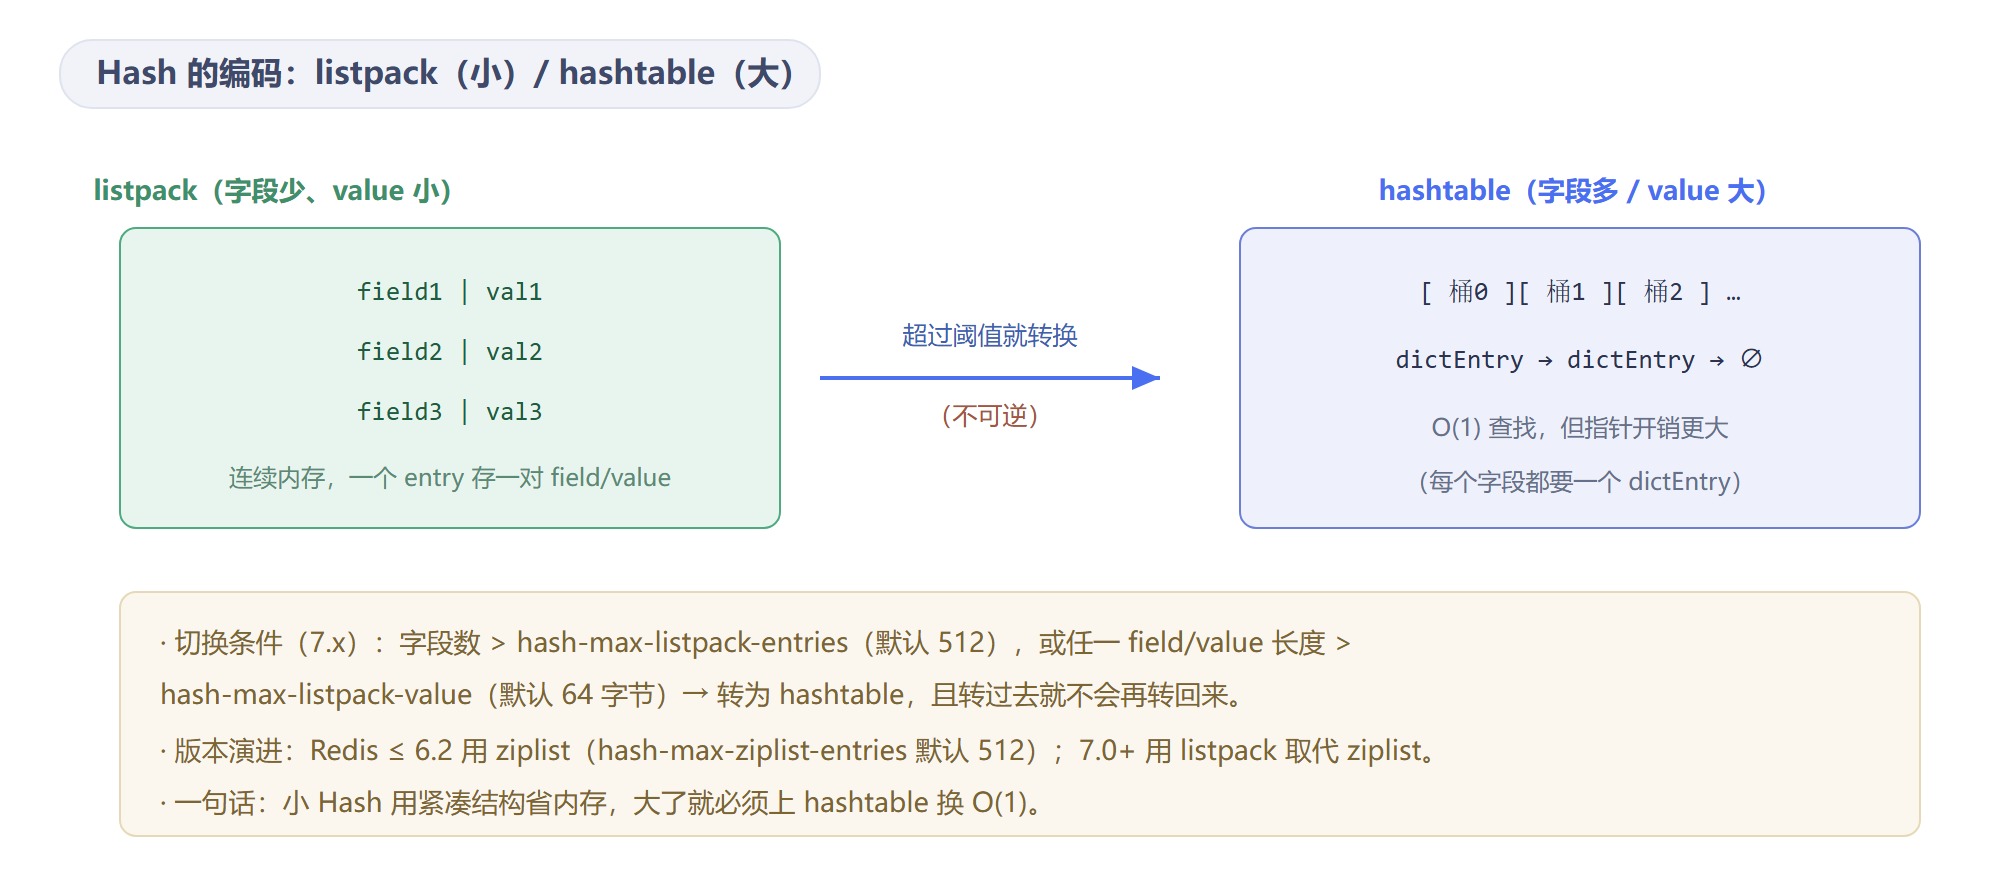
两种编码存"field → value"的方式不一样:
- listpack:把 field 和 value 交替排成一对一对存进一块连续内存——
field1, value1, field2, value2, …。按 field 查 value 时,就从前往后一对一对比较 field,找到就返回对应的 value。 - hashtable:真正的哈希表(
dict),每个 field 是一个dictEntry节点,对 field 做哈希直接定位到桶,再沿链表比较 key,查找是 O(1)。
为什么这样设计
Hash 的使用场景是"一个对象多个字段"(用户信息、购物车),操作特点是按 field 读写单个字段。两种结构在"字段数"这条轴上各有胜负:
- 字段少时 listpack 完胜:一个 5 个字段的 Hash 如果用 hashtable,要为每个 field/value 分配
dictEntry(key 指针 + value 联合体 + next 指针,约 32 字节)再乘上哈希桶数组,固定开销是数据本身的几倍到十几倍;而 listpack 里 field 和 value 紧挨着连续存放,每个 entry 只多一两个字节的编码头。字段少时线性比较 5 对 field 的 O(N) 代价几乎可以忽略,还因为内存连续而缓存友好。 - 字段多时 listpack 撑不住:按 field 查找是 O(N),字段到了几百个,每次
HGET都要扫半张表,延迟明显上升;这时必须换 hashtable 拿回 O(1)。 - 为什么 value 超长也触发转换:listpack 的 entry 里
encoding字段本身要为长数据付出更多字节,而且长 value 会让"线性扫 field"时每次比较的代价变大,紧凑优势被侵蚀,索性直接转 hashtable。
注意默认阈值是 entries ≤ 512 且 value ≤ 64 字节,不是 128(128 是 ZSet 的)。
完整命令示例
1 | # 1) 存一个用户对象(多个字段) |
业务场景
| 业务场景 | 典型命令 | 说明 |
|---|---|---|
| 用户信息:把 name/age/city 等字段放在一个 Hash 里,可以只更新其中某个字段,比 String 存整段 JSON 更灵活 | HSET / HGET / HINCRBY |
字段级读写 |
| 购物车:商品 id 当 field、数量当 value,加购就 +1、删除就 HDEL | HSET / HINCRBY / HDEL |
天然表达「商品→数量」 |
| 计数器分组:按维度(年月/渠道)分别计数 | HINCRBY stats:2026 q1 1 |
按维度分组 |
| 配置项:一个业务的所有开关放在一个 Hash 里 | HSET config:app featureA on |
便于批量读取 |
3.4 Set(集合)
底层编码
intset(全整数且 ≤ 512)/ listpack(7.2+,小集合)/ hashtable(大集合)。
编码切换:出现非整数或数量超 512 时,intset 就转化为 listpack(7.2+,≤ 128 个且元素 ≤ 64 字节)或 hashtable;再超限最终转为 hashtable,不可逆。
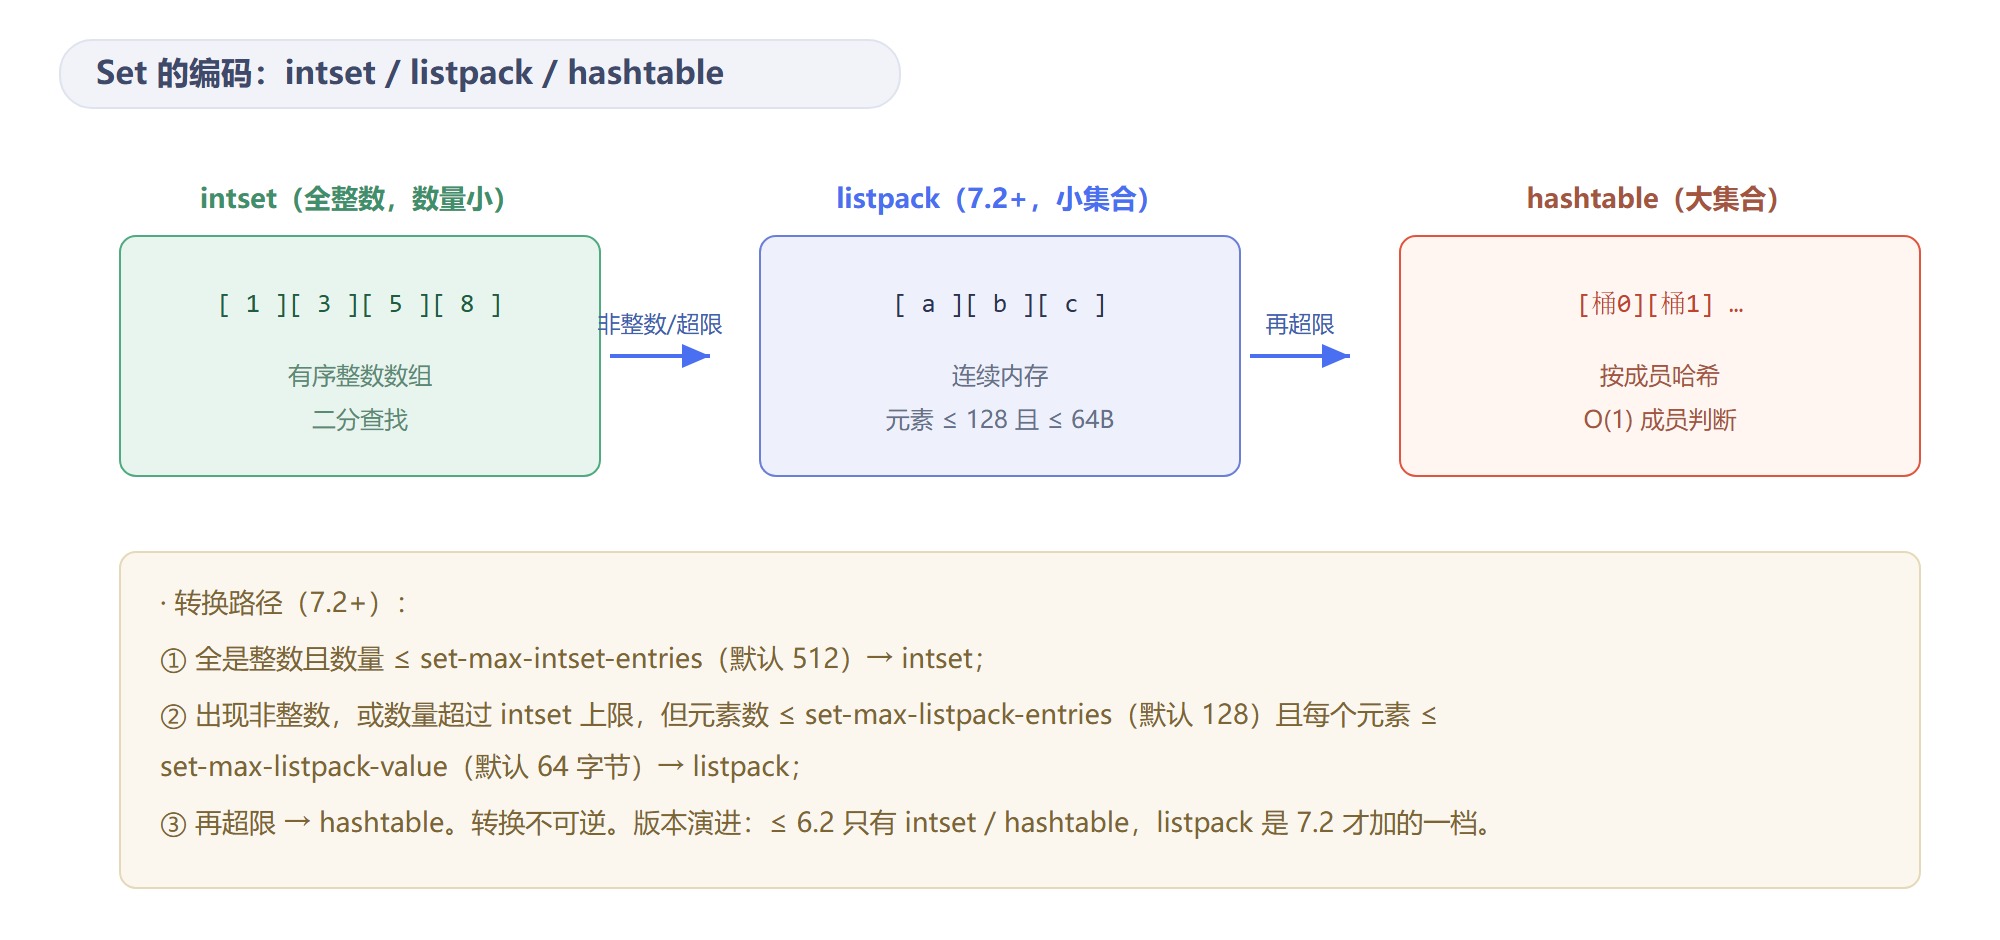
三种编码分别对应三种数据形态:
intset:有序整数数组——元素从小到大排好、不重复,整块连续内存,没有任何指针。查找用二分(O(log N))。- listpack(7.2+):和 List 用的同一块紧凑列表,元素按插入顺序紧挨着存,不要求是整数。
- hashtable:哈希表,每个元素是一个
dictEntry(key 指针 + next 指针),value 为空——Set 只关心"元素在不在"。
为什么这样设计
Set 的核心操作是判断元素是否存在(SISMEMBER)和集合运算(SINTER/SUNION),三种编码是"按数据形态逐级退让":
- 全整数且数量少 →
intset:整数比较最便宜,有序数组二分查找 O(log N) 足够快,而且零指针开销——512 个 int16 元素只占 1KB 左右,换成 hashtable 光dictEntry就要十几 KB。这是省内存的极致形态。 - 出现非整数、但集合还小 → listpack:intset 只能存整数(比较和有序性都建立在数值上),一旦混入字符串就没法维持"有序整数数组"这个前提。7.2 之前的版本这时会直接跳到 hashtable;7.2 起先退到 listpack——非整数元素照样能紧凑存,查找退化为 O(N) 的线性扫描,但小集合下依然比 hashtable 省内存、缓存友好。
- 数量大 / 元素长 → hashtable:无论 intset 的二分还是 listpack 的线性扫,元素一多都顶不住
SISMEMBER的延迟要求,而且SINTER这类交集运算在哈希表上能做到"遍历小集合 + 逐个 O(1) 探测大集合",必须靠哈希定位。
完整命令示例
1 | # 1) 去重统计(UV):同一用户多次访问只会算一次 |
业务场景
| 业务场景 | 典型命令 | 说明 |
|---|---|---|
| 独立访客统计(UV):统计某天有多少不同用户访问 | SADD + SCARD |
精确去重 |
点赞/收藏:用 SISMEMBER 判断「我是否赞过」,用 SADD/SREM 点赞与取消 |
SADD / SISMEMBER / SREM |
O(1) 判断 |
| 共同好友/共同关注:求两个用户关注列表的交集 | SINTER |
交集语义 |
| 可能认识的人:把「他关注但你没关注」的人推给你 | SDIFF |
差集语义 |
| 抽奖/随机推荐:从奖品池随机抽一个且不重复 | SPOP / SRANDMEMBER |
随机取元素 |
| 标签系统:给文章打多个标签,支持按标签取文章 | SADD + SINTER |
标签集合 |
注意:
SINTER/SUNION在大集合上是 O(N),数据量大时慎用,别在热路径上做超大集合的交集。
3.5 ZSet(有序集合)
底层编码
listpack(小 ZSet)/ skiplist + hashtable(大 ZSet)。
编码切换:元素数 > zset-max-listpack-entries(128)或成员 > zset-max-listpack-value(64 字节)即转 skiplist + hashtable,不可逆。
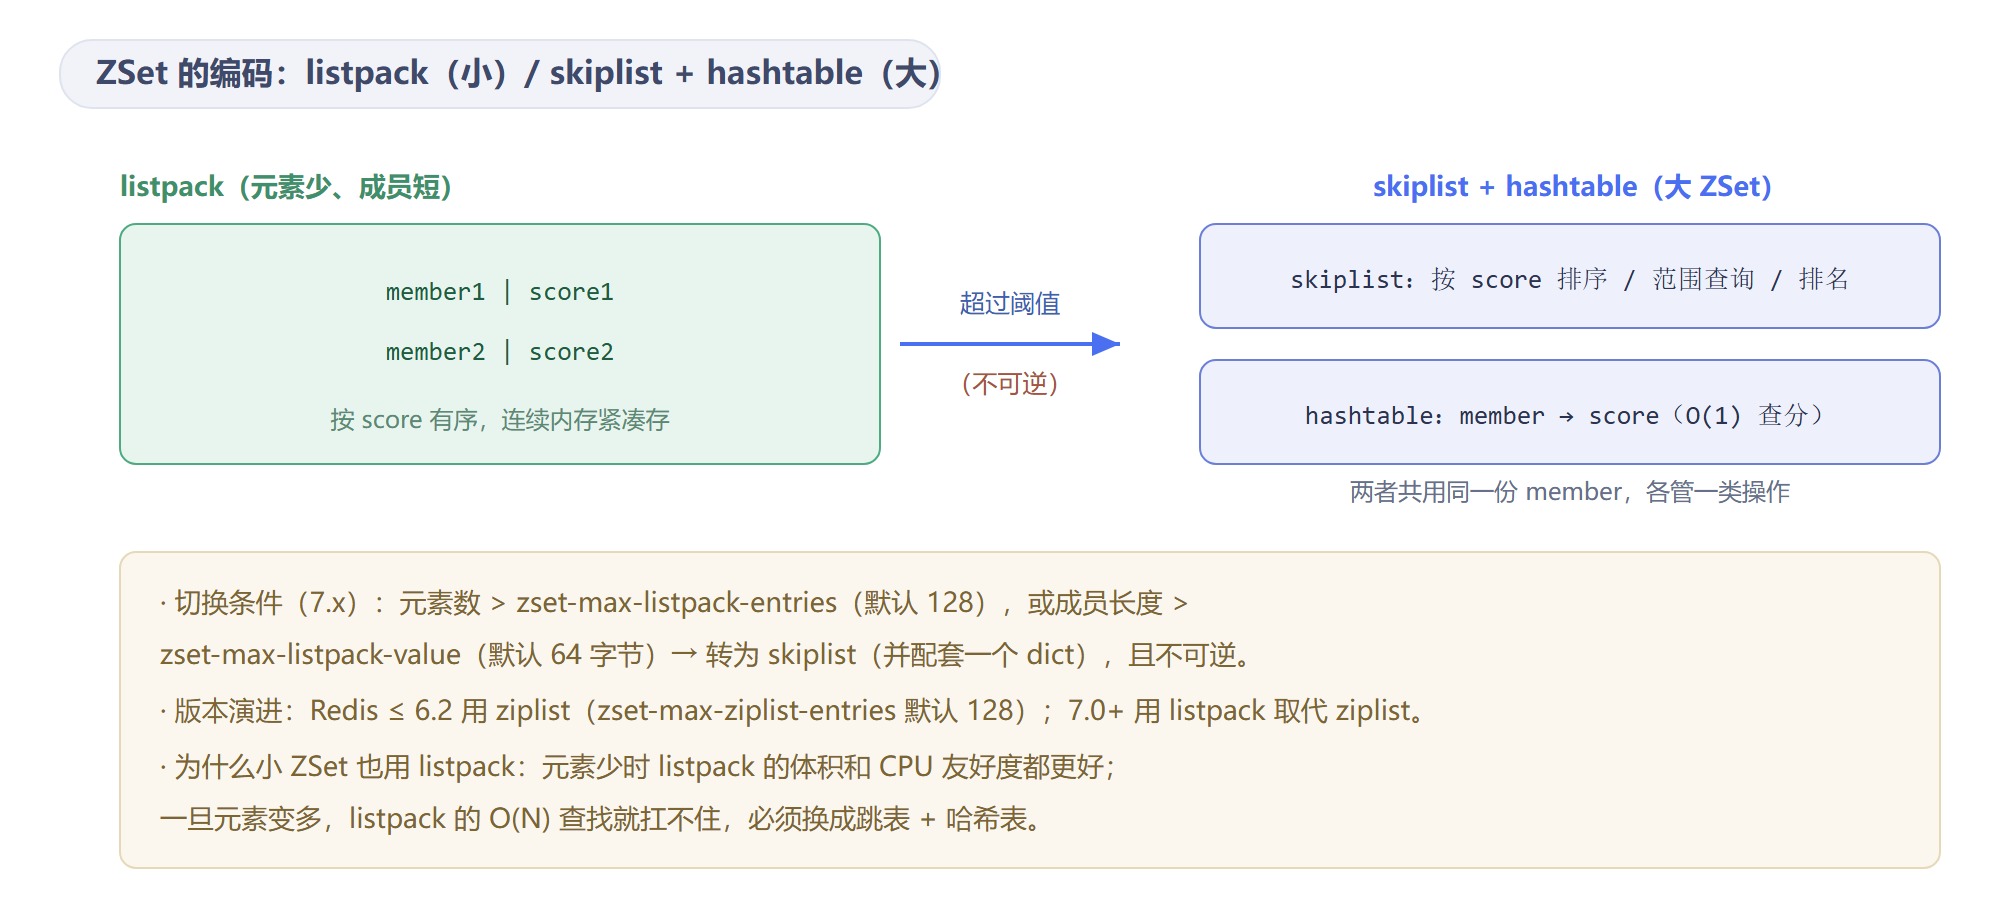
两种编码的形态:
listpack:member 和 score 成对交替存进一块连续内存(member1, score1, member2, score2, …),并且按 score 从小到大排好序。所以取 TopN 就是顺着链表往后数,查某人的分数就线性扫。- skiplist + hashtable:同一批数据被两套索引各存一份——跳表按 score 排序,负责范围查询和排名;哈希表存
member → score映射,负责按成员查分数。
为什么这样设计
ZSet 的操作需求比前几种都多:既要按 score 排序(排行榜、延时队列)、又要范围查询(ZRANGE)、还要按 member 查 score(ZSCORE)。编码选择同样按数据量分档:
- 元素少时 listpack 够用且最省:128 个以内的 ZSet,线性扫描找 score 或 member 的 O(N) 代价很小;而跳表每个节点要按层数挂 forward 指针 + span,哈希表每个成员要一个
dictEntry,固定开销是 listpack 的好几倍。小排行榜(比如一个群内积分前 50)用 listpack 明显更划算。 - 元素多后必须换跳表 + 哈希表:
ZRANGE、ZRANK这类操作在 listpack 上都是 O(N),几百上千个元素时延迟不可接受。跳表把排序、范围查询、排名全部压到 O(log N)(靠底层有序链表 + span 累加);但跳表按 score 查,按 member 查分数它不行(得 O(log N) 甚至更糟),所以再配一个哈希表专门做ZSCORE的 O(1) 查找。两套索引各管一类操作,合起来才是完整的 ZSet 语义。 - 为什么成员过长也触发转换:listpack 里比较 member 是逐字节比字符串,成员越长线性扫描越慢;而且长成员的编码头开销上升,紧凑优势减弱,索性转成跳表 + 哈希表。
完整命令示例
1 | # 1) 排行榜:score 是分数,member 是玩家 |
业务场景
| 业务场景 | 典型命令 | 说明 |
|---|---|---|
| 游戏/直播排行榜:按分数排序,随时取 TopN、查某人排名 | ZADD + ZREVRANGE + ZRANK |
排序 + 排名 |
| 延时任务队列:把任务的执行时间当 score,定时轮询取出到期的任务 | ZADD + ZRANGEBYSCORE |
时间驱动 |
| 滑动窗口限流:用时间戳做 score,移除窗口外的请求后统计数量 | ZADD + ZREMRANGEBYSCORE + ZCARD |
比固定窗口更平滑 |
| 带权重的推荐/优先级队列:按权重出队 | ZADD + ZREVRANGE |
score 即优先级 |
五大类型速查
| 类型 | 是否有序 | 是否去重 | 底层编码(7.x) | 一句话场景 |
|---|---|---|---|---|
| String | —— | —— | int / embstr / raw | 缓存、计数、锁 |
| List | 有序(插入序) | 可重复 | listpack / quicklist | 队列、最新列表 |
| Hash | 无序 | field 唯一 | listpack / hashtable | 对象、购物车 |
| Set | 无序 | 去重 | intset / listpack / hashtable | 去重、共同好友 |
| ZSet | 有序(score) | member 唯一 | listpack / skiplist | 排行榜、延时队列 |
四、三种扩展类型:Geo、HyperLogLog、Stream
这三种属于 Redis 的"特殊用途"类型。它们的底层实现相对独立,这里只讲概念与怎么用。
4.1 Geo:地理位置计算
概念
Geo 用于存储经纬度并做距离计算、范围查找。它底层基于 ZSet 实现,因此天然带有排序能力,但使用上完全是地理语义。
它是怎么把"地球上的一个点"存进 ZSet 的? 核心是 GeoHash 编码,分三步:
- 对经度区间 [-180, 180] 和纬度区间 [-90, 90] 各自不断二分:每二分一次落进左半区间记 0、右半记 1,经度和纬度各产生一串二进制位;
- 把两串二进制交错合并(经度一位、纬度一位交替排列),得到一个 52 位整数;
- 这个 52 位整数作为 ZSet 的 score,位置名称作为 member 存入。
这样就把"二维平面上的一个点"铺平成了一维整数:编码前缀越相近的点,物理位置通常也越接近,范围查询因此可以复用 ZSet 的有序性(GEOSEARCH 的官方文档也写明 score 就是 52 位 geohash 整数)。
临界(边界)问题是怎么解决的? 铺平成一维是有代价的,先看一个具体例子就明白了。
经度 0° 这条线(本初子午线)是第一次二分左右的分界:东经的编码首位是 1,西经的首位是 0。现在有两个点——A 点在东经 0.0001°、B 点在西经 0.0001°,两者实际只隔十几米,几乎是"面对面"。但编码出来:A 是 1xxxx…(首位 1),B 是 0xxxx…(首位 0),这两个 52 位整数的数值相差约 2^51,在一维数轴上一个在天上、一个在地下。如果查"A 附近 1 公里"时只按编码值找"A 的编码 + 一个小偏移量"范围内的点,B 就会被直接漏掉——明明近在咫尺,编码却远隔万里,这就是边界漏点问题。
Redis 的解法分两步:
- 粗筛时多查邻格(9 宫格):范围查找时,Redis 先根据"中心点 + 半径"算出一个矩形包围盒(能罩住这个圆的最小方框),再找出这个包围盒覆盖到的所有 geohash 格子——不是只查中心点自己那一个格子,而是把中心点周围 3×3 一共 9 个格子(自身 + 上下左右 + 四个对角)全部纳入候选。为什么 9 个格子就不会漏?回到上面的例子:A 在 0°E、B 在 0.0001°W,它们分属左右相邻的两个格子;只要把 A 左右两侧、上下四角的邻格都查了,B 所在的那个格子必然在 9 宫格之内,就被捞进候选集了。半径再大一些,包围盒会盖住更多格子,Redis 会按包围盒实际覆盖的范围取格子(不止 9 个),原理相同:把二维上"挨着"的格子全部圈进来,就不存在"隔壁格子查不到"的死角。
- 精筛按真实距离过滤:9 宫格(或包围盒)圈进来的候选是"宁滥勿缺"的——方框四个角上的点其实离中心比半径远。所以第二步对每个候选点用 Haversine 公式(一种根据两点经纬度算球面距离的公式,官方文档确认 Redis 采用,把地球近似为球体)算出精确距离,超出半径的剔除,剩下的按距离排序返回。
GEODIST算两点距离用的也是这套公式。
简单说:GeoHash 负责快速缩小范围,邻格全覆盖负责解决边界漏点,Haversine 负责精确距离——粗筛保证"不漏",精筛保证"不多"。
完整命令示例
1 | # 添加位置(经度 纬度 名称) |
业务场景
附近的人、附近的商户、打车派单、同城推荐等 LBS(基于位置的服务)场景。例如打车 App 里查"我附近 3 公里内有哪些司机",就是 GEOSEARCH ... BYRADIUS 3 km。
4.2 HyperLogLog:基数统计
概念
HyperLogLog(HLL)是一种概率性基数统计算法,用来估算一个集合中不重复元素的个数(基数)。Redis 的三个命令 PFADD / PFCOUNT / PFMERGE 基于它实现,前缀 PF 正是致敬算法作者 Philippe Flajolet。
它凭什么能"数出"不重复的个数? 核心是一个概率规律:
- 对每个元素做哈希,得到一个二进制串;
- 哈希值开头连续 0 的个数越多,出现概率越低——出现 1 个前导 0 的概率是 1/2,2 个是 1/4,k 个是 1/2^k。反过来,当你观察到的"最大前导 0 个数"是 k 时,就可以反推集合里大约有 2^k 量级个不同元素;
- 只用单个"最大前导 0"估计方差太大(运气好坏影响结果),所以 Redis 分桶降低误差:用哈希值的低 14 位决定落入 16384 个桶中的哪一个,剩下的高位用来数前导 0,每个桶只记录自己见过的最大前导 0 数;
- 最终对所有桶的估计值做调和平均,得到基数估算值。
内存为什么恒定:16384 个桶 × 每桶 6 bit ≈ 12KB ——不管统计 1 千个还是 1 亿个元素,都只是往这 16384 个寄存器里更新"最大前导 0 数"。16384 个桶对应的标准误差约为 1.04/√16384 ≈ 0.81%。
特点归纳:
- 极省内存:无论统计多少元素,最多只占约 12KB(元素很少时用稀疏编码,占用更小);
- 有误差:标准误差约 0.81%,是估算不是精确值;
- 只能统计基数,不能取出元素:它不存原始数据,只维护概率模型。
完整命令示例
1 | # 添加元素(首页 UV) |
与 Set 的对比:
| 方案 | 精确度 | 内存 | 能否取元素 | 适用 |
|---|---|---|---|---|
| Set | 精确 | 随元素线性增长 | 能 | 数据量小、需精确 |
| HyperLogLog | 约 0.81% 误差 | 最多约 12KB | 不能 | 海量 UV、可接受误差 |
业务场景
海量数据的 UV(独立访客)统计、搜索关键词去重计数等"只要数量、不要明细"的场景。例如统计一个上亿用户产品的日活,用 Set 会撑爆内存,用 HLL 最多也只占约 12KB。
4.3 Stream:可当消息队列用
概念
Stream 是 Redis 5.0 引入的日志型(append-only)数据结构,用来解决 List 做消息队列"没有 ACK、不支持多消费者"的问题。核心概念有:
- 消息 ID:格式为
时间戳-序号,如1696800000000-0,天然递增、可排序; - 消费组(Consumer Group):多个消费者组成一组,消息在组内分摊消费,互不重复;
- PEL(Pending Entries List,待处理列表):记录已投递但未确认(ACK)的消息,消费者崩溃后可重新领取,实现可靠性;
- ACK 机制:消费完用
XACK确认,未确认的消息留在 PEL 里。
完整命令示例
1 | # 生产消息 |
业务场景
需要可靠投递 + 消费组 + 消息回溯的轻量级消息队列。比如订单超时取消、通知推送这类"不能丢消息"的场景,用 Stream 的消费组 + ACK 就能保证宕机后消息可重新领取。相比 Kafka / RocketMQ,它胜在部署简单、与 Redis 一体;劣势是持久化和吞吐能力有限,不适合超大规模。
三种扩展类型速查:
| 类型 | 一句话概念 | 核心命令 | 典型场景 |
|---|---|---|---|
| Geo | 地理位置存储与距离计算 | GEOADD / GEODIST / GEOSEARCH |
附近的人/店 |
| HyperLogLog | 概率性基数估算,最多约 12KB | PFADD / PFCOUNT / PFMERGE |
海量 UV 统计 |
| Stream | 日志型消息队列,支持消费组与 ACK | XADD / XREADGROUP / XACK |
可靠消息队列 |
五、配置参数与版本演进
前面反复提到的切换阈值,全部由 redis.conf 里的参数控制。理解它们,才能按业务特点调优。
5.1 参数默认值(含版本差异)
| 参数(7.x) | 默认值 | 6.2 及以前的参数名 | 作用 |
|---|---|---|---|
hash-max-listpack-entries |
512 | hash-max-ziplist-entries(512) |
Hash 用紧凑编码的最大字段数 |
hash-max-listpack-value |
64 | hash-max-ziplist-value(64) |
Hash 单个 field/value 的最大字节数 |
list-max-listpack-size |
-2(8KB) |
list-max-ziplist-size(-2) |
每个 quicklist 节点的最大大小 |
set-max-intset-entries |
512 | set-max-intset-entries(512) |
Set 用 intset 的最大整数个数 |
set-max-listpack-entries |
128(7.2+ 才有) | —— | Set 用 listpack 的最大元素数 |
set-max-listpack-value |
64(7.2+ 才有) | —— | Set 元素用 listpack 的最大字节数 |
zset-max-listpack-entries |
128 | zset-max-ziplist-entries(128) |
ZSet 用紧凑编码的最大元素数 |
zset-max-listpack-value |
64 | zset-max-ziplist-value(64) |
ZSet 成员用紧凑编码的最大字节数 |
5.2 调优思路
- 内存敏感、元素不大且不常做范围查询:可以适当调大阈值,让更多对象留在紧凑编码里省内存;
- 读多、要低延迟:不要盲目调大,紧凑结构里查找是 O(N),大对象会拖慢单次操作;
- 转换不可逆:一旦转成 hashtable/skiplist 就不会再转回来(即使后来元素减少了)。如果业务有"先塞满再删空"的模式,要留意这一点;
- 改参数是 CPU/内存的权衡:官方建议改大阈值前先做基准测试,确认转换耗时可以接受。
实用技巧:用
redis-cli --bigkeys或MEMORY USAGE key观察大对象的实际编码。如果发现本该小的对象变成了hashtable,检查是不是 value 长度超了*-listpack-value,或者元素数超了阈值。
六、总结
最后把整条主线收口。Redis 的数据类型体系,本质上就是 "type 一层皮 + 多套底层结构内核" 的多态设计:数据量小的时候用紧凑结构省内存,数据量大了自动切换成高性能结构。
八种底层结构要点回顾:
| 结构 | 主打 | 关键设计 | 解决问题 |
|---|---|---|---|
| SDS | 省内存 / 安全 | len/alloc/flags + 预分配惰性释放 + packed | C 字符串长度 O(N)、非二进制安全、缓冲区溢出 |
| 双向链表 | 灵活 | prev/next + list 封装 | 任意类型存储、O(1) 前后访问 |
| ziplist | 省内存 | 连续内存 + prevlen/encoding 变长,用长度替代指针实现双向遍历 | 小数据紧凑存储(但存在连锁更新) |
| listpack | 省内存 | 记录自身长度 element-tot-len | 保住双向遍历、根除连锁更新,7.0 全面取代 ziplist |
| quicklist | 折中 | 双向链表 + listpack 节点 | List 内存与两端操作性能的平衡 |
| hashtable | 快 | 链地址法 + 渐进式 rehash | O(1) 查找、大集合 |
| intset | 省内存 | 有序整数数组 + 原地升级 | 小整数集合 |
| 跳表 | 有序 | 多层链表 + span + 随机层高(1/4) | 范围查询、排名,ZSet 核心 |
几个关键结论:
- type 与 encoding 解耦:对外类型固定,底层实现随数据自动切换,且转换基本不可逆。
- 记住几个关键数字:44(String)、512(Hash 与 Set 的 intset)、128(ZSet 与 Set 的 listpack);Hash 的默认是 512,别和 ZSet 的 128 记混。
- ziplist / listpack 靠"长度信息"实现无指针的双向遍历:ziplist 记前一个长度(会连锁更新),listpack 记自己的长度(不会)。
- Redis 7.0 用 listpack 全面替换 ziplist:影响 Hash、ZSet 的紧凑编码与 quicklist 节点;7.2 又给 Set 新增了 listpack 一档。
- 跳表 + 哈希表 = ZSet 的最优组合:一个管范围与排名,一个管单点查分;跳表用 1/4 概率的随机层高实现概率平衡。
- 选类型先看场景:缓存计数用 String、队列用 List/Stream、对象用 Hash、去重用 Set、排行榜用 ZSet;海量 UV 用 HyperLogLog,LBS 用 Geo。
理解底层不是为了背结构体,而是为了在选型、调参、排查内存问题时,知道 Redis 在背后替你做了哪些权衡。