RocketMQ 入门到原理(四):消息消费原理
RocketMQ 入门到原理(四):消息消费原理
这是 RocketMQ 系列的第四篇。前三篇我们走完了「生产 → 存储」,本篇把生命周期的最后一段——消费——放大讲透。第一篇埋下的几个伏笔在这里全部回收:订阅关系为什么必须一致、Pull 和 Push 的区别、offset 存在哪、重试与死信队列是怎么回事。
一、消费者组与订阅关系
先建立两个基本概念,它们是整个消费机制的地基。
消费者组(ConsumerGroup):由一个或多个消费者组成。消费是「组」的行为——一个 Topic 的队列,由组内所有消费者共同分担消费(怎么分担,就是后面 Rebalance 的事)。
订阅关系:生产者组装消息时要指定 Topic,消息被投到对应 Broker 的队列里;消费者要消费这些消息,就必须向同一个 Topic 下的队列拉取。消费者组与 Topic 的这个绑定,就叫订阅关系。
注意两个细节:
- 订阅关系不止「纯 Topic」。**
topic:tag也是一种独立的订阅关系——订阅TopicA:a和订阅TopicA:b、以及订阅纯TopicA,是三种不同的订阅关系**。 - 同一个消费组内的所有消费者,必须维持完全相同的订阅关系,这叫订阅关系一致性。违反它会出现消息无法消费的问题——具体原因在第六节用一个例子讲透,这里先记住这条铁律。
二、消费的整体流程
有了上面的概念,先看消费的全流程,后面逐段放大:
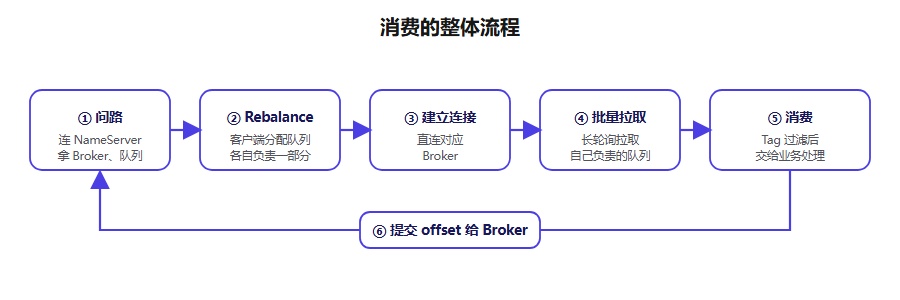
- 启动问路:消费者组启动,多个消费者实例各自连接 NameServer,拿到订阅关系对应的 Broker 列表和队列列表。
- Rebalance 分配:消费组客户端自行协商(Rebalance),把队列分配给组内各消费者——每个消费者各自负责一个或多个队列。
- 建立连接:分配完成后,消费者与对应 Broker 建立连接。
- 批量拉取:此后每个消费者只拉取自己负责的队列,而且是批量拉取。
- 消费:拉回来的消息过滤(Tag)后交给业务代码处理。
- 提交 offset:一批消息消费完成后,把消费到的位点(offset)提交给 Broker 记住,下次就从这之后拉取。
三、第一步:路由的拉取与更新
一个前面文章没讲过的问题:路由变了(Broker 扩容/下线、队列数变化),消费者怎么知道?
答案是:NameServer 不做任何推送,全靠客户端主动拉。
- 消费者和生产者默认每 30 秒向 NameServer 拉取一次路由表,和本地缓存对比。
- 发现变化 → 更新本地路由表和连接,对消费者来说还会触发一次 Rebalance 重新分配队列。
这个设计的好处是 NameServer 保持极简(无状态、不用维护客户端连接),代价是路由变化最多有 30 秒的感知延迟。
还有一个细节:路由变化触发重新分配后,不再属于某个消费者的队列会被「交出」——它已经拉取但还没来得及消费的本地缓存消息会被直接抛弃,不由它继续消费;接手该队列的新消费者,会从 Broker 上记录的上次提交的位点开始拉取。这样保证队列只有一个主人,不会两边同时消费(已经消费到一半的消息可能被重新消费,这是重复消费的来源之一,第七节展开)。
四、第二步:Rebalance——队列怎么分
拿到路由后,消费者组需要决定「谁消费哪些队列」。这一步发生在客户端,Broker 完全不参与——这正是第一篇讲的「Broker 不维护订阅关系」哲学的落地。分配有两种模式。
1. 集群模式(默认)
队列被切分给组内各消费者,一条消息只会被组内一个消费者消费。默认策略是平均分配:
- 把 Queue 列表和 Consumer 列表分别排序,然后按「取模 + 余数」的方式尽可能均匀地切分。
Queue 数 % Consumer 数 == 0:完美均分。- 有余数:前 N 个消费者各多分 1 个队列(N = 余数)。
例如 8 个 Queue、3 个 Consumer → C1 负责 3 个、C2 负责 3 个、C3 负责 2 个。
| 优点 | 缺点 | |
|---|---|---|
| 平均分配 | 分配均匀、实现简单 | Broker 或消费者一变,全量重新分配,队列大规模换主人,容易引发重复消费 |
| 一致性哈希 | 消费者增减时只影响相邻节点,仅约 1/N 的队列需要交接,迁移量最小 | 负载可能不均(取决于哈希分布)、实现复杂 |
一致性哈希的原理:对 Consumer ID 做哈希环映射,Queue 也映射到环上,每个 Queue 归属顺时针方向最近的 Consumer。
适用场景:绝大多数业务用默认的平均分配就够了(队列数远大于消费者数,偶发的全量重分配影响可控);一致性哈希适合消费者实例频繁扩缩容、希望把队列交接量压到最小的场景,比如大规模弹性实例池。
集群模式还有一个硬约束:消费者数量 ≤ 队列数量。如果消费者比队列多,多出来的消费者分不到队列、只能空闲——所以扩容消费者前,先确认队列数够不够分。
2. 广播模式
广播模式下不存在分配:每个消费者拉取全部队列,一条消息会被组内每个消费者都消费一遍。
两种模式的对比如下图,一目了然:
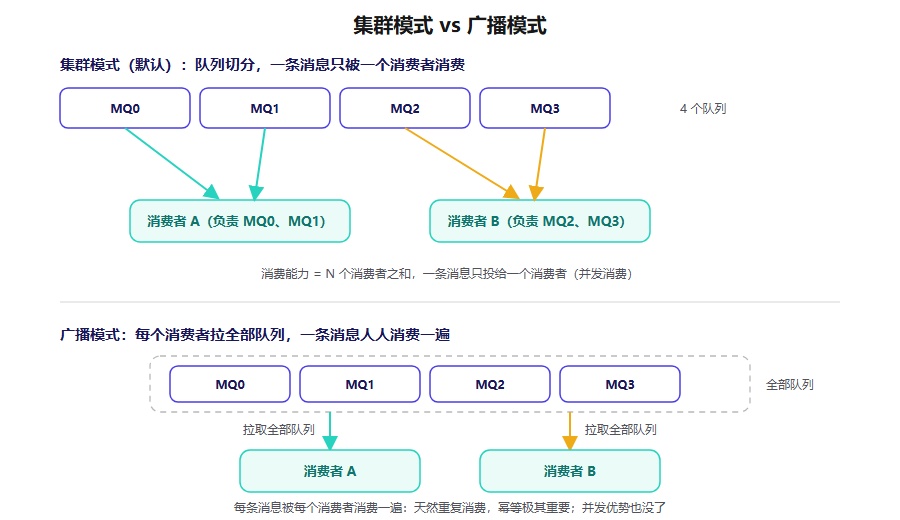
这带来两个代价:
- 重复消费是天然的(每个实例都会收到同一批消息),业务幂等性变得极其重要。
- 并发消费的优势没了——集群模式里 N 个消费者分摊消息、消费能力是 N 倍;广播模式每个消费者都要扛全量。
所以广播模式不建议常规使用,只在「每个实例都必须拿到全量消息」的场景用:比如各服务实例的本地缓存刷新、配置变更广播——这种场景下「人人都收到一遍」恰恰是需求本身。
3. 什么时候会触发重新分配
三种情况:消费者上线/下线(组内成员变化)、路由变化(Broker 或队列数变化)、以及消费者启动时。重新分配带来的重复消费问题,第七节一起讲。
正因为每次扩缩容都会触发全组重新分配、可能引发重复消费,扩缩容要挑时机:最好等队列里积压的消息全部消费完再做(此时交接的是空队列,无消息可重复);并且选夜间低峰、无人使用的时段操作,把对业务的影响压到最小。
五、第三步:拉取——Push、Pull 与长轮询
队列分好了,消费者开始向 Broker 拉消息。这里必须先讲 MQ 的两种基本模型。
Push 模型(Broker 主动推):RabbitMQ 是典型代表。Broker 把队列里的消息主动推给消费者,消息非常及时、不容易堆积。但问题也很致命:Broker 不知道消费者扛不扛得住。消费者如果消费变慢(GC、下游超时),消息还在源源不断地推过来——拉来的消息都堆在消费者内存里,消费不过来又无法销毁,最终内存溢出、宕机。
Pull 模型(消费者主动拉):反过来,消费者按自身能力主动拉取,拉多少、什么时候拉都自己说了算,永远不会被撑爆。但劣势是不及时——队列里没消息时,消费者要么傻等、要么反复空轮询,消息到达后不能第一时间知道。
RocketMQ 的答案:Pull + 长轮询。它本质是 Pull 模型(第一篇讲的「消费者主动拉取」),但用长轮询把「不及时」这个短板补上了:
- 消费者发起拉取请求,如果队列里没有新消息,Broker 不立即返回,而是把这个请求挂起(默认约 15 秒),挂起期间几乎不消耗资源。
- 一旦新消息到达——CommitLog 写入后、后台线程(ReputMessageService)完成对应 ConsumeQueue 索引构建的那一刻——挂起的请求立刻被唤醒,根据索引拉取一批消息返回。
- 而且这个读取先走 PageCache(第三篇讲过):新消息大概率还在页缓存里,直接命中内存,返回极快。
这就是「Push 的及时性 + Pull 的安全性」:消费者永远按自己的节奏拉,不会被撑爆;消息一到又几乎立刻送达,性能近似 Push。
六、第四步:消费——Tag 过滤与订阅关系一致性
1. Tag 过滤
拉回来的消息,要先过滤再交给业务。原因第二篇讲过:Broker 对消息的分类只认 Topic,Tag 只是消息自带的属性。队列里混着各种 Tag 的消息,如果消费者组订阅的是 topic:tag,就要把不属于自己订阅的消息过滤掉,只留下匹配的。过滤分两层:Broker 端先用 ConsumeQueue 索引里存的 Tag HashCode 粗筛(第三篇的 20 字节结构),客户端再做精确过滤。
2. 为什么订阅关系必须一致
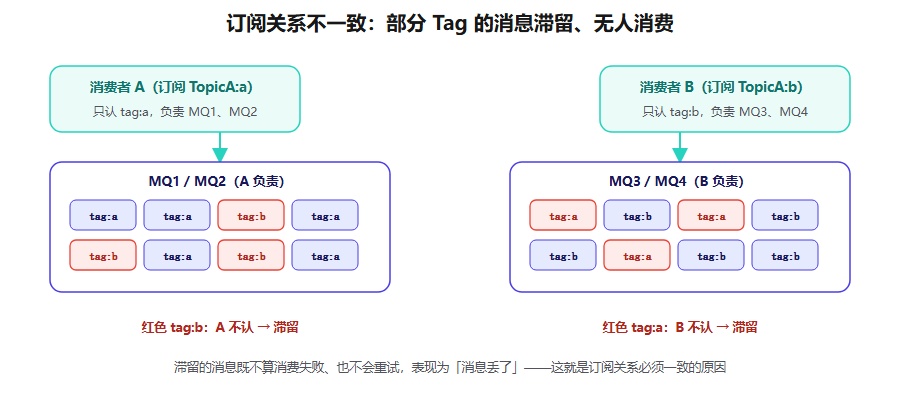
现在可以用一个例子把第一篇的伏笔讲透了。假设消费者组内两个消费者订阅不一致:消费者 A 订 TopicA:a,消费者 B 订 TopicA:b。经过 Rebalance,A 负责 MQ1、MQ2,B 负责 MQ3、MQ4。而消息是生产者轮询投递的,各队列里混杂着各种 Tag 的消息:
- MQ1、MQ2 里的消息:
tag:a, tag:a, tag:b… - MQ3、MQ4 里的消息:
tag:a, tag:b, tag:b…
问题出现了:A 只认 tag:a,它负责的 MQ1、MQ2 里的 tag:b 消息被过滤掉、无人消费;B 只认 tag:b,MQ3、MQ4 里的 tag:a 消息同样无人消费。这些消息既不算消费失败、也不会重试,就那样滞留在队列里——表现为「消息丢了」,实际是被另一个消费者的过滤器丢弃了。这就是订阅关系一致性这条铁律的由来。整个过程如下图:
3. 消费失败:重试与死信队列
消费的结果有两种返回:CONSUME_SUCCESS(成功)和 RECONSUME_LATER(稍后重试)。注意 RocketMQ 的机制:Broker 并不关心你消费成功还是失败——它只看返回值,返回 RECONSUME_LATER 就把消息丢进重试机制。这和 RabbitMQ 显式的消费者确认机制(ack/nack)不同,RocketMQ 选择「默认可重试」,这正是它消费吞吐高的设计取向。
重试的完整链路:
- 消费失败的消息被投进重试队列,Topic 为 **
%RETRY% + 消费组名**。 - 默认最多重试 16 次,且间隔越来越长(指数退避),退避时长用的正是延迟消息的延迟等级:
1s 5s 10s 30s 1m 2m 3m 4m 5m 6m 7m 8m 9m 10m 20m 30m 1h 2h共 18 级,重试从第 3 级(10s)开始逐级递增。延迟消息的原理第五篇讲。 - 16 次都失败,消息进入死信队列(DLQ),Topic 为
%DLQ% + 消费组名。死信队列里的消息不会自动投递,等待人工处理(排查修复后重新投递或人工补偿)。
另外,消息里自带重试次数字段(reconsumeTimes,第一篇 Message 结构里埋的那个字段)——你可以在业务代码里拿到它是第几次重试,做特殊处理(比如第 N 次后改走人工流程),然后主动返回 SUCCESS 终止重试。
七、第五步:提交 offset——消费进度与重复消费
消费完成后要提交消费位点,这样下次拉取才知道从哪继续。提交方式随消费模式不同。
1. 集群模式:offset 存 Broker
消费者本地记录 offset,然后定期提交(默认每 5 秒)给 Broker,Broker 持久化消费位点。下次拉取从该位点之后开始。为什么存 Broker(第一篇的伏笔):消费者重启、或 Rebalance 换了队列主人后,新的消费者能读回上次的进度,做到既不多消费、也不漏消费。
广播模式则完全相反:offset 只存消费者本地,Broker 完全不存——因为每个消费者都要从头消费全部消息,进度各管各的。
2. 重复消费的两大根源
明白了 offset 的提交机制,一个自然的问题就冒出来了:消费是先做的、offset 是 5 秒后才提交的——那「已经消费、但 Broker 还不知道」的这段时间,就是重复消费的温床。具体会在什么情况下出事?主要有两个场景。
根源一:提交 offset 失败。消费者消费完一批消息,提交 offset 时网络波动或丢失,Broker 上的位点没更新——它还以为你只消费到上上次的位置。下次拉取,Broker 乖乖从旧位点之后发消息,于是刚刚消费过的这批消息又被拉回来,再消费一遍。这就是第二篇说「至少一次投递」在消费端的体现:宁可重复,不可漏掉。
根源二:Rebalance 队列交接。提交失败只是网络问题,还有一种更隐蔽的:队列换了主人。举个例子:队列扩容,4 个队列变 6 个,消费者还是 2 个。重新分配后,消费者 A 从负责 1、2 号队列变成负责 1、2、3 号,消费者 B 从 3、4 号变成 4、5、6 号。此时 3 号队列换了主人——但注意,B 可能正在消费 3 号队列、还没消费完没提交。A 接手后从 Broker 记录的上次提交位点开始拉,就把 B 消费到一半的消息又消费了一遍。消费者上下线触发的重分配,也是同样的道理。
3. 为什么不会发生 offset 覆盖
顺着根源二再往下想一层,会出现一个更吓人的可能:3 号队列已经归 A 了,B 手里还攥着没提交完的消息。假设 B 消费得慢,A 接手后都推进到 offset 300 了,B 这才处理完自己手里的一批(还停在 offset 200)——B 这时提交,Broker 上的位点会不会被回写覆盖成 200?如果会,A 刚消费过的 200~300 又得再来一遍。
答案是不会。现代客户端(DefaultMQPushConsumer)在提交 offset 前会检查该队列是否还属于自己:B 提交前发现 3 号队列已经不归自己了,就放弃提交。这是防止位点回退的最后保障。(早期的 PullConsumer 没有这个检查,确实存在覆盖问题。)
八、重复消费的解决:幂等消费落地
第二篇讲的是生产端不重复投递(Key、消息表),本篇要解决的是消费端不重复消费——同一消息到达两次,业务结果只生效一次。常用方法:
- 唯一键插入(最常用):给业务表维护唯一键(用户 ID、订单 ID 等)。重复消费时第二次插入会因唯一冲突失败——捕获异常直接返回 SUCCESS 即可。
- 状态更新用 CAS:对状态类操作(如「待支付 → 已支付」),更新语句带上前置状态条件(
UPDATE ... WHERE status = '待支付'),重复执行时条件不满足、影响行数为 0,天然幂等。 - Redis 记录消费过的 Key:利用消息自带的 Key,消费完成后写入 Redis(如
mq:idem:{key})。下次收到同 Key 的消息,先查 Redis,存在就直接跳过。 - 数据库去重表:建一张去重表,Key 做唯一主键。业务完成后插入该 Key 的记录;插入失败说明已消费过,捕获异常返回 SUCCESS(而不是 RECONSUME_LATER,避免无意义重试)。
大多数场景,第一种唯一键就够用了;对一致性要求高的核心业务,可以再加第三、四种做双保险。
小结
这一篇走完了消费的全流程:问路 NameServer(30s 主动拉取路由)→ Rebalance 分队列(集群模式平均分配/一致性哈希、广播模式全量消费)→ 长轮询拉取(Pull 的安全 + Push 的及时)→ Tag 过滤消费(Broker 端 HashCode 粗筛 + 客户端精筛,订阅关系必须一致否则消息滞留)→ 提交 offset(集群存 Broker、5s 定期提交;广播存本地)。消费失败走重试队列(16 次、延迟等级逐级递增),最终失败进死信队列人工处理;重复消费源于提交失败与队列交接,靠「提交前检查队列归属」兜底,业务侧用唯一键、CAS、Redis、去重表做幂等。
到这里,「一条消息的生命周期」主线已经完整闭环。下一篇进入横向专题——特殊消息类型:顺序消息、延迟消息、事务消息分别是怎么实现的。