RocketMQ 入门到原理(二):消息发送原理
RocketMQ 入门到原理(二):消息发送原理
这是 RocketMQ 系列的第二篇。第一篇建立了全局地图,本篇把「一条消息的生命周期」的发送阶段放大来看。发送一条消息要走四步:组装消息 → 问路 NameServer → 直连发送选队列 → 落盘确认。本文就按这四步一步步深入,把每一步里的细节设计讲透。
一、发送一条消息的整体流程
发送一条消息,整体走四步:
- 组装消息:生产者先构造一个 Message,指定它要发到哪个 Topic、消息体(body)是什么;要不要带 Key,由业务按需选择。
- 问路:生产者连接 NameServer,询问「这个 Topic 的消息存在哪些 Broker 上」,拿到 Broker 地址与队列信息。
- 直连发送:生产者从路由信息里选中一个 Broker 下的某个队列,把消息直连发过去。
- 落盘确认:Broker 把消息持久化到磁盘,完成后向生产者返回 ack(确认),一次发送到此结束。
整体时序如下图所示:
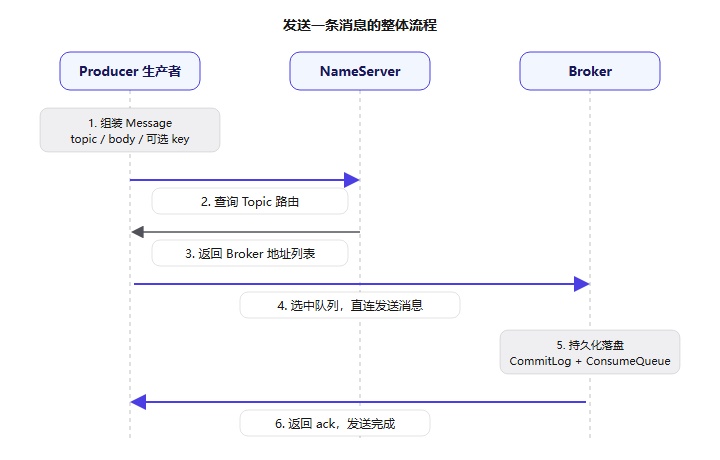
下面的章节,就按这四步一步一步深入,每一步的细节设计都不放过。
二、第一步:组装消息
发送的起点,是生产者组装出一个 Message。组装时最核心的是两个必填项:
- topic:消息发到哪个主题。这是路由的「导航坐标」,后文会看到,它决定了消息最终去哪台 Broker。
- body:消息体,业务自己序列化(如 JSON 转
byte[])。
另外还有一个可选项:key(关键标识符)。它是业务唯一标识,比如订单号、用户唯一 ID。为什么需要它?因为发送存在重试,重试会产生重复消息,key 就是后续消费端做幂等去重的依据——具体用法在第七节和消费篇展开。
顺带把 Tag 说清楚,这是最容易混淆的点:Broker 对消息的分类只认 Topic,对 Tag 一无所知、不做任何处理。Tag 只是消息自带的一个属性,生产者发消息时顺手带上即可(它连可选都不算,属于「带不带都行」),真正使用它的是消费端——消费者通过
topic:tag订阅,用 Tag 做二级过滤。所以一句话:Tag 是生产者不管、消费者用的东西。
Message 组装完成后,生产者就要开始「送信」了。
三、第二步:问路——NameServer 路由机制
消息是发给 Broker 的,但生产者不知道「我这个 Topic 在哪台 Broker 上」,所以要先问 NameServer——它是生产者和 Broker 之间的「地图」。这一步的机制由三部分组成。
1. Broker 注册
Broker 启动的时候,会主动连接 NameServer,把自己拥有的 Topic 信息上报上去。一个集群里通常有多个 Broker,每个 Broker 都可能持有不同的 Topic,这些信息都会注册到 NameServer。
2. 路由表:按 Topic 分类,记录队列数量与权限
NameServer 收到注册信息后,维护一张路由表。注意,它不是简单的「Topic → Broker 列表」——对每个 Broker 上的每个 Topic,它还记录着三样关键信息:
1 | Topic-A: |
逐个解释:
- 写队列数量(writeQueueNums):生产者可以向该 Topic 写入的队列个数。轮询选队列(见第四步)就是在这些写队列里选。
- 读队列数量(readQueueNums):消费者可以从该 Topic 读取的队列个数。消费端的 Rebalance(消费篇会讲)就是在这些读队列里分配。
- perm(权限):该 Topic 在这台 Broker 上的读写权限标识。2 = 只写、4 = 只读、6 = 读写。比如想临时让某台 Broker 停止接收某个 Topic 的新消息(只消费存量),把 perm 改成 4 即可,生产者就不会再往它这里写了。
写队列和读队列通常相等(比如都是 4),但也可以不相等——典型场景是队列扩容/缩容时,为了平滑过渡,会临时让读写队列数不同(比如新节点先开少量写队列,逐渐放开)。记住这个差异即可,细节在运维场景里用得上。
生产者来问「Topic-A 在哪」,NameServer 就把这张表里 Topic-A 对应的 Broker 列表连同队列数量、权限一起返回——生产者据此知道「能往哪几台 Broker 写、每台能写几个队列」。
3. 心跳检测:保持地图新鲜
Broker 不会只注册一次就完事,它需要持续证明自己还活着:
- 每个 Broker 每 30 秒向 NameServer 发送一次心跳(顺带更新自己的 Topic 信息,比如队列数量变了、权限变了)。
- NameServer 端,如果 120 秒都没有收到某个 Broker 的心跳,就判定它已经挂了,把它从路由表里剔除。
这样一张会「过期作废」的路由表,就保证了地图永远是新鲜的:挂了节点的地址不会再被发给生产者。
4. 为什么 NameServer 能如此极简
看到这里你会发现,NameServer 只做一件事:维护「Topic → Broker + 队列信息」的路由表,并靠心跳保持它新鲜。它不存消息、不存消费进度、不维护任何订阅关系——这正呼应了第一篇讲的「设计哲学」:把路由发现独立出来,NameServer 无状态、多节点互不通信,任何节点挂了都不影响其他节点,Broker 和客户端则各司其职。
四、第三步:直连发送——选队列
拿到路由表后,生产者知道了「Topic-A 在 Broker-1 和 Broker-2 上,各有 4 个写队列」。接下来,消息具体放进哪个队列,是由生产者程序自己决定的。
RocketMQ 默认采用的是轮询(Round Robin)策略:
- 生产者内部维护一个原子计数器(AtomicInteger)。
- 每发一条消息,计数器加 1,然后取 **
计数器 % 写队列总数**,得到这次要投递的队列下标。
比如 Topic-A 在两个 Broker 上各有 4 个写队列,共 8 个队列,计数器依次为 1、2、3、4、5……取模后消息就依次落进队列 0、1、2、…、7、0、1……如此循环。
轮询的效果是:消息被均匀地打散到各个 Broker、各个队列,避免某个队列被塞满、其他队列空闲。当然这是默认行为,业务也可以自定义选择策略(比如按订单号哈希,保证同一个订单的消息进同一个队列——这就是后面「顺序消息」篇的基础),这里先记住默认的轮询机制。
选定队列后,生产者就直连对应的 Broker,把消息投递过去——中间不再经过 NameServer,这也是「问路一次、直连收发」设计的关键。
五、第四步:落盘与确认——三种发送方式
消息到达 Broker 对应 Topic 的队列后,会被持久化到磁盘。在磁盘上,这次写入同时涉及两个文件:
- CommitLog:所有 Topic 的消息按到达顺序追加写入的「总账本」,一个 Broker 只有一份。
- ConsumeQueue:按 Topic 和队列维度建立的「消费索引」,记录每条消息在 CommitLog 里的位置。
消息先顺序写进 CommitLog,再建立对应的 ConsumeQueue 索引——这是 RocketMQ 存储的核心结构,也是它能海量堆积、高吞吐落盘的根基。这一段的完整细节(顺序写、刷盘时机、零拷贝)会在下一篇「消息存储」里详细展开,这里先知道「落盘 = 同时改两个文件」即可。
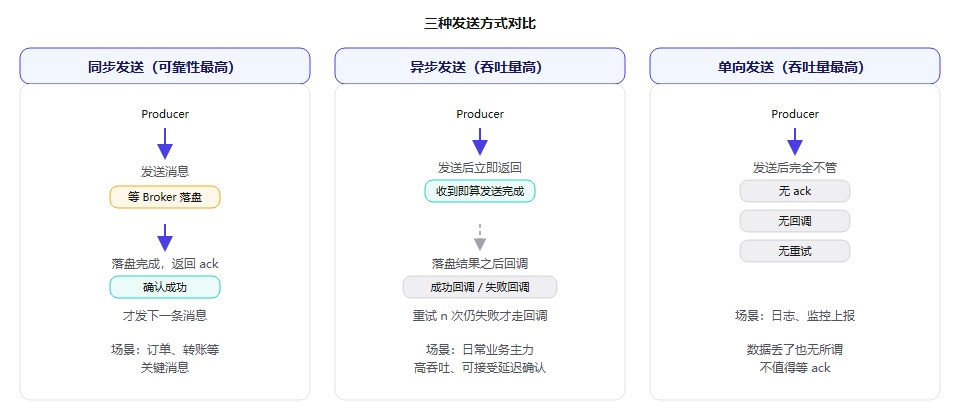
那么,ack 什么时候返回? 这就引出了三种发送方式。它们走的是同一条发送链路,唯一区别就在对落盘确认(ack)的态度上。
1. 同步发送(Sync):等落盘确认
流程:生产者把消息发给 Broker 之后,必须等 Broker 持久化完成、返回 ack,才能发下一条消息。
特点:每条消息都确认落盘后才算发送成功,可靠性最高。适合对「发没发出去」特别在意的场景,比如金融转账、订单创建这类关键消息。
重试机制:如果网络波动或 Broker 宕机,生产者一直等不到 ack,就会触发重试——默认最多重试 2 次(这个次数可以配置)。每次重试都会走故障转移(见第六节):换一个 Broker 上的队列重新投递。
遗留问题:重试带来一个副作用——重复消息。原本第一条消息可能已经落盘成功了,只是 ack 在网络中丢失,生产者误以为失败而重发,于是 Broker 上出现了两条一模一样的消息。这种「至少投递一次(At Least Once)」的语义保证消息不丢,但引入了重复。怎么解决,见第七节。
2. 异步发送(Async):收到即返回,回调收尾
流程:生产者把消息发给 Broker 后立刻返回,不用等待。Broker 收到消息就回一个 ack(此时只是「收到了」,还没落盘)。
特点:由于不用干等落盘,生产者的吞吐量大幅提升,这是日常业务的主力发送方式。
回调机制:落盘最终是成功还是失败,Broker 之后会再把结果异步回传给生产者——这需要你编写一个回调函数,分别处理「持久化成功」和「持久化失败」两种后续。这也是它和同步发送最大的区别:同步发送把结果直接同步给你,异步发送把结果延迟通过回调给你。
重试机制:异步发送同样有重试。发送失败后会在内部重试(默认也是 2 次),重试 n 次仍然失败,才会走失败回调,把最终结果交给你处理。
3. 单向发送(Oneway):发完不管
流程:生产者把消息发出去,不关心 Broker 是否收到,更不等 ack。
特点:没有 ack、没有回调、也没有重试,是最「粗暴」的方式,但吞吐量也最高。
场景:适合发送方根本不关心结果的日志类、监控上报类消息——这些数据丢了也就丢了,不值得为它们付出等 ack 的代价。
三种方式怎么选
| 发送方式 | 是否等 ack | 是否有回调 | 是否有重试 | 可靠性 | 吞吐量 | 典型场景 |
|---|---|---|---|---|---|---|
| 同步 | 等落盘 ack | 无 | 有(默认 2 次) | 最高 | 低 | 订单、转账等关键消息 |
| 异步 | 不等,收到即返回 | 有 | 有(默认 2 次) | 中 | 高 | 日常业务主力 |
| 单向 | 完全不等 | 无 | 无 | 最低 | 最高 | 日志、监控上报 |
三种方式的差异,用一张图对比更直观:
六、发送失败怎么办:重试、故障转移与故障隔离
前面提到同步/异步发送失败会触发重试,这里把重试的细节说清楚。
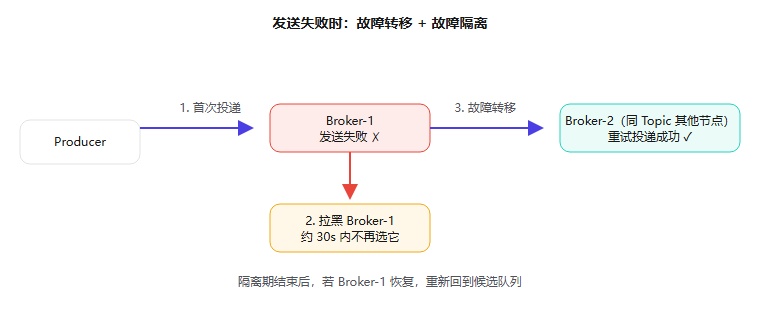
一个 Topic 通常分布在多个 Broker 上(集群部署),重试时不会再选刚才失败的 Broker,而是换该 Topic 在其他 Broker 上的队列重新投递——这就是故障转移,保证消息尽可能送出去。
但光靠「换一个」还不够:如果一个 Broker 已经持续故障(比如磁盘满了、网络抖动),每次重试都先撞它一下,白白浪费时间。所以 RocketMQ 还引入了故障隔离(延迟故障容错):
- 发送失败后,把出问题的 Broker 临时「拉黑」:在一段时间内(比如 30 秒),选择队列时会主动跳过这个 Broker 的所有队列。
- 隔离期过后,如果它恢复了,会重新进入候选列表。
这样发送链路就能自动避开「正在生病」的节点,把故障的影响限制在最小范围内,而不是反复在坏节点上浪费重试次数。整个过程如下图所示:
七、重复消息的两个解法
「至少一次投递」使得重复消息是不可避免的——只能靠业务侧去识别并处理重复。业界主要有两种做法。
解法一:消费端幂等(推荐)
正是第二步里说的那个 Key:它是业务唯一标识(订单号、用户唯一 ID)。消费者收到消息后,用这个 Key 判断「这条消息是不是已经处理过了」:
- 处理前先检查唯一性(比如数据库唯一索引、Redis 的 SETNX)。
- 已存在 → 说明处理过,直接丢弃本次重复消息;
- 不存在 → 正常处理,并把 Key 记下来。
加积分、发优惠券这类操作尤其要做幂等,否则一次重复投递就会给用户加两次积分。
解法二:生产端消息表
如果你不想把幂等的责任推给消费端,也可以在生产端自建一张消息表(存在 MySQL 里):
- 每次发送消息前,先生产一个全局唯一的 ID(UUID、雪花 ID 等),插入消息表。
- 消息表对 ID 建唯一约束,所以重投时再插一遍就会因为主键冲突而失败——于是发现「这条消息已经发过」,直接跳过,不再重复发送。
这两种方式可以二选一,也可以同时使用。本文点到为止,关于幂等的更多细节(消费端具体怎么落地)会在「消息消费」篇详细展开。
小结
这一篇我们沿着发送流程的四步层层深入:组装消息(topic/body/key,Tag 是「生产者不管、消费者用」的属性)→ 问路 NameServer(注册、路由表记录写队列/读队列数量与 perm 权限、30s 心跳 / 120s 剔除)→ 直连发送选队列(原子计数器轮询,消息均匀打散)→ 落盘确认(CommitLog + ConsumeQueue 两个文件,细节留下一篇;三种发送方式的本质区别在对 ack 的态度:同步等落盘确认、异步收到即返回靠回调收尾、单向发完不管)。发送失败时靠重试 + 故障转移 + 故障隔离保证链路可用;「至少一次投递」带来的重复消息,用消费端幂等或生产端消息表来兜底。
从下一篇开始,我们走进 Broker,看看消息落盘到底是怎么做到「又快又不丢」的——那是 RocketMQ 最硬核的部分。