RAG为什么答不出全局性和关联性问题? GraphRAG 与 LightRAG 全链路拆解
先看一个真实会翻车的问题:
「我们公司哪些欧洲供应商,过去一年的安全审计没通过,而且还在处理个人隐私数据?」
答案分布在三份文档里。供应商档案说谁是欧洲的,审计报告说谁没通过,合同文档说谁在处理 PII。人来做这道题,就是把三个条件依次叠上去,最后剩下的那几个就是答案。
传统 RAG 做不到这一步。它会把三份文档里语义相近的段落各捞一堆,一起塞给模型,却没有办法把三个集合求交集。模型面对三堆互不相干的材料,只能猜,猜错就编。
问题出在检索单元上:它检索的是「块」,不是「块与块之间的关系」。这篇文章从三类失效讲起,把 GraphRAG 和 LightRAG 这两条用知识图谱修 RAG 的路线,从索引到查询完整拆一遍。
一 传统 RAG 的三道坎
上一篇《RAG 为什么总答不准?从切块到混合检索的全链路拆解》里,我们把切块、Embedding、向量索引、混合检索、Rerank 这几层都优化了一遍。那些手段确实有效,但它们解决的是「怎么把最相关的块排得更靠前」。
还有一类问题,是排序再准也救不了的。
1.1 先看传统 RAG 的检索假设
传统 RAG 的在线链路只有四步:
- 把问题做 Embedding;
- 在向量库里找 Top-K 个最相似的块;
- 把这些块拼进 Prompt;
- 交给大模型生成。
这条链路压着两个隐含假设:
- 假设一:答案完整地躺在某一个块里。
- 假设二:块的语义和问题越像,它离答案就越近。
只要问题稍微复杂一点,这两个假设就会同时崩掉。
1.2 第一道坎 切片把逻辑关系切断了
看一个医疗场景的例子。一份药品手册里,第 2 章写着:
卡托普利属于 ACEI 类药物。
第 9 章的用药禁忌一节又写着:
严重肾功能不全者禁用卡托普利。
两句话隔了七章。用户问「高血压合并糖尿病患者首选哪几种 ACEI 药物?禁忌症是什么?」,传统 RAG 会把两段都检索出来,一起扔给模型。模型看到「卡托普利」出现在 ACEI 那一块,又看到「禁用」出现在另一块,很容易组合出一句:
卡托普利属于禁忌症药物。
一句话,把「谁禁用」和「谁属于哪类」这两个关系,接错主体了。
根因在切块这个动作本身,不在粒度。 切块是按长度或分隔符切的,不是按「条件—结论」这种语义单元切的。
这个问题可以缓解,但治不了根:
- 父子块(Small-to-Big):用小子块去检索,命中后把它的父块整段取回来。信息确实全了,但父块一变大,无关内容也跟着进来。
- 相邻块合并:切完之后让大模型判断相邻两块的关联度,高就合并。
这两种办法都只对位置上挨着的文本有效。第 2 章和第 9 章隔了七章,既不是父子块,也不相邻,两条策略都碰不到。跨章节、跨文档的关系更是如此:第 1 章定义的术语,第 8 章才用到;A 文档里的客户,B 文档里才出现他的合同。靠合并相邻块,这类关系永远接不上。
记住,切块解决的是「上下文装不下」,不是「逻辑不完整」。
1.3 第二道坎 全局性问题根本检索不出来
把《三国演义》按传统 RAG 切块、向量化、入库,然后问:
刘备是个怎么样的人?
向量库会捞回一大堆片段:三顾茅庐时的刘备、携民渡江时的刘备、白帝城托孤时的刘备,还有旁人评价他的句子。每一条都对,但每一条都只是一个侧面。
要评价一个人,得把他的完整生平串起来看。传统 RAG 只能返回一堆碎片化的相似片段,答不出这种需要全局汇总才能得到的结论。
同样的问题还有:
- 「这本书的主题思想是什么?」
- 「这套技术文档集合,主要讨论了哪几类方向?」
- 「这批工单反映出的主要问题分布是什么?」
这些问题的答案,在原文里根本不存在对应的句子。你没法用「语义相似」去找一个从来没被写下来的结论。
全局性问题的本质是「归纳」,而向量检索只会「匹配」。 这时候把 Top-K 从 5 调到 50,只会让噪声一起变多。
1.4 第三道坎 多跳推理缺少交集机制
再换一个风控场景。你在一家跨国公司做风控,问:
我们公司哪些欧洲供应商,在过去一年的安全审计中没通过,而且还在处理个人隐私数据(PII)?
答对这道题,需要三份文档同时在场:
| 文档 | 提供的信息 |
|---|---|
| 供应商档案 | 哪些供应商是欧洲的 |
| 审计报告 | 哪些供应商没通过审计 |
| 合同文档 | 哪些供应商在加工 PII |
传统 RAG 会把这三类信息分别捞出来:一堆提到「欧洲供应商」的块、一堆提到「安全审计」的块、一堆提到「PII」的块。
但它没有任何机制把这三个集合做交集。
模型拿到的是三堆互相独立的材料,只能自己去猜它们之间的关系。猜对了是运气,猜错了就是编——尤其在专业领域,模型没微调过,这种「硬关联」基本等于瞎扯。
这种「A 关联到 B,B 关联到 C,最后从 A 推到 C」的问题,叫多跳推理(Multi-hop Reasoning)。正确解法是沿着关系一步步走,把召回范围放得更广也没用:
- 先找出所有欧洲供应商;
- 再筛出其中审计没通过的;
- 最后在这些里面找处理 PII 的。
每走一步,候选集合就缩小一圈。这是一次图上的遍历,不是一次向量相似度排序。
1.5 三类问题的共同点
把三道坎放在一起看,会发现它们缺的是同一样东西:
| 问题类型 | 典型问法 | 传统 RAG 的做法 | 失效点 | 可缓解手段 | 能否根治 |
|---|---|---|---|---|---|
| 语义断裂 | 药物 + 禁忌症组合问答 | 召回相邻块 | 关系被切块切断 | 父子块、相邻块合并 | 只能救相邻,长距离无解 |
| 全局归纳 | 「刘备是怎样的人」「主题思想」 | 加大 Top-K | 答案根本不在任何块里 | 摘要类预处理 | 单靠检索无法根治 |
| 多跳推理 | 欧洲 + 审计 + PII 三重过滤 | 多路召回后拼接 | 缺少集合交集与关系遍历 | 查询改写、多轮检索 | 需要显式的关系结构 |
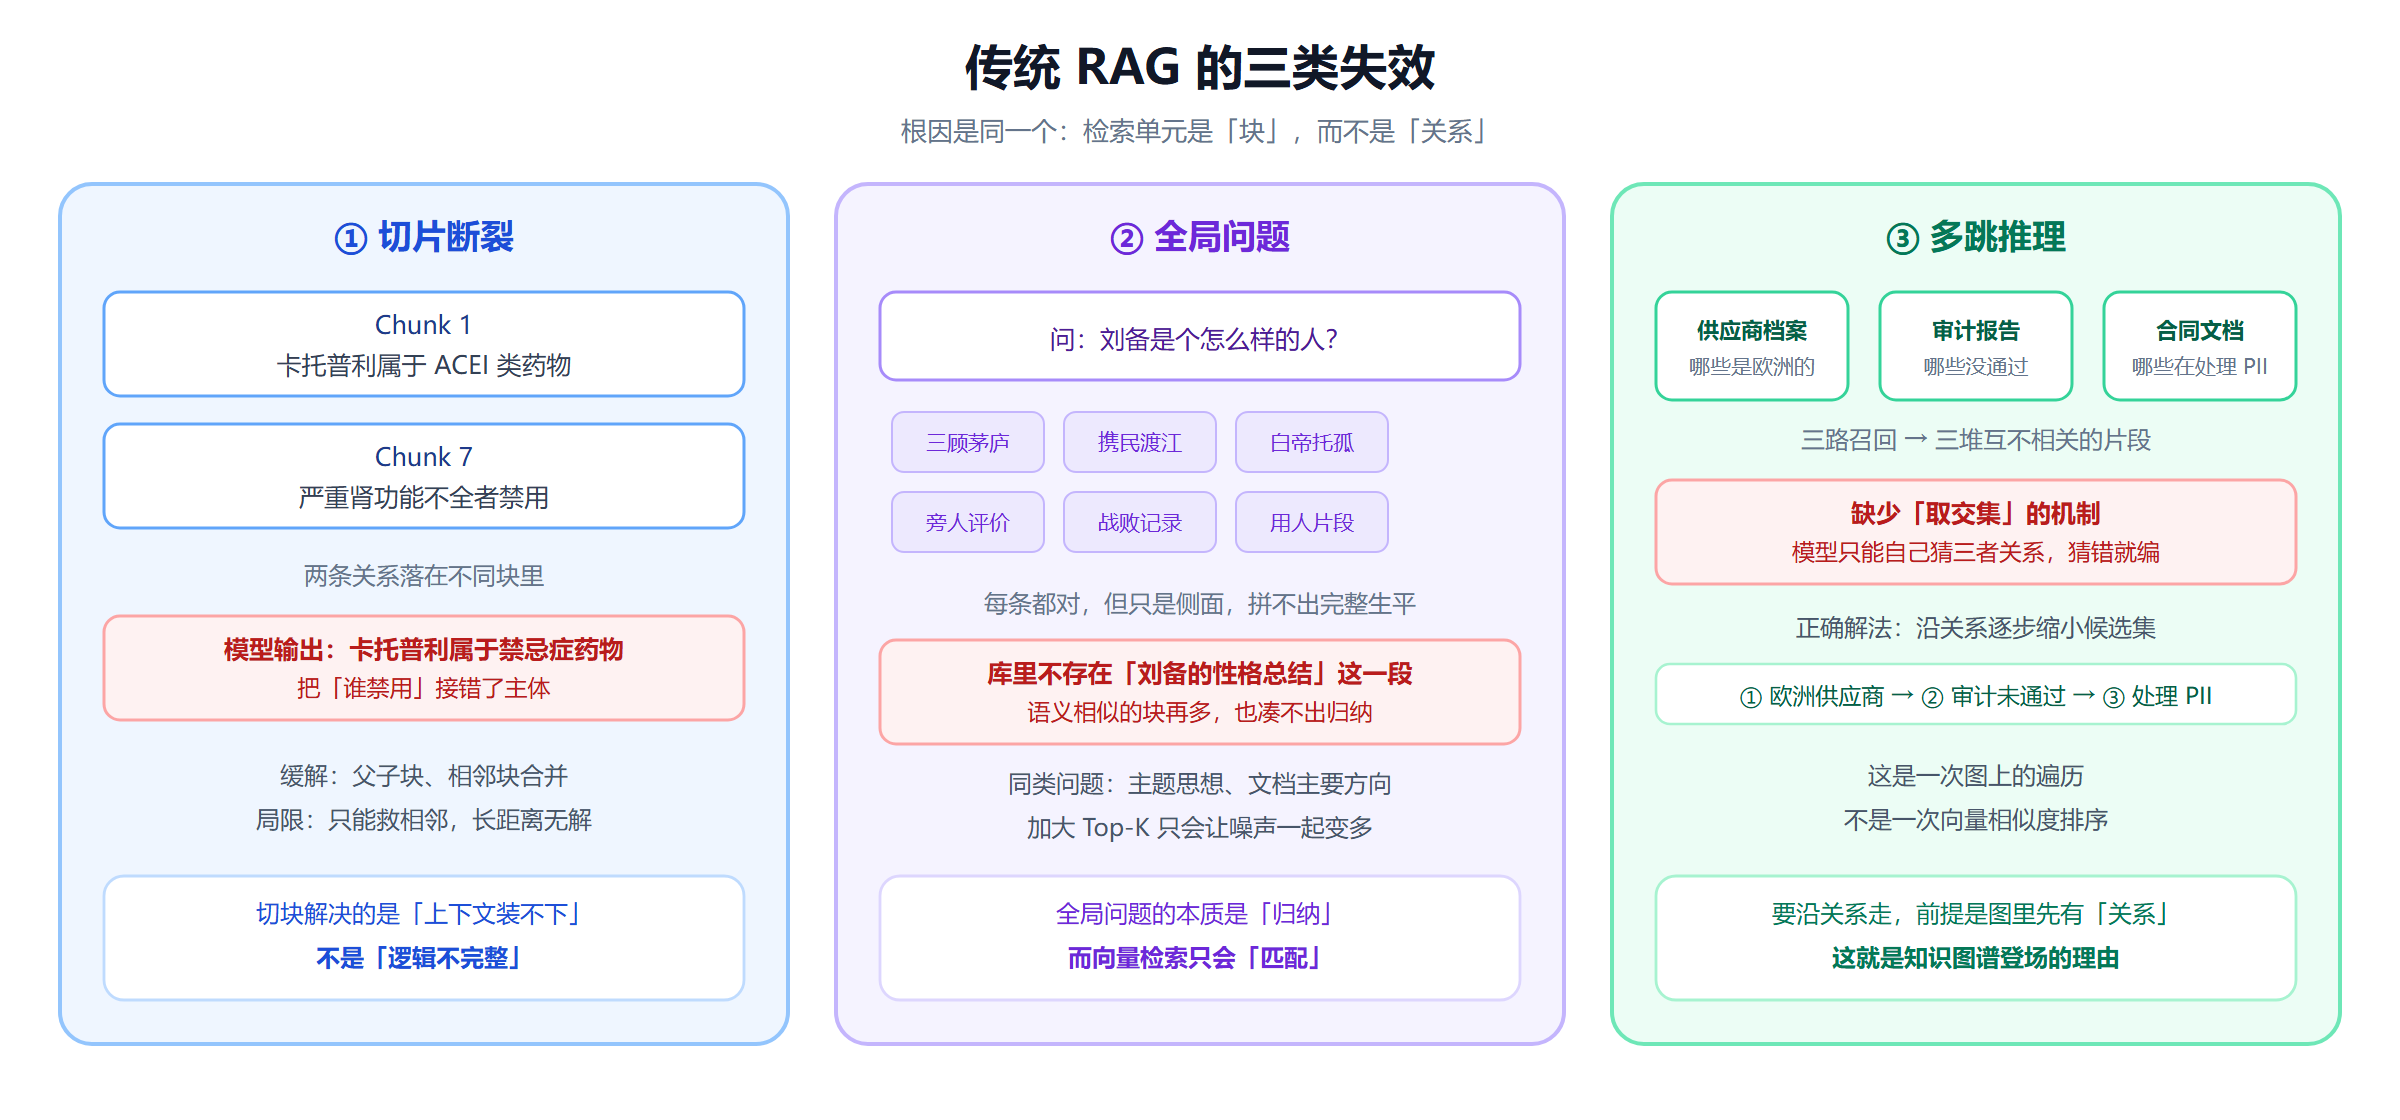
它们缺的都是同一层东西:可查询的关系结构。
这就是知识图谱登场的理由。
二 GraphRAG 与 LightRAG 的两种预算
2.1 GraphRAG 是什么
GraphRAG 由微软研究院在 2024 年提出,论文标题很直白:From Local to Global: A Graph RAG Approach to Query-Focused Summarization(从局部到全局:面向查询摘要的图 RAG 方法)。
它做了一件传统 RAG 不做的事:把语料变成图。
具体分两步。先把每个文本块里的实体和关系抽出来,实体当节点、关系当边,拼成一张知识图谱;再用社区发现算法把这张图切成若干主题簇,为每个簇写一份摘要,也就是社区报告。
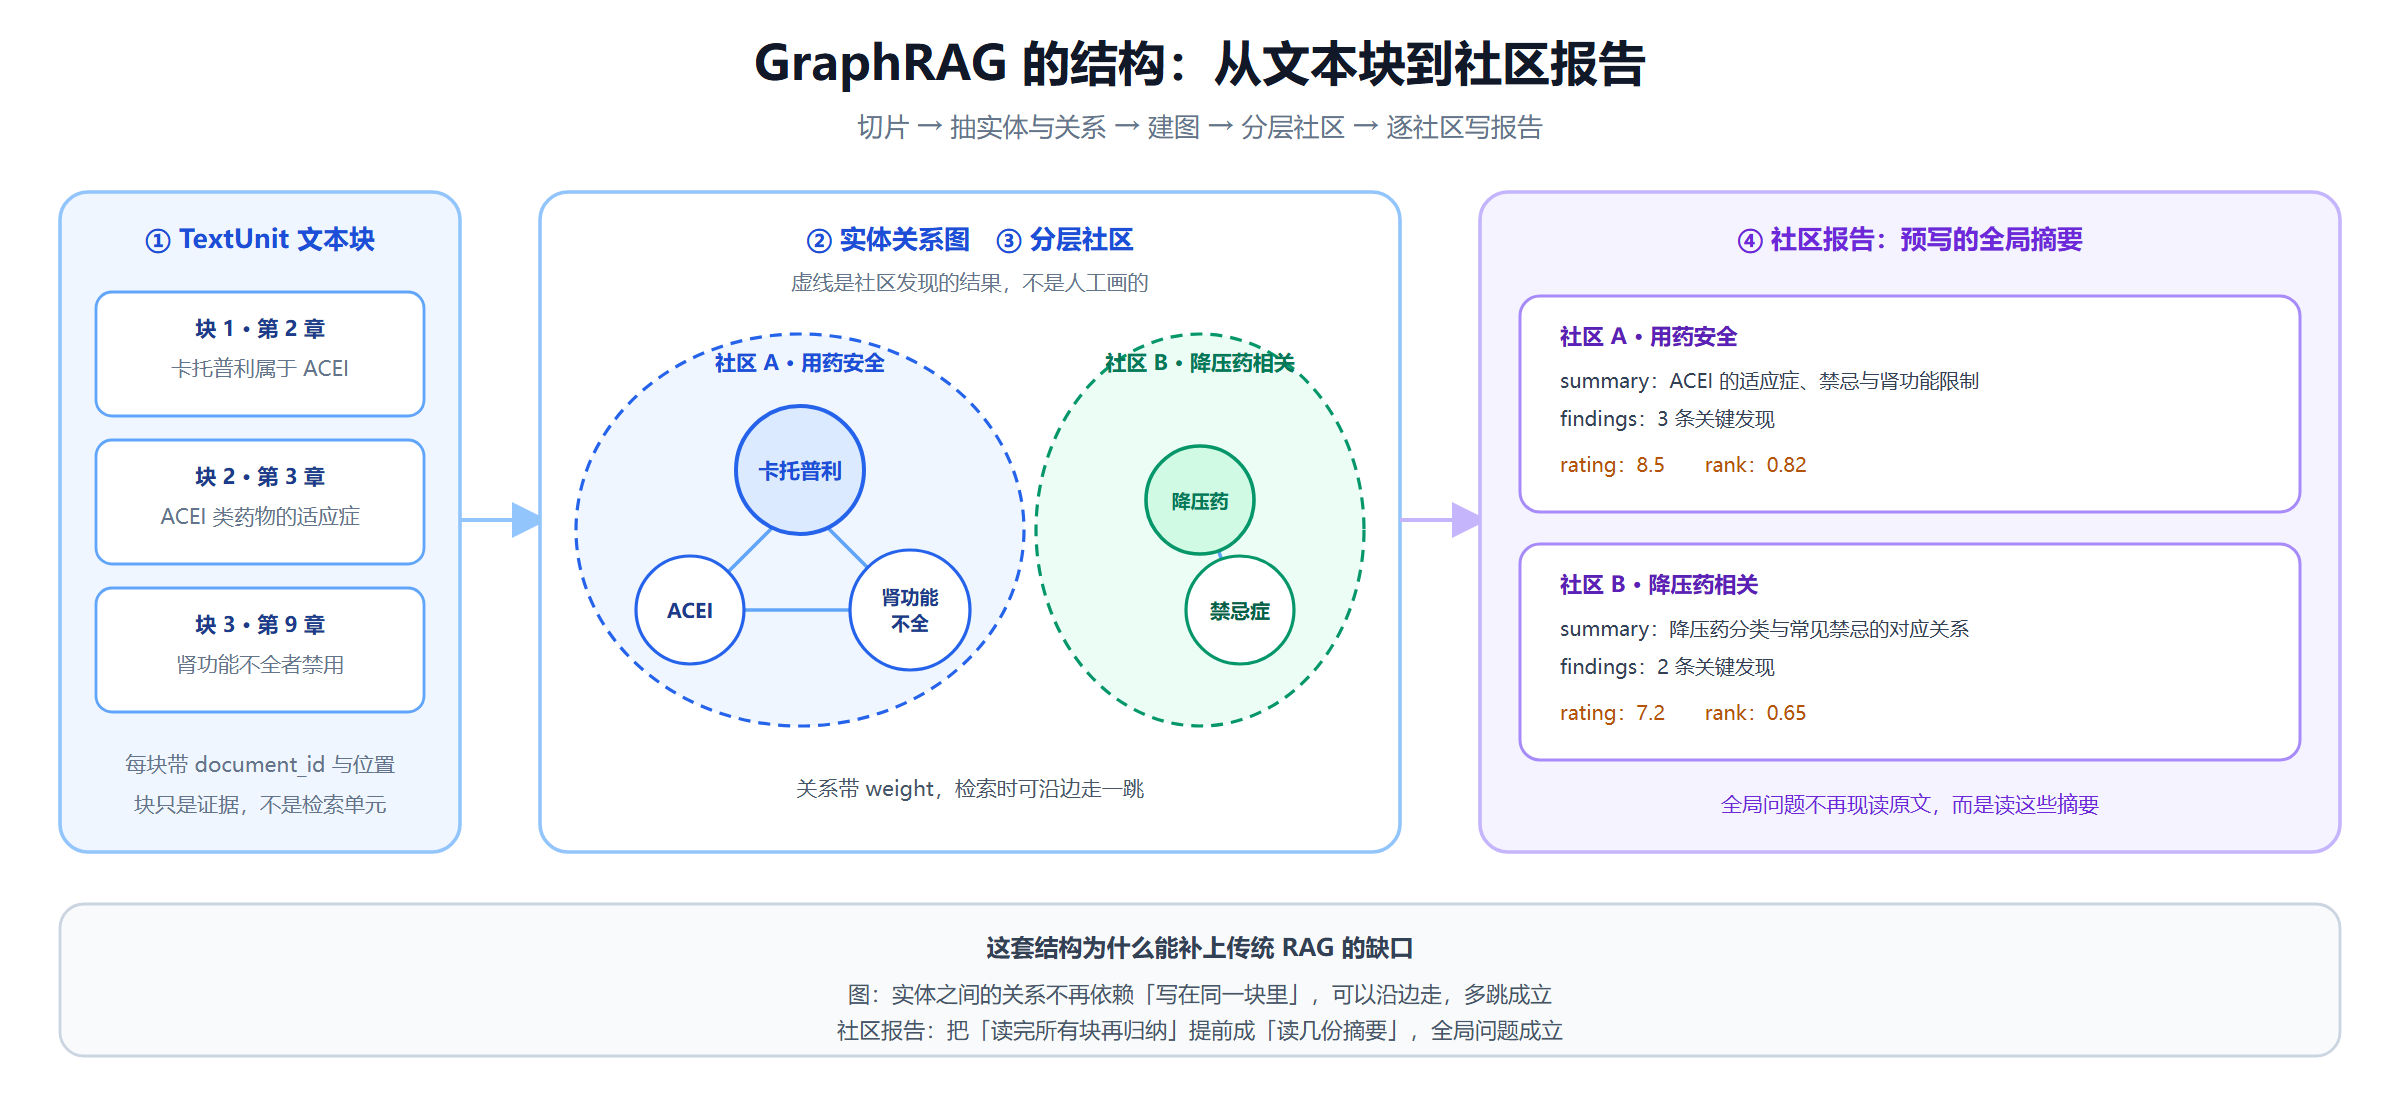
把语料变成一张带层级的实体关系图,并为每个社区预先写好摘要;查询时按「局部」或「全局」两条路取证据。
这张图解决的是关系断裂与多跳。A 和 B 的关系不再要求写在同一段里,只要它们在图上有边,检索就能从 A 走到 B。社区报告解决的是全局归纳:要回答「这批文档讲了哪些方向」,不用现场读完所有块,读几份已经写好的摘要就行。
它瞄准的正是传统 RAG 最无力的那类问题:面向整个语料的归纳与研判。论文里管这个任务叫 query-focused summarization,就是围绕一个问题,把散落各处的信息汇总成一段有结构的回答。
2.2 LightRAG 是什么
LightRAG 由香港大学团队在 2024 年 10 月提出,论文标题同样直白:LightRAG: Simple and Fast Retrieval-Augmented Generation。
它也建图。抽实体、抽关系、合并重复项,这些和 GraphRAG 一样。区别在后面:它不切社区,也不写社区报告。
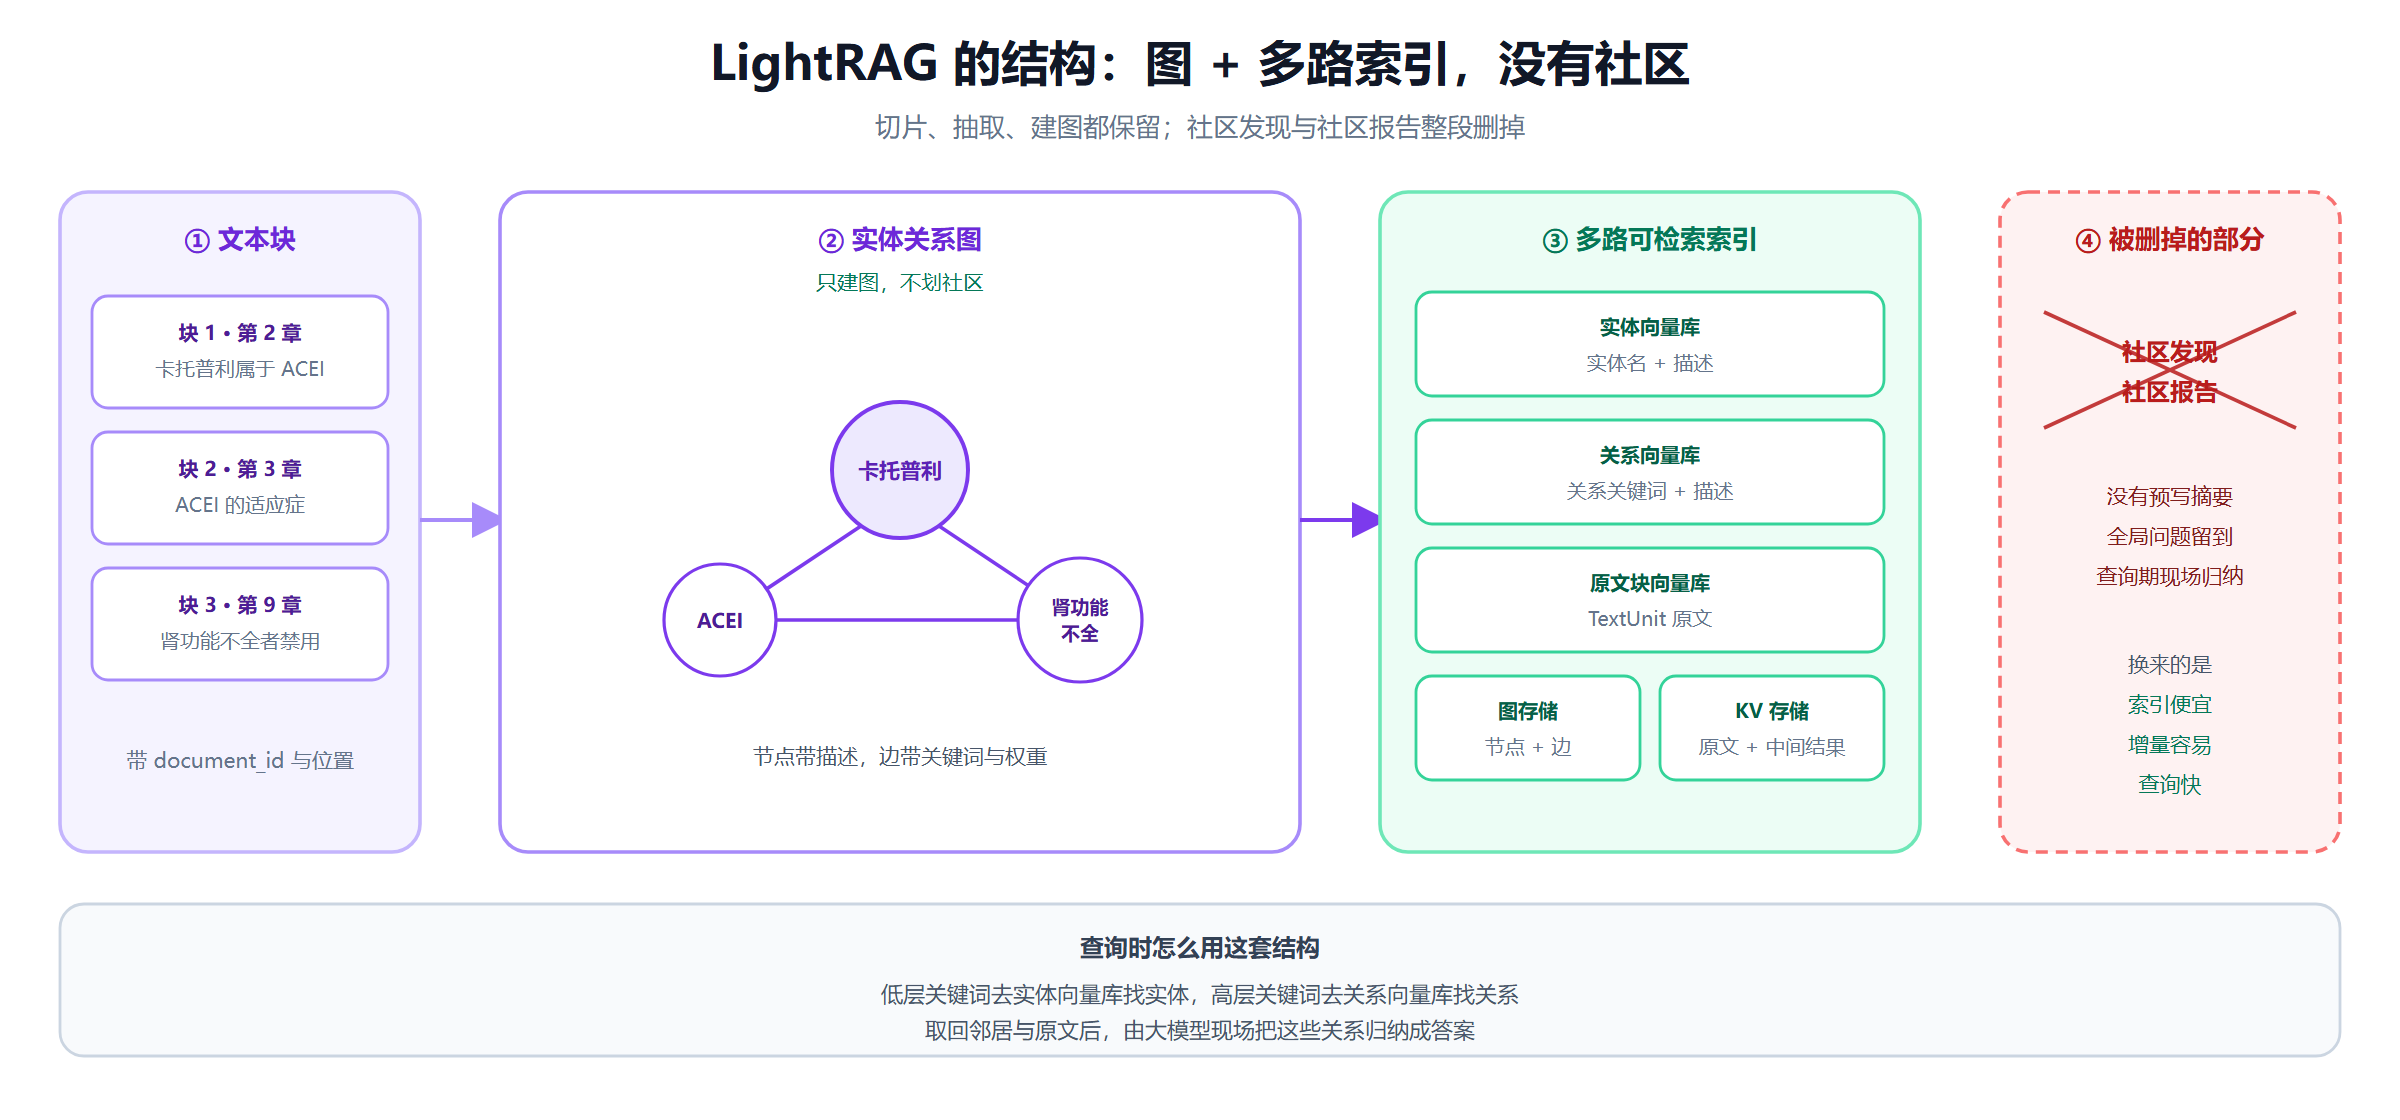
同样建图,但不做社区、不写社区摘要;把实体、关系、原文块都做成可检索的索引,查询时用两层关键词去图里找证据。
那它怎么回答全局问题?靠查询期的两层关键词。用户输入进来,先用 LLM 拆成低层关键词(具体实体、技术概念)和高层关键词(主题、跨实体关系),再去图里分别命中实体和关系,取出它们周围的关系与原文,交给模型现场归纳。
也就是说,LightRAG 不直接检索回一份全局总结。它检索回的是一组和主题相关的关系与事实,总结这一步由大模型在回答时完成。
它要解决的,是 GraphRAG 落地时最疼的几件事:索引太贵、更新太难、全局查询太慢。
2.3 三种检索单元 三条回答路径
把传统 RAG、GraphRAG、LightRAG 放在一起,差别就清楚了。
| 对比项 | 传统 RAG | GraphRAG | LightRAG |
|---|---|---|---|
| 检索单元 | 文本块 | 实体、关系、社区报告 | 实体、关系、原文块 |
| 关系怎么来 | 靠块内共现,切块就断 | 显式抽成边,可沿边走 | 显式抽成边,可沿边走 |
| 全局问题怎么答 | 答不了 | 读预写的社区报告 | 高层关键词找关系,现场归纳 |
| 索引期花什么钱 | 几乎没有 | 抽取 + 合并 + 逐社区写报告 | 抽取 + 合并 |
| 查询期花什么钱 | 一次向量检索 | Local 少,Global 随报告数增长 | 关键词抽取 + 一次检索 + 生成 |
GraphRAG 和 LightRAG 的共同点,是把检索单元从「文本块」换成「实体与关系」。图一旦建起来,三种能力就跟着来了:
- 沿边遍历:从一个实体出发,顺着关系找到它连接的另一批实体,多跳由此成立;
- 结构化聚合:把一片关系聚成一个社区,再从社区层面归纳主题,GraphRAG 走这条;
- 可溯源:每个实体、每条关系都记录了它来自哪个文本块,答案可以带引用。
不同点在全局问题这一步。GraphRAG 把归纳提前做,存成社区报告;LightRAG 把归纳留到查询时做,靠关键词找关系、让模型现场总结。
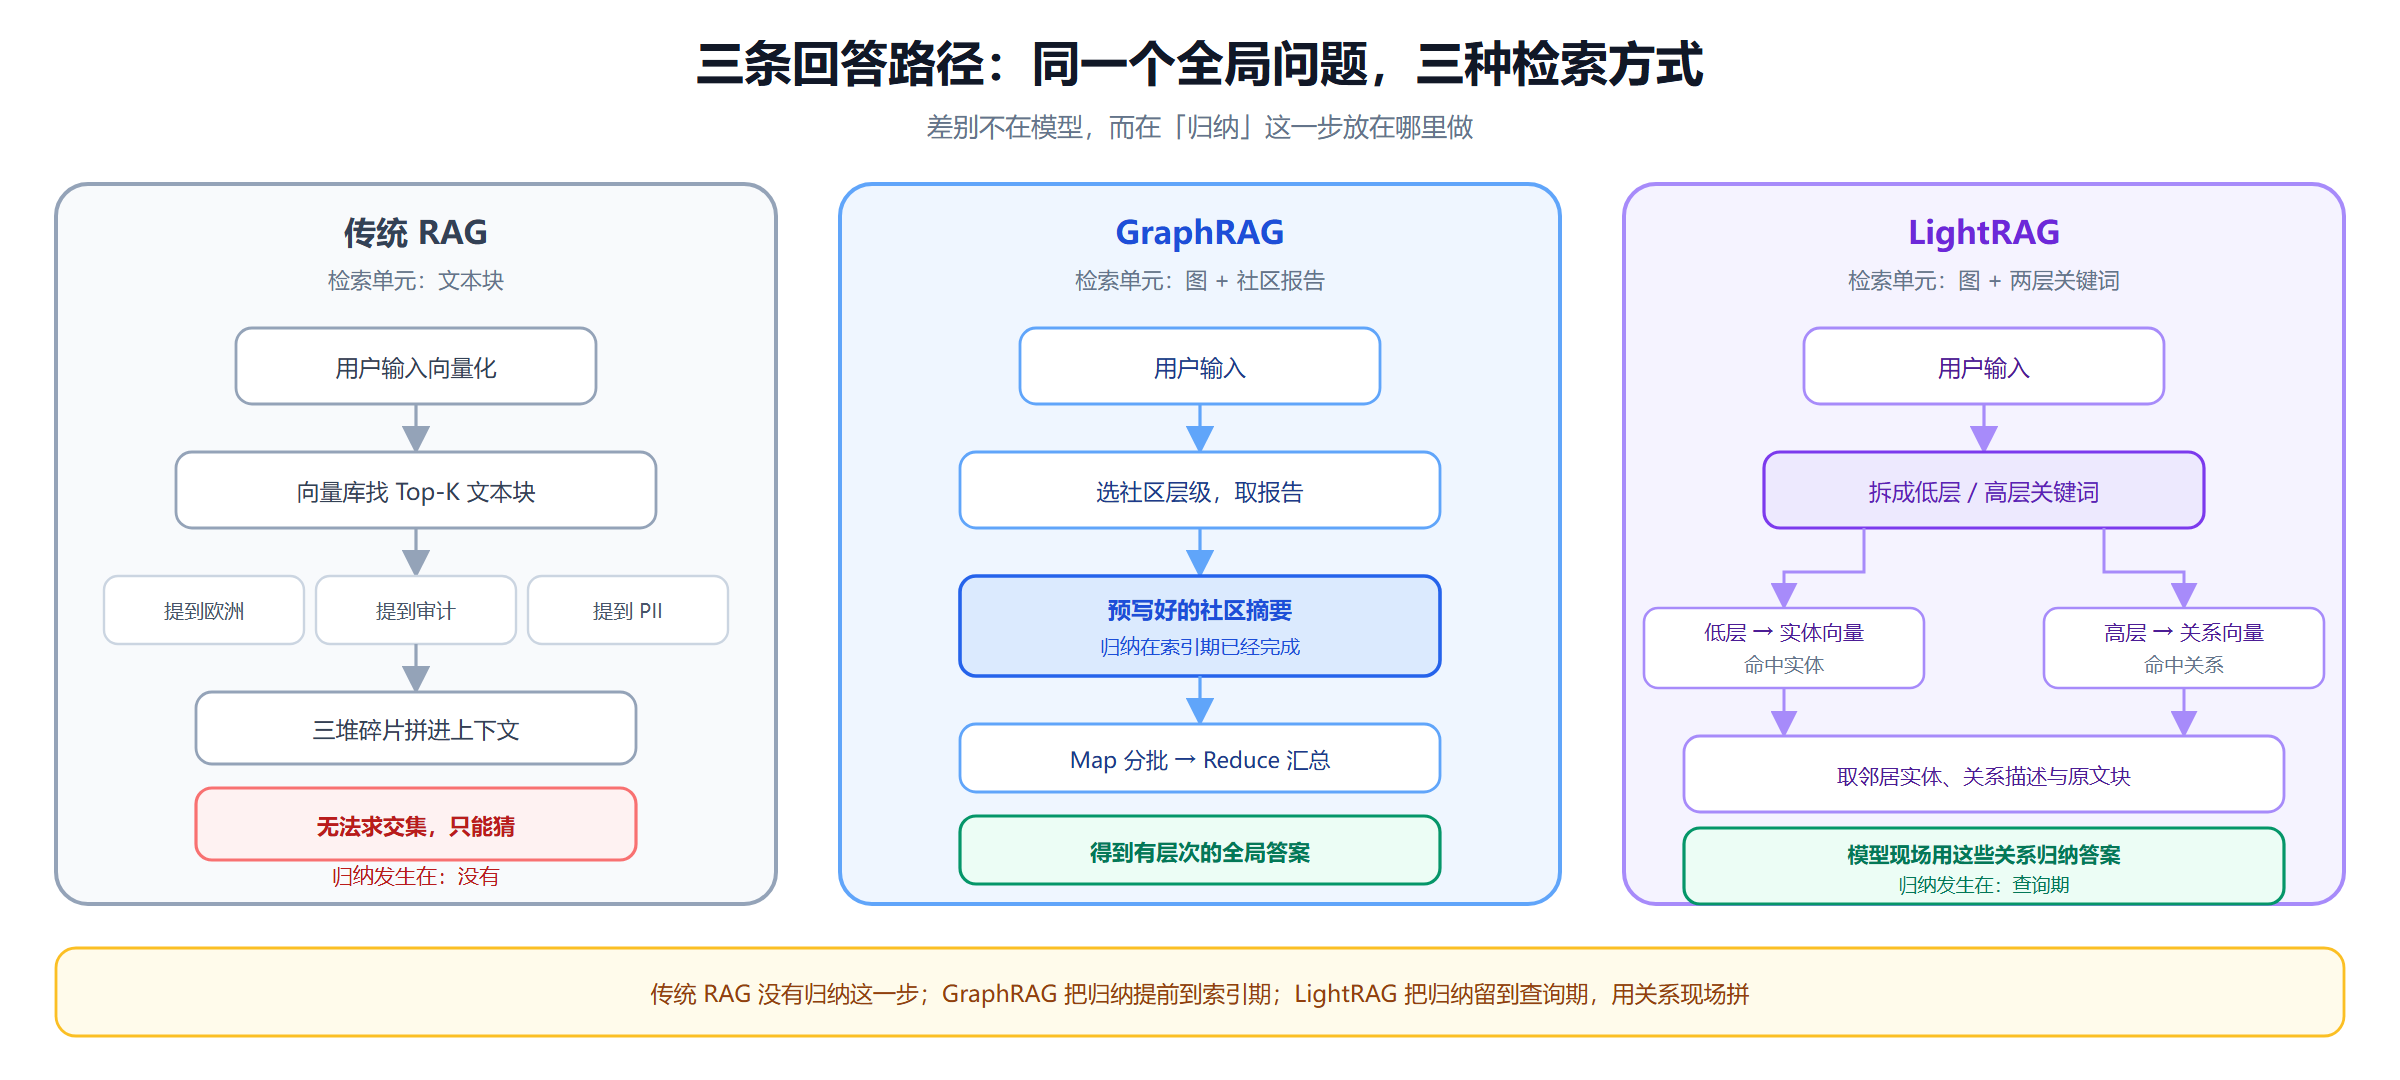
2.4 唯一分歧 全局摘要提前算还是实时算
如果只记一句话,记这句:
GraphRAG 在索引期就把全局摘要算好;LightRAG 不在索引期算,留到查询期现场推理。
这一取舍,直接决定了后面所有差异:
| 选择 | 换来什么 | 付出什么 |
|---|---|---|
| GraphRAG:索引期预计算社区摘要 | 全局问题答得深、答得稳;查询时只做汇总 | 索引贵;新增文档会打乱社区,更新难;全局查询仍要读很多报告 |
| LightRAG:索引期只建图与索引 | 索引便宜;增量更新自然;查询调用次数少 | 全局归纳靠现场拼,深度不如预写摘要 |
所以这两者是同一思路下的两种预算分配,谈不上谁替代谁。
2.5 一张总览图
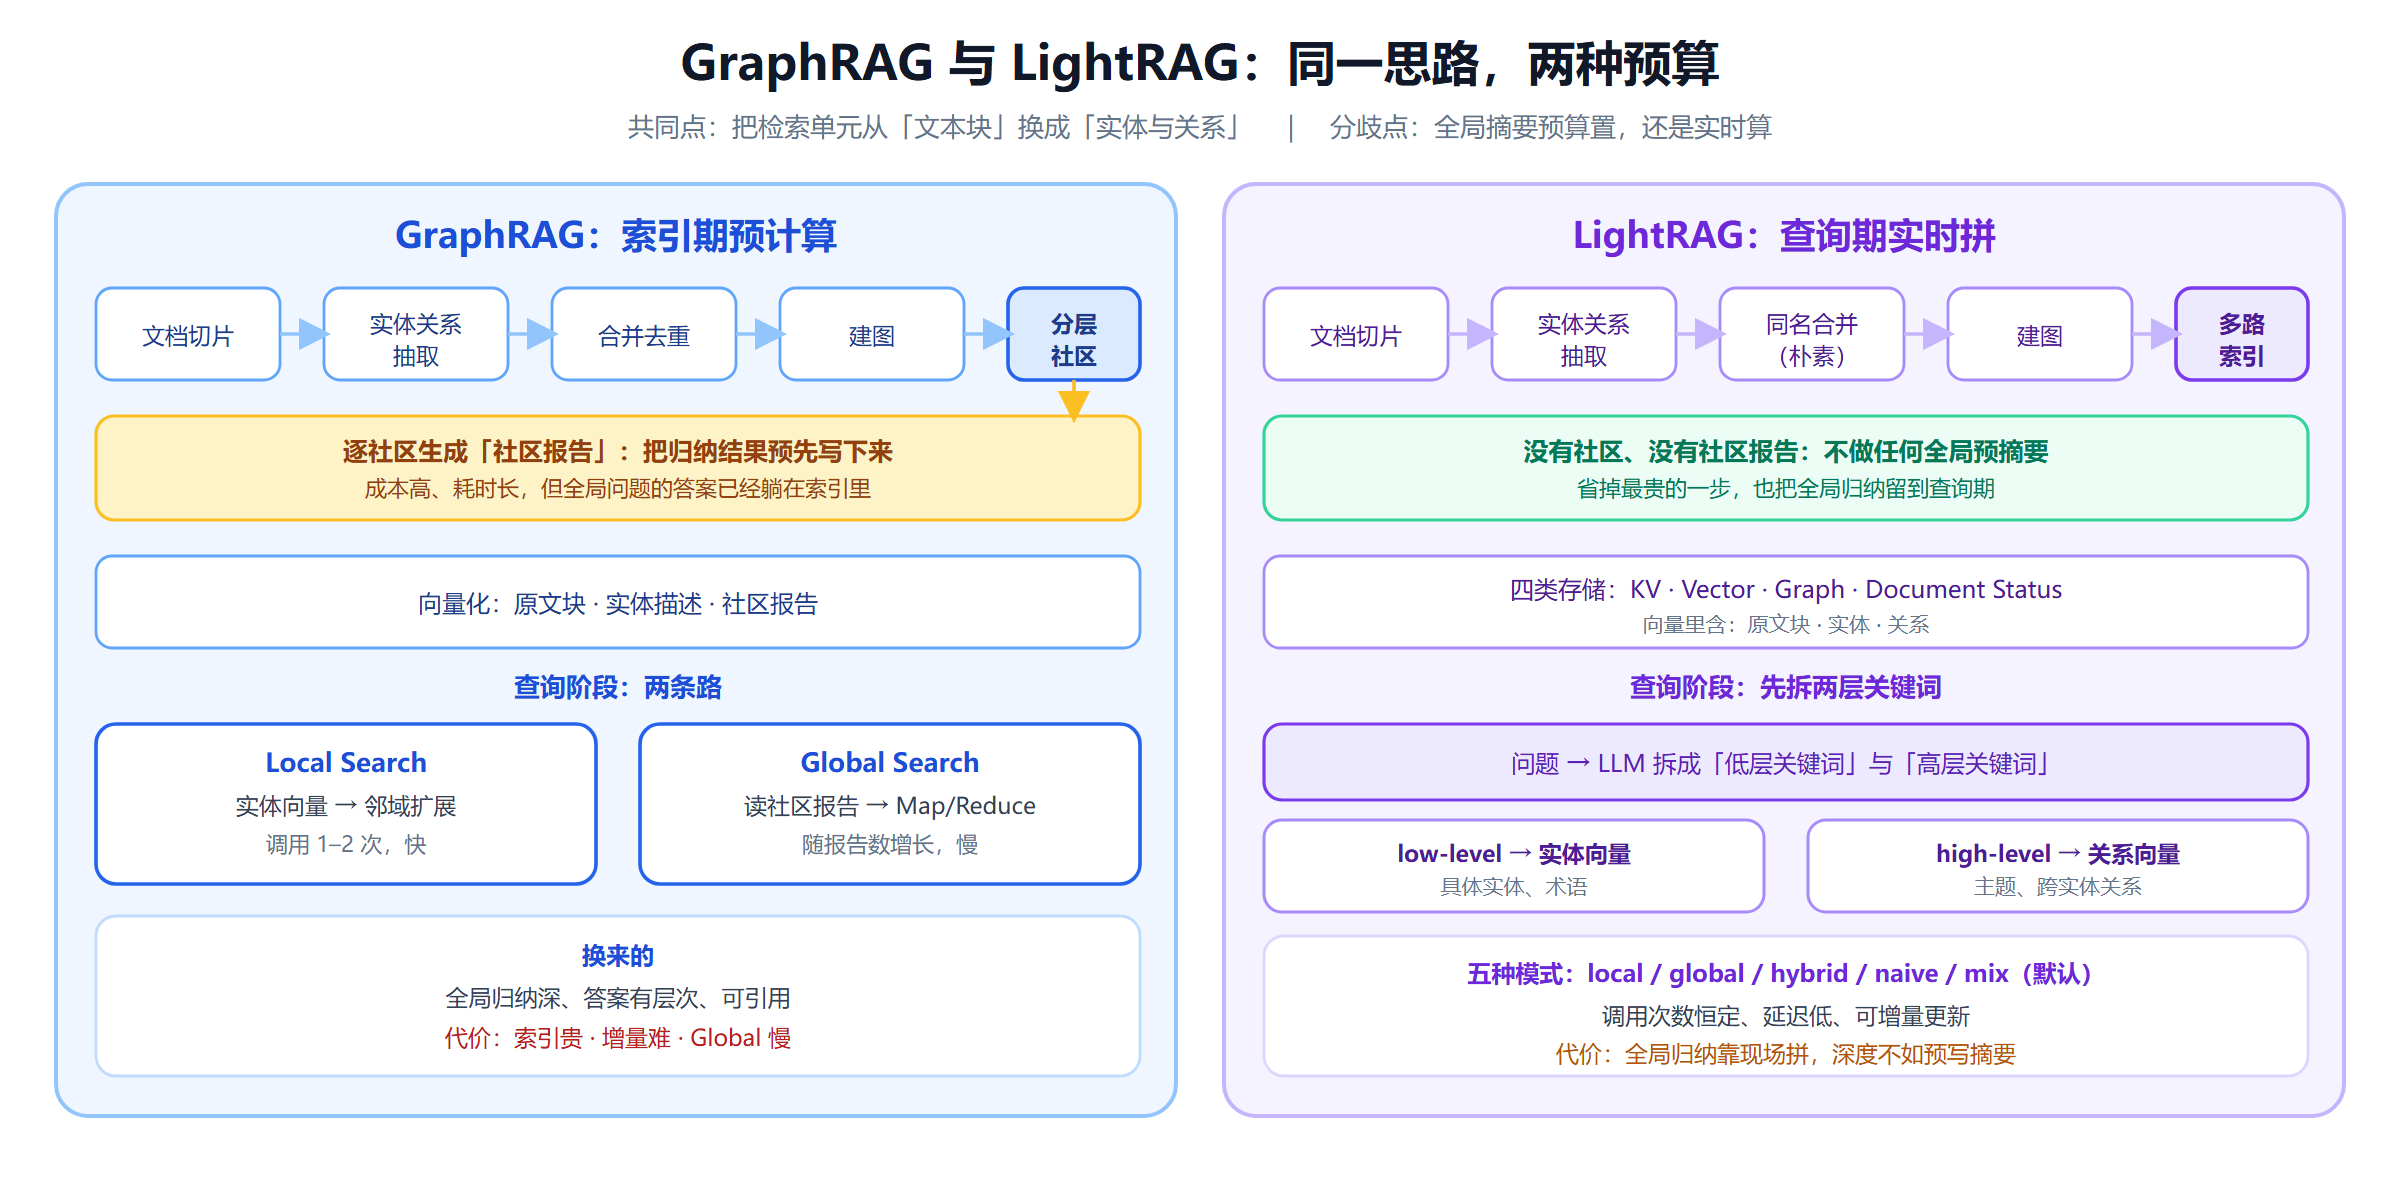
| 对比维度 | GraphRAG | LightRAG |
|---|---|---|
| 核心产出 | 图 + 分层社区 + 社区报告 | 图 + 多路向量索引 |
| 索引成本 | 高(抽取 + 合并 + 逐社区写报告) | 中(抽取 + 合并) |
| 增量更新 | 弱,通常要全量重建 | 强,按文档增量合并 |
| 全局问题 | 强,读预写摘要 | 中,靠高层关键词现场拼 |
| 局部问题 | 强,实体邻域扩展 | 强,实体邻域扩展 |
| 多跳能力 | 强 | 强(依赖抽取质量) |
| 查询延迟 | Global 模式高 | 低且稳定 |
| 工程复杂度 | 高 | 中 |
后面的章节,就是把这张表一格一格填满。
三 GraphRAG 的索引阶段
3.1 七步总览
GraphRAG 的整体流程和传统 RAG 一样,分「离线建库」和「在线查询」两个阶段。索引阶段里,切片这一步完全相同,从第二步的实体关系抽取开始分叉。
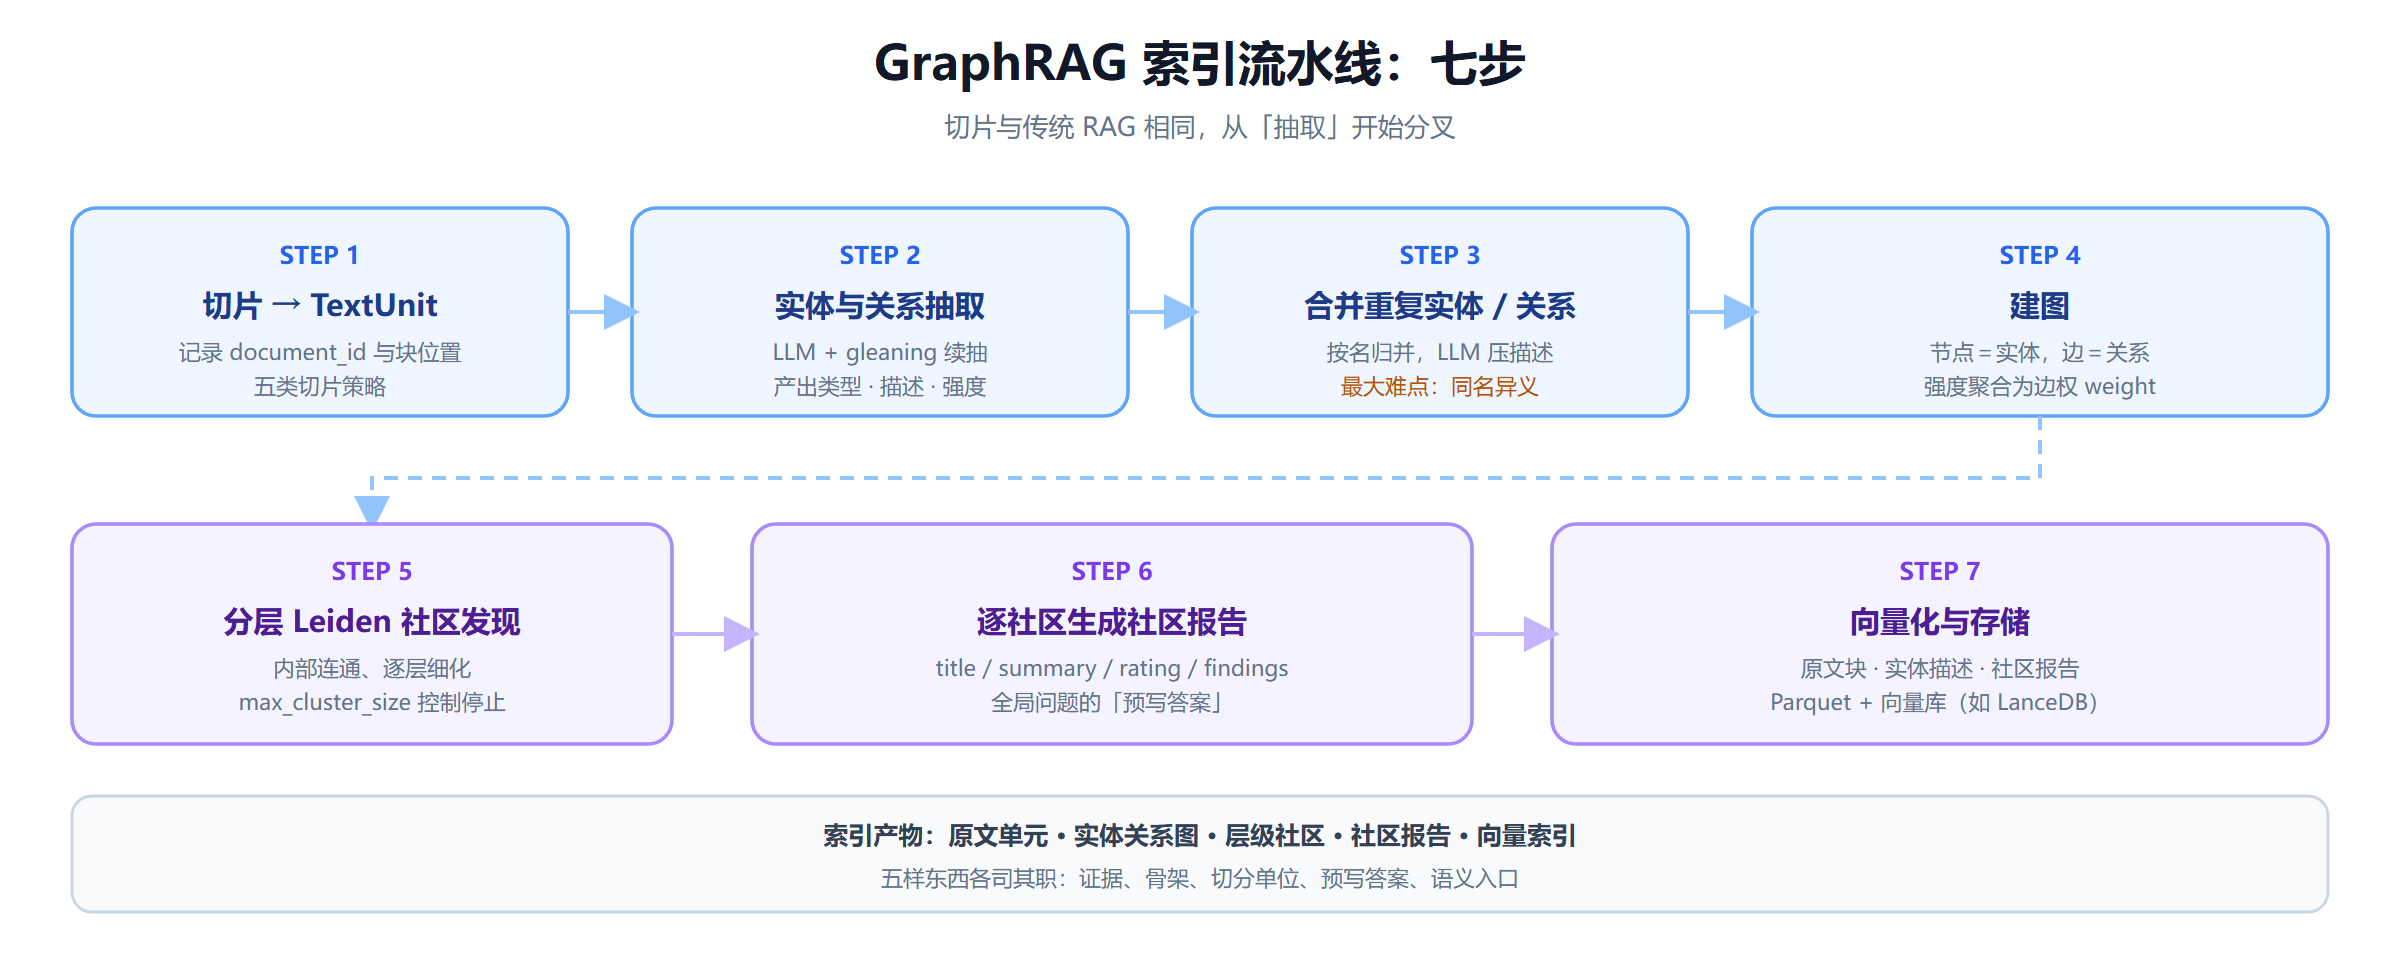
七步分别是:
- 切片,得到 TextUnit;
- 用 LLM 抽取实体与关系;
- 合并重复实体、合并关系描述;
- 建图;
- 分层 Leiden 社区发现;
- 为每个社区生成社区报告;
- 向量化并存储。
每一步留下的产物不一样,串起来看更清楚:
| 步骤 | 输入 | 产出 |
|---|---|---|
| 切片 | 原始文档 | TextUnit,带文档位置 |
| 抽取 | 每个 TextUnit | 实体表、关系表 |
| 合并 | 实体表、关系表 | 去重后的图数据 |
| 建图 | 图数据 | 节点与边 |
| 社区发现 | 图 | 分层社区树 |
| 社区报告 | 每个社区 | 摘要、评分、关键发现 |
| 向量化 | 原文、实体描述、报告 | 语义检索入口 |
3.2 第一步 切片 以及一个容易忽略的细节
为什么还要切? 理由和传统 RAG 完全一致:
- 太长模型处理不了,成本也高;
- 不切的话,检索出来是一整段,相关性很难用向量衡量。
切片策略也还是上篇讲过的那几种,这里只列名字:
| 策略 | 做法 | 适用 |
|---|---|---|
| 固定长度 | 按 Token 数硬切 | 通用兜底 |
| 重叠切分 | 相邻块留一段重叠 | 防止边界信息丢失 |
| 按符号递归切 | 先按段落,再按句号、逗号逐级降级 | 结构化弱的正文 |
| 结构化切分 | 按 Markdown 标题、HTML 标签、表格行切 | 结构清晰的文档 |
| 语义切分 | 先切,再用向量判断相邻块相似度,高则合并 | 主题变化明显的长文 |
| 大模型切分 | 让 LLM 判断该在哪切 | 高价值、低体积语料 |
TextUnit 就是切片之后的文本单元,和传统 RAG 里的 Chunk 是同一个东西,只是 GraphRAG 换了英文叫法。
真正的差异在切完之后做了什么。
传统 RAG 切完就直接向量化入库。GraphRAG 切完,先建立第一层映射:每个 TextUnit 记下它属于哪份文档、在原文里的位置。
- document_id:它来自哪份文档;
- chunk 位置:它在原文里的顺序与偏移。
这层映射解决的是「这个块在哪儿」。
到第二步抽取时,还会建立第二层映射:每个实体、每条关系都记下自己出现在哪些 TextUnit 里,通常叫 text_unit_ids。这层映射解决的是「这个实体的话是从哪几块抽出来的」。
两层映射不能混。第一层是块到文档,第二层是实体到块。合起来,才能做到答案回溯和引用:模型说「卡托普利属于 ACEI」,你能顺着实体找到它来自第 2 章那个块。
没有这层回溯,图谱就只是空中楼阁。
3.3 第二步 实体与关系抽取
这是 GraphRAG 与传统 RAG 的第一个分水岭。
它拿每个 TextUnit 去问大模型:这段话里有哪些实体?它们之间是什么关系?
Prompt 大致长这样:
1 | 你是一个实体关系抽取助手。请从下面的文本中: |
对一份讲智能体的文档,抽出来的实体可能是:
| 实体名 | 类型 | 描述 |
|---|---|---|
| ReactAgent | 软件组件 | 负责根据任务调用能力与工具的智能体组件 |
| 工具 | 能力 | 执行特定操作或获取外部数据的组件 |
| Skill | 能力封装 | 封装某类领域逻辑、可被智能体选择调用的单元 |
抽出来的关系整理成结构后,大致是:
1 | { |
这里有两个容易踩的细节:
- 分隔符是 <|>,不是竖线字符。GraphRAG 用这个三元组风格的分隔符,是为了避开正文里常见的竖线、逗号,减少解析歧义。
relationship_strength是 Prompt 里的字段名,到了输出里它就是第 5 个位置参数,不是 JSON 的 key。入图之后,多条同源同目标的关系强度会被聚合成这条边的 weight,后续社区发现和邻域排序都会用到它。
工程上还会补两个动作:
- gleaning(续抽):第一轮抽完,再追问一句「还有很多实体被漏掉了,请补抽」,把漏网的实体和关系捞回来。
- 类型限定:把
entity_type收窄到本领域的几个固定类型(人物、组织、地点、事件……),能显著降低噪声。
抽取质量决定了整张图的上限。 这一步漏掉的关键实体,后面任何环节都补不回来。
3.4 第三步 合并重复实体与关系
同一份文档里,一个实体往往在多个块中出现。每个块都会抽出一份描述,于是图里会出现同一个实体的好几条记录。
GraphRAG 的做法是按实体名归并,再让 LLM 把这些描述压成一条更完整的综合描述,关系描述同理。
听起来简单,但这里藏着一个非常棘手的问题。
同名不等于同义。
假设文档 A 是智能体技术文档,里面的「工具」指的是智能体可以调用的外部能力,比如搜索、代码执行。文档 C 是设备维修文档,里面的「工具」指的是扳手、螺丝刀。
两个都叫「工具」。如果按名字合并,智能体的「工具」就会被塞进一条「维修工具」的描述里,整张图从这里开始失真。
反过来也一样:同一个东西可能有多个名字。英文文档写 Tool,中文文档写「工具」,如果不做跨语言、跨表述的归一,图里就会长出两个互不相连的节点,多跳链路直接断掉。
这是图构建里最难的一步,没有之一。 具体的处理办法放到第五章讲,这里先记住:合并策略决定了这张图是「知识」还是「噪声」。
3.5 第四步 建图
合并完之后,图就成形了:
- 节点:实体,带名称、类型、描述;
- 边:关系,带描述、强度(聚合为权重);
- 附属信息:每个实体和关系都挂着一组
text_unit_ids,指回原始文本块。
到了这一步,原本线性排列的文档,变成了一张可以遍历的网络。
3.6 第五步 分层社区发现
图建好了,但规模很大。接下来要回答一个关键问题:这张图里,哪些部分在讲同一件事?
这就轮到社区发现(Community Detection)。
社区在图论里指的是:内部连接紧密、与外部相对区分的一组节点。
假设现在有这样的实体关系图:
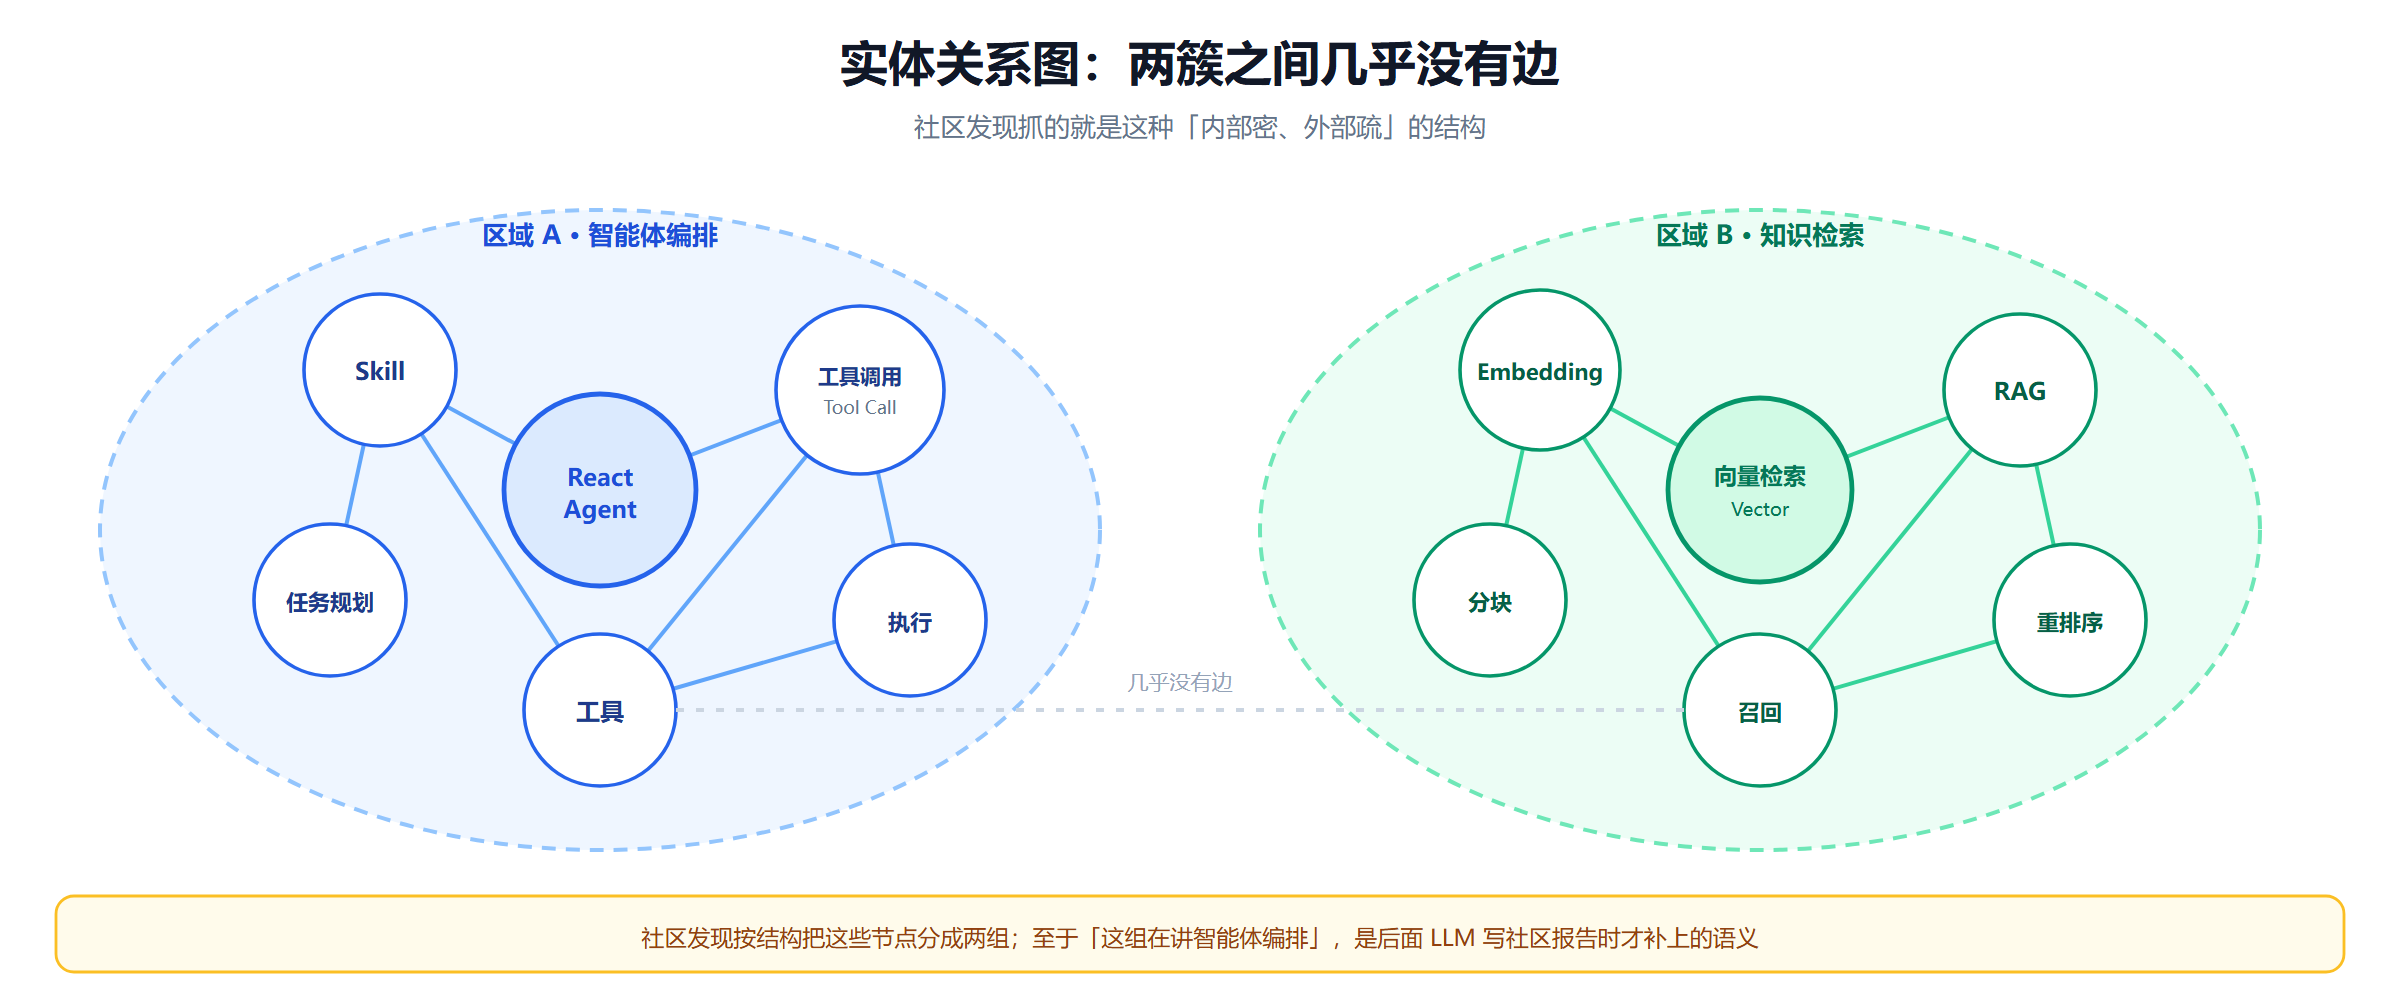
左边一簇围绕智能体编排:ReactAgent 连着 Skill,Skill 又连着任务规划和工具。右边一簇围绕知识检索:Embedding 连着向量检索,向量检索连着 RAG,RAG 连着重排序。
两簇之间几乎没有边。这种「内部密、外部疏」的结构,就是社区发现要抓的东西。
GraphRAG 用的是分层 Leiden 算法。它和普通聚类最大的区别是:普通聚类一次分完,它要分出多层。
- 第 0 层:整个图,最大的社区;
- 第 1 层:把大社区再拆成中等社区;
- 第 2 层、第 3 层:继续往下拆,直到每个社区规模都不超过阈值(
max_cluster_size)。
于是就得到一棵社区树:上面粗、下面细。
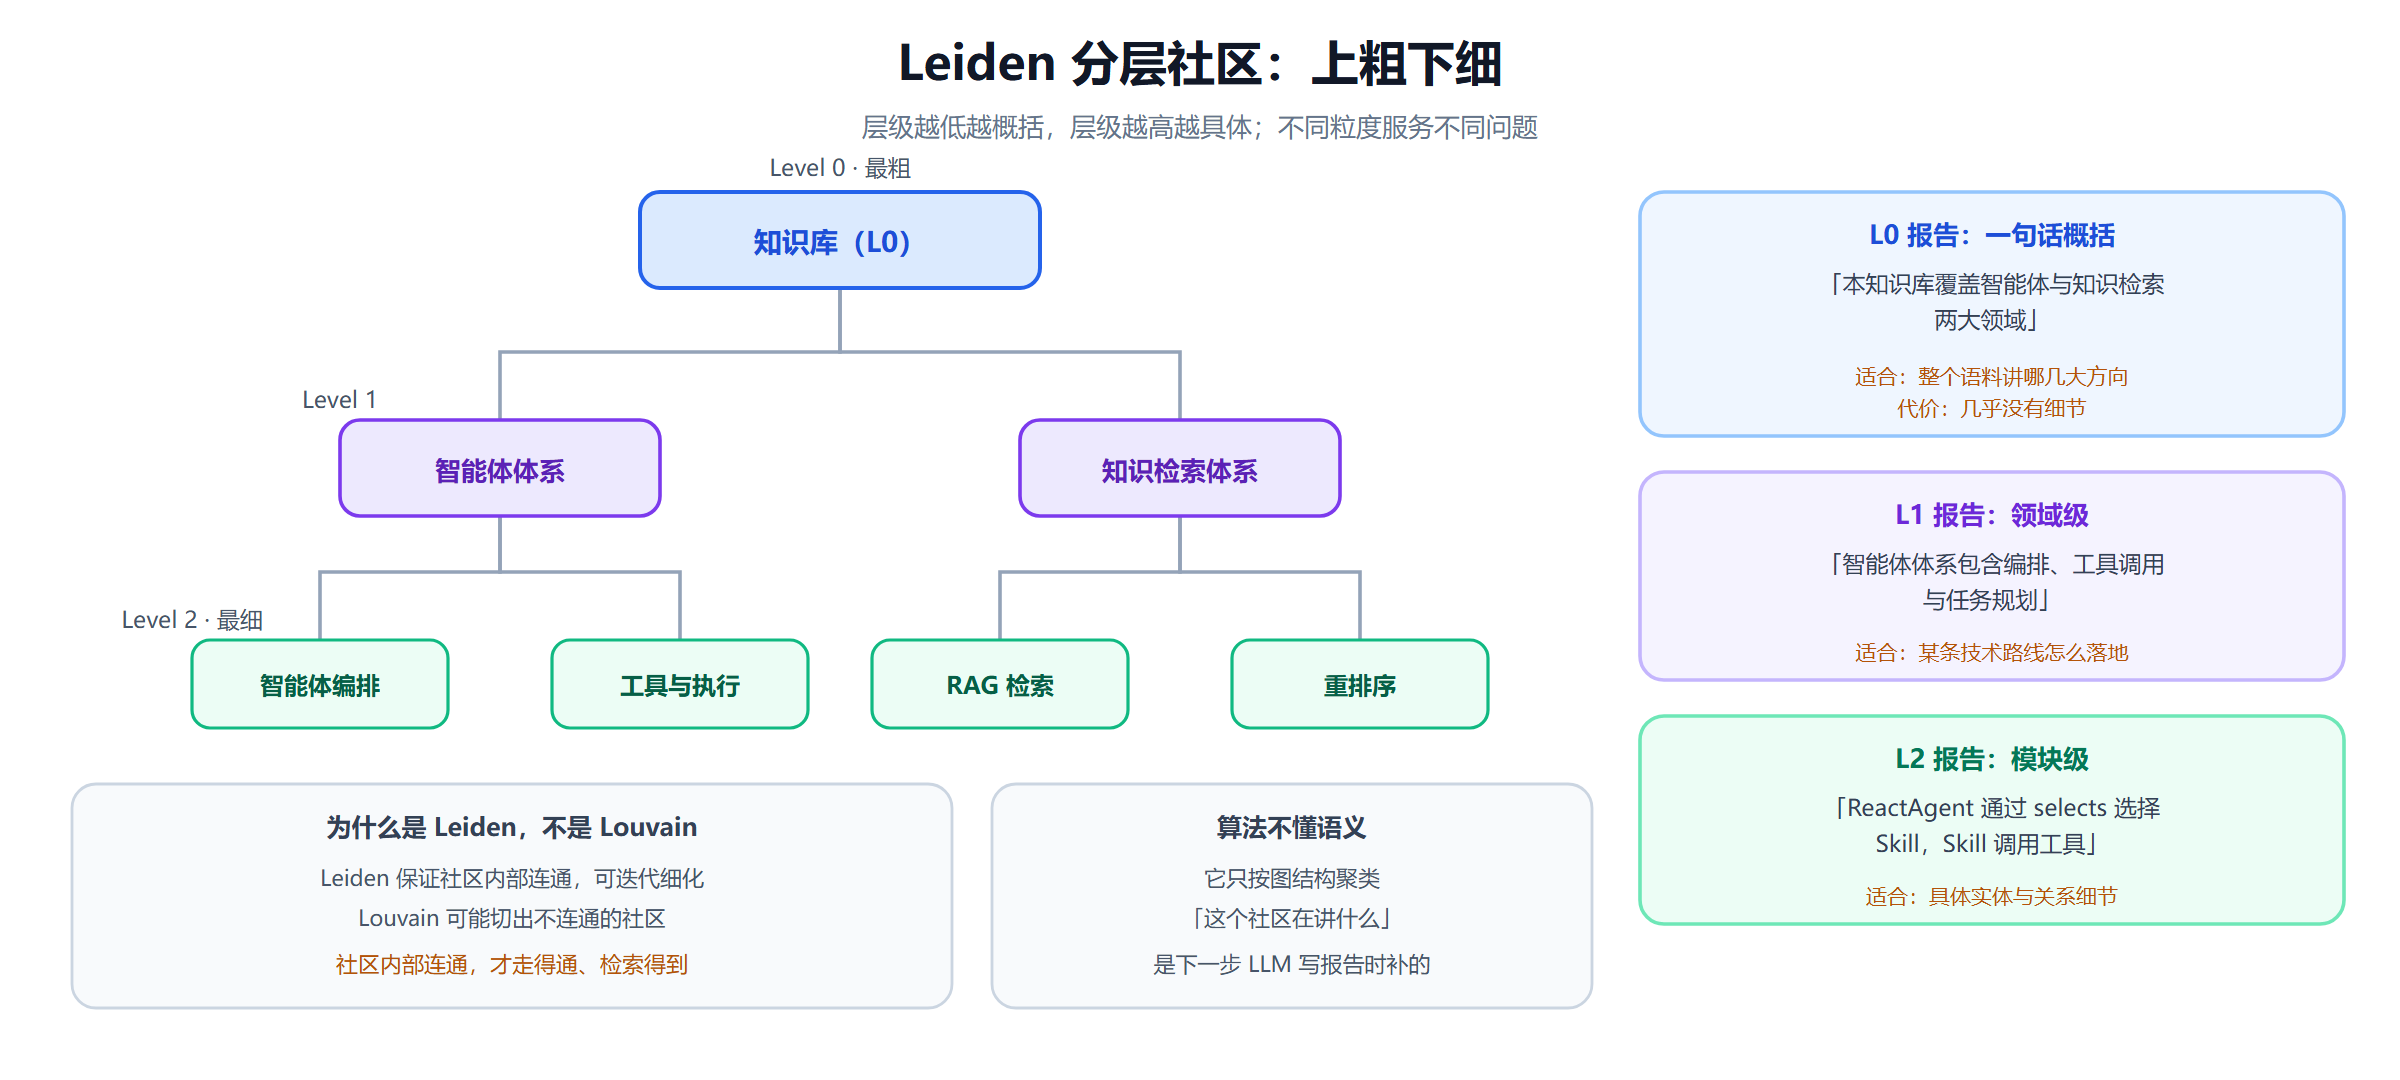
为什么一定要分层? 因为不同粒度服务不同问题:
- 问「这套文档主要讲哪几个方向」,需要看上层的粗粒度社区;
- 问「智能体编排具体怎么做」,需要看下层的细粒度社区。
为什么是 Leiden,而不是更常见的 Louvain? 关键在于连通性。Louvain 有可能切出内部不连通的社区,甚至把本该连在一起的节点强行拆散;Leiden 在此基础上做了细化与保证,产出的社区内部是连通的,而且层级结构更稳定。对一个要拿来做检索的图来说,「社区内部连通」不是学术洁癖,而是检索时能不能顺着边走通的实际问题。
还有两个工程参数值得知道:
max_cluster_size:控制继续往下拆的停止条件,太大会让摘要变粗,太小会让社区数量爆炸;use_lcc:只处理最大连通分量,把游离的孤立节点排除掉,避免它们污染社区划分。
3.7 第六步 社区报告
对每一个社区,GraphRAG 让 LLM 读它的成员实体、成员关系和原文片段,然后写一份社区报告(Community Report)。
报告的结构大致是:
| 字段 | 含义 |
|---|---|
| title | 社区标题,比如「智能体能力编排」 |
| summary | 社区摘要,一段概括性描述 |
| rating | 重要度评分 |
| rating_explanation | 评分理由 |
| findings | 关键发现列表,每条含 summary 与 explanation |
一份报告实际生成出来,结构是这样:
1 | { |
落盘到 parquet 后,每条报告还会带上 community、parent、children、level、rank、full_content 这些字段。rating 是模型给的重要度评分,rank 是按成员实体显著度算出的相关性排序,两者不是一回事。
这就是 GraphRAG 全局能力的来源。
原本要回答「这套文档讲了哪些方向」,模型得读完几十上百个块才能归纳;现在它只需要读几份已经写好的摘要。
代价也很明确:摘要必然丢细节,而且越靠近根部越抽象。 一份写到第 0 层的报告,可能只剩下「本知识库涉及智能体与检索两大领域」这种粒度,具体到「Skill 怎么选」就答不了了。
3.8 第七步 向量化与存储
最后一步和传统 RAG 很像,只是要向量化的东西变多了。GraphRAG 默认会为三类内容建向量索引:
- TextUnit 的原始文本;
- 实体的描述;
- 社区报告的文本。
存储上通常是两层:结构化数据(实体、关系、社区、报告)落成 parquet 文件,向量落进 LanceDB 之类的向量库。
至此,索引阶段完成。这个索引里同时躺着五样东西:
| 产物 | 作用 |
|---|---|
| 原始文本单元 | 最终证据与引用来源 |
| 实体与关系图 | 多跳遍历的骨架 |
| 层级社区 | 全局归纳的切分单位 |
| 社区报告 | 全局问题的预写答案 |
| 向量索引 | 语义入口,用来找到第一个实体或第一份报告 |
四 GraphRAG 的查询阶段
索引建好之后,查询分两条路:
- Local Search:从具体实体出发;
- Global Search:从整个知识库出发。
官方后来还补了一个 DRIFT Search,思路是先做一轮全局定位方向,再在局部深挖,用来补 Global 太粗、Local 太窄的问题。它的本质仍是这两条路的组合,理解了前两者,DRIFT 自然就懂了。
4.1 Local Search 从具体实体出发
适合的问题长这样:「ReactAgent 和 Skill 是什么关系?」「卡托普利的禁忌症有哪些?」
第一步,把用户输入变成向量,去实体库里找一批实体。
注意是一批,不是一个。实体向量库会返回 Top-K 个候选,常见配置在 10 个上下。返回多个的原因很直接:一个问题往往牵扯多个实体,「卡托普利的禁忌症」里,卡托普利是主实体,但「禁忌症」「ACEI」这些概念也会命中相关实体。只取一个,很容易一开头就走偏。
匹配时看的是实体名与描述,不是只比名字。名字只差一个字,含义可能天差地别,描述才是语义的主体。
第二步,以这批实体为起点,各取一跳邻居。
一跳的意思是:只沿一条边扩一层,不递归。对每个命中实体,取它直接相连的关系,以及这些关系另一端的实体。
为什么要限定一跳?因为两跳、三跳会让候选数量指数级膨胀,噪声也跟着进来。GraphRAG 的 Local 设计是「以命中实体为中心的邻域」,不是全图遍历。多跳问题靠的是一次命中多个关键实体,再让它们的邻域在候选池里交汇,不是从单个实体一路走到底。
除了邻居实体和关系,还要收三样东西:
- 这些实体所属社区的报告,给模型一个该实体所在主题的背景;
- 关系对应的原文 TextUnit,实体描述是压缩过的,细节要原文兜底;
- 实体自身的描述,用来判断它到底是不是问题要找的那个东西。
第三步,把候选池收窄。
此时手里有四类材料:实体描述、关系描述、社区报告、原文块。全塞进去会撑爆上下文,所以要过三道闸。
- 排序:按与用户输入的相关度排序,关系权重也参与打分;
- 阈值:低于阈值的一律丢弃,宁可少给,不给错;
- 预算:给不同类型的材料分配 Token 配额。
一个常见的预算划分示例:
| 材料类型 | Token 预算 | 占比 |
|---|---|---|
| 原始文本块 | 4000 | 50% |
| 实体与关系 | 3200 | 40% |
| 社区报告 | 800 | 10% |
假设总预算 8000 Token,就按这个比例分别截断。先排序、再按类型配额裁剪,能保证每一类证据都有位置,不会被某一类挤爆。原文占比最高,是因为最终答案必须落在事实上;社区报告占比最低,是因为它只起背景作用。
第四步,按模板组装,交给模型。
把筛选后的实体描述、关系描述、社区报告、原文片段按固定顺序拼好。顺序通常是「实体 → 关系 → 社区背景 → 原文证据」,让模型先知道有哪些节点、它们怎么连,再看背景,最后读原文。
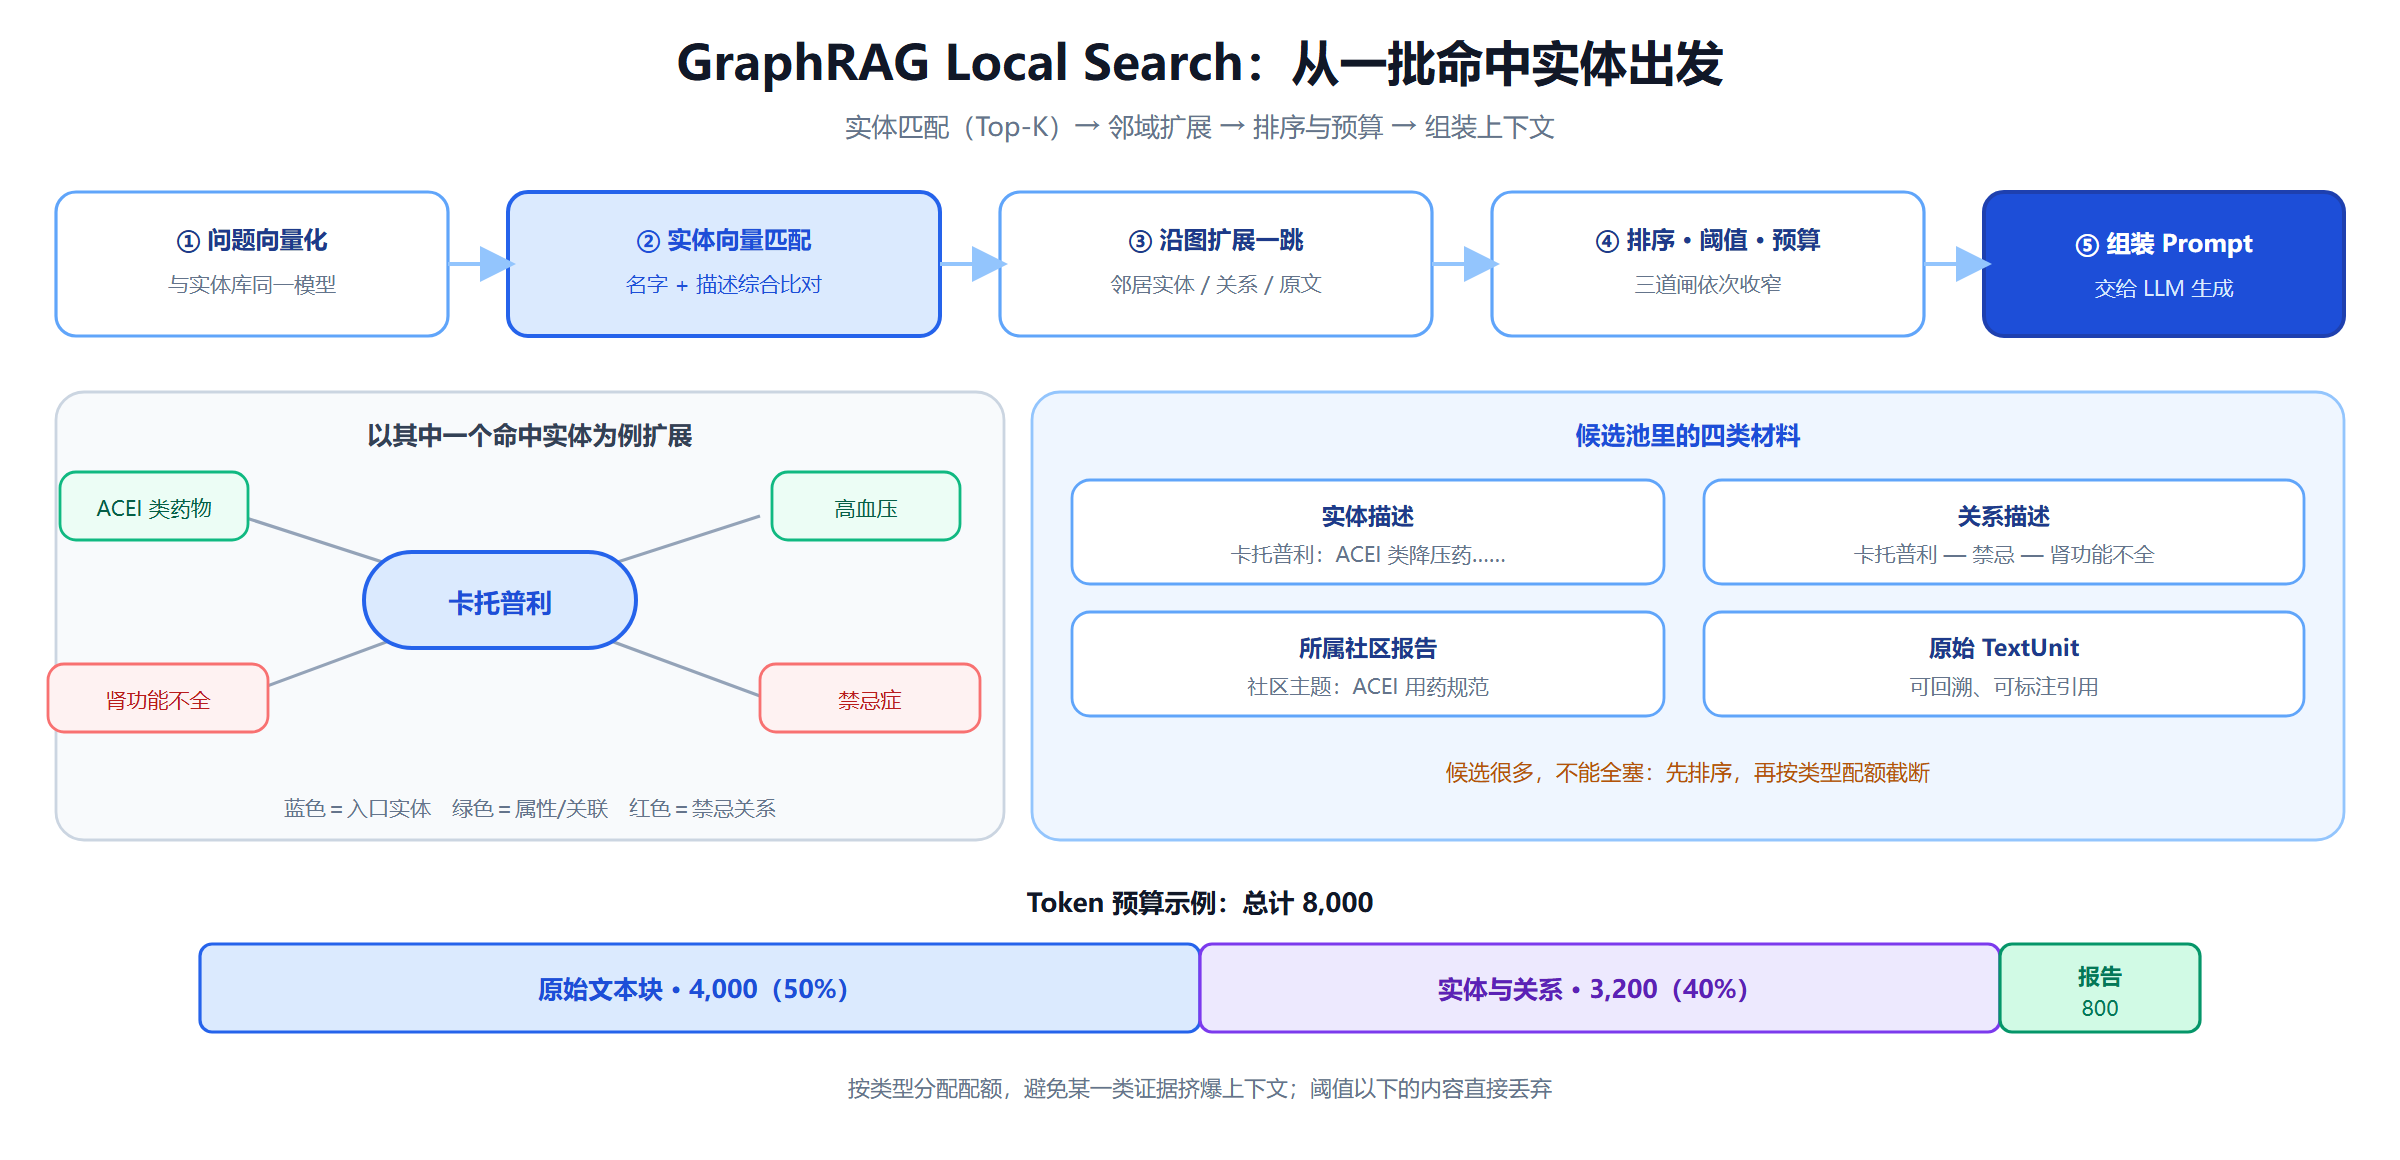
整条链路的逻辑是:先用向量找到入口,再用图把入口周围的关系摊开,最后用预算决定哪些关系能进上下文。 少了任何一步都不行:没有向量,找不到入口;没有图,关系展不开;没有预算,上下文装不下。
Local Search 的强项是「关系明确、实体明确」的问题。弱项也很明显,如果问题里的关键概念根本没被抽成实体,第一步就找不到入口,后面全白搭。
4.2 Global Search 从整个知识库出发
适合的问题长这样:
根据整个知识库,智能体系统设计主要有哪些技术路线?它们分别解决什么问题?
这类问题没有明确的实体入口。你没法说「去实体库里找哪个实体」,因为答案是跨实体的。此时还去检索 TextUnit,只能找到几段介绍「智能体系统」的文字,其他技术主题全被漏掉。
Global Search 换了一个入口:不找块,找社区报告。
第一步,决定读哪一层的报告。
社区是分层的。第 0 层是整个知识库,往下越拆越细。层级决定了报告的数量和粒度:
- 层级低,社区大、报告少、每份更概括;
- 层级高,社区小、报告多、每份更具体。
命令行参数 --community-level 默认是 2。这个默认值是个折中:再低就只有几份大而空的摘要,再高报告数量就会涨得很快。
选层的判断标准是问题粒度:
| 问题粒度 | 建议层级 | 理由 |
|---|---|---|
| 「整个知识库讲哪几大方向」 | 较低层(0–1) | 需要最大的社区来归纳 |
| 「某条技术路线怎么落地」 | 较高层(2–3) | 需要更细的社区提供细节 |
| 拿不准 | 默认 2 | 概括性与细节的折中 |
层级不是越高越好。报告越多,Map 阶段要读的份数越多,成本和延迟一起涨。这个问题到第五章还会再算一次账。
第二步,Map:逐批读报告,各写各的发现。
选中的报告不会一次性全塞进一个上下文,而是分批读。每一批单独交给 LLM,让它针对用户输入写出一组中间发现,并给每条发现打一个 0–100 的重要度评分。
之所以要分批,是因为上下文装不下所有报告;之所以要打分,是因为 Reduce 阶段必须知道哪条发现更值得保留。
1 | 批次 1: |
第三步,Reduce:把多批发现合成一个答案。
每批报告只看到知识库的一角,出来的发现是局部的、可能重复的。Reduce 要做三件事:去重、按分数排序、把高分发现合成一段连贯的答案。
1 | 100 份社区报告 |
到这里,整条链路的逻辑也清楚了:Map 负责把「读一百份报告」拆成「读十批」,Reduce 负责把「十份局部结论」合成「一个全局结论」。 前者解决上下文容量,后者解决视角碎片。
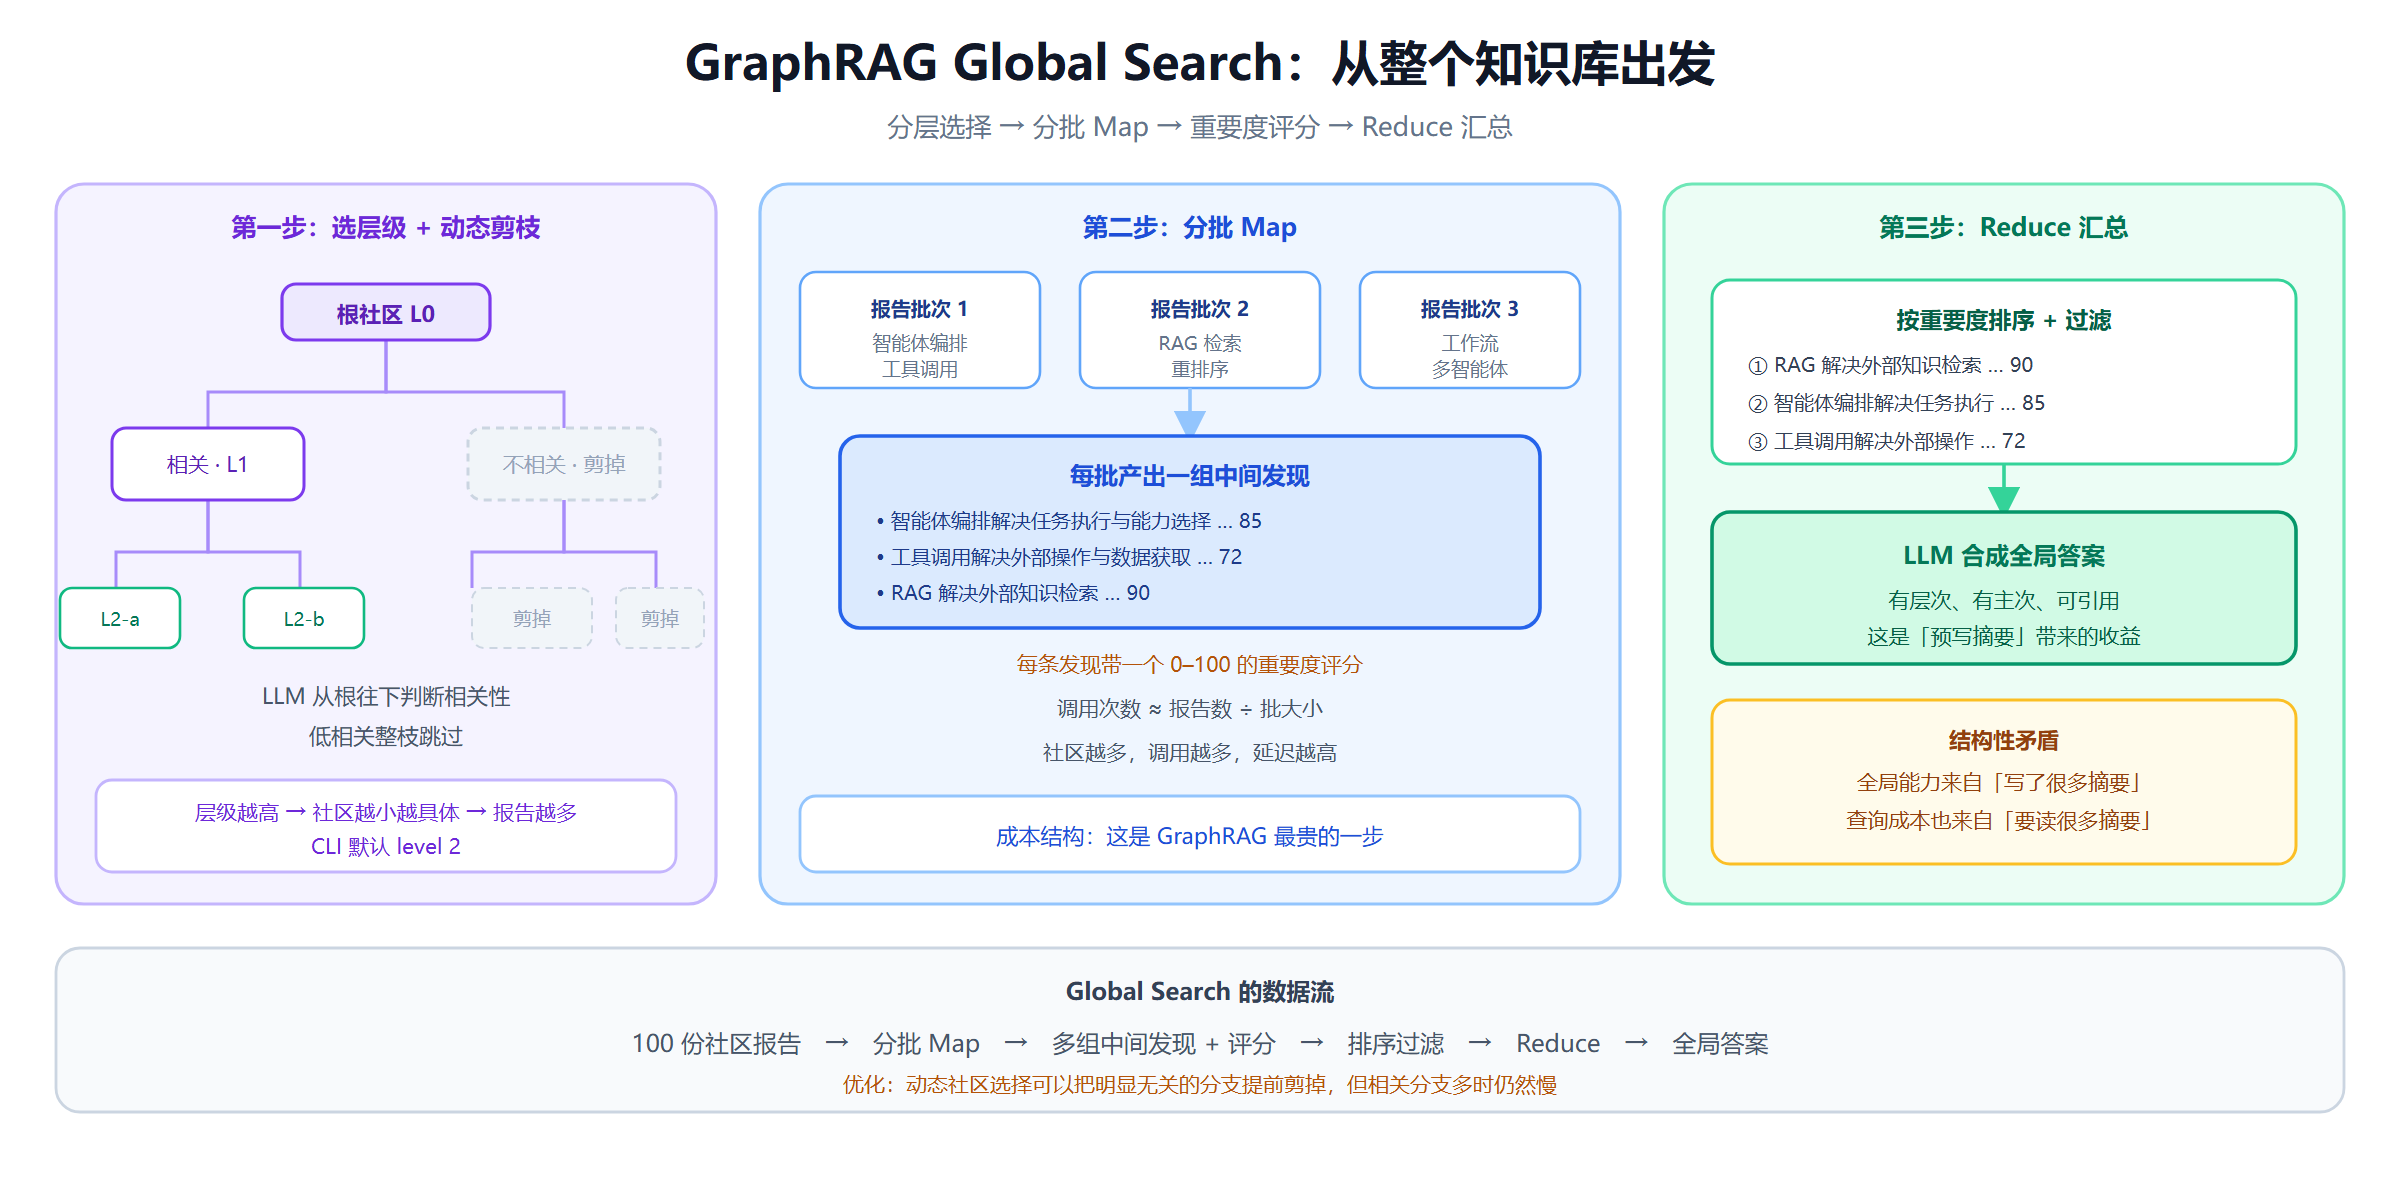
成本就在这里暴露出来。
社区报告越多,Map 的批次越多,LLM 调用次数越多。如果选的是低层级、社区数量上百,一次查询就是上百次调用的量级。延迟和费用都不低,而且每次查询都要重跑。
微软后来补了一个优化:动态社区选择(Dynamic Community Selection)。
它不再无脑遍历选中的整层,而是从社区树的根开始,让 LLM 判断「这个社区和问题相关吗」:
- 不相关 → 整枝剪掉,连同它的子社区一起跳过;
- 相关 → 保留,继续往下看子社区。
这样能把明显无关的分支提前砍掉,减少 Map 的份数。但要注意:它只是缓解,不是根治。 判断相关性本身也要调 LLM,而且相关分支多的时候,成本依然随规模上涨。
再往后,微软还提出了 LazyGraphRAG:索引期不做任何 LLM 摘要,只做轻量的 NLP 统计,把 LLM 工作全部推迟到查询期。官方给出的口径是,它的索引成本与向量 RAG 相当,约为完整 GraphRAG 的 0.1%。这本质上是把「预算置」这个选择,又推回到了「实时算」那一侧,和 LightRAG 的取舍方向一致。
4.3 两种模式怎么选
| 维度 | Local Search | Global Search |
|---|---|---|
| 入口 | 实体向量 | 社区报告 |
| 依赖 | 实体抽取质量、邻域关系 | 社区划分、报告质量 |
| LLM 调用次数 | 少(1–2 次) | 多(随报告数增长) |
| 延迟 | 低 | 高 |
| 适合 | 「X 和 Y 什么关系」「X 的细节」 | 「整体有哪些方向」「主题归纳」 |
| 不适合 | 全局归纳、没有实体入口的问题 | 具体实体细节、精确事实 |
Local 解决「关联」,Global 解决「全局」。 这也正好对应第一章的三道坎:切片断裂和多跳靠 Local 的邻域扩展,全局归纳靠 Global 的社区报告。
五 GraphRAG 的四个困点
索引和查询都讲完了,接下来算账。GraphRAG 的四道硬伤,恰好也是 LightRAG 的四个发力点。
5.1 困点一 索引成本高 而且误差会叠加
索引期有三笔 LLM 大开销:
- 逐块抽取:每个 TextUnit 至少一次调用,加上 gleaning 还要再来一次;
- 实体描述合并:每个实体一次;
- 社区报告生成:每个社区一次,而且是分层生成。
粗略估一下调用量:
1 | 索引 LLM 调用量 ≈ 块数 × (1 + 续抽轮数) |
块越多、抽得越细、社区分得越细,这个数字涨得越快。
更麻烦的是误差叠加。
社区是分层的,上层摘要由下层内容汇总而来,下层摘要又由更下层的实体与文本汇总而来。如果最底层的抽取出错,错误会一层一层往上放大。
低层把「工具」和「维修工具」合并错了,中层就会写出一份错误的社区摘要,高层再基于这份摘要继续归纳。等你看到最终答案时,已经找不到错误是从哪一层开始的了。
5.2 困点二 实体消歧 图构建里最难的一步
同名问题可以拆成三种。前一种基本靠规则,后两种才是真正的难点:
| 类型 | 例子 | 难点 |
|---|---|---|
| 同名同义 | 「ReactAgent」与「react agent」 | 规则能处理大部分,但缩写、别名容易漏 |
| 异名同义 | 「工具」与「Tool」 | 需要跨语言、跨表述识别 |
| 同名异义 | 智能体文档的「工具」与维修文档的「工具」 | 需要领域知识才能区分 |
第三种最要命。它错得很隐蔽:名字完全一样,合并时不会报错,但从那一刻起,图里就混进了另一个领域的语义。
缓解思路是一套组合拳:
- 命名规范化:在抽取阶段就要求带上领域限定词。智能体的叫「智能体工具」,维修的叫「设备维修工具」。名字本身就消歧,是成本最低的做法。
- 名字 + 描述联合匹配:检索和合并时都不要只看名字,要把描述一起编码比较。名字相同但描述语义距离很远,就不该合并。
- LLM 裁决:对候选合并对,让模型判断「这两个是同一个东西吗」,给出理由。
- 人工白名单:对高频、高价值的实体维护一张别名表,比如「AI / 人工智能 / Artificial Intelligence」。
- 合并 API:对确认是同一实体的别名,提供手动合并入口。
没有银弹。 消歧做到最后,一定是「自动策略 + 人工兜底」,而且兜底成本会随着语料领域变宽而上升。
5.3 困点三 增量更新
传统 RAG 更新很简单:删掉旧文档对应的向量,插入新的,完事。
GraphRAG 不行。新文档进来,会牵动四样东西:
- 新实体、新关系要并入图;
- 已有实体可能要更新描述;
- 社区划分可能变化;
- 变化的社区要重写报告;上层社区还要跟着重写。
两条路,各有各的代价:
| 方案 | 做法 | 优点 | 缺点 |
|---|---|---|---|
| 全量重建 | 清空重跑整条索引 | 结果一致、无漂移 | 成本最高,语料越大越不可行 |
| 局部增量 | 只抽新文档,比对后改图,再更新受影响社区 | 省很多 | 容易出错,且错误会累积 |
局部增量的流程大致是:
- 抽新文档的实体与关系;
- 与已有图比对,判断是新增、更新还是已存在;
- 更新对应节点与边;
- 找出受影响的社区,重写它们的报告;
- 上层社区递归更新。
问题在于,社区划分是全局的。插进一批新实体后,原来的社区边界可能已经不再合理,但你只更新了「受影响的几个」,剩下的社区仍然按旧结构存在。久而久之,图会漂移——结构还在,语义已经偏了。
所以工程上的现实做法是:少量更新走增量,累计到一定比例就全量重建。 这个阈值没有通用答案,得看语料的更新节奏和图的变化幅度。
更根本的一点是:GraphRAG 官方流程本来就不是为高频更新设计的。 它的假设是「一批相对静态的语料,值得花大价钱建一次索引」。如果语料天天变,这个前提本身就不成立。
5.4 困点四 Global 查询慢且贵
Global Search 的成本结构和 Local 完全不同:
| 环节 | 调用量 |
|---|---|
| 社区相关性判断(开启动态选择时) | 逐层判断,与访问到的社区数相关 |
| Map | 社区报告数 ÷ 批大小 |
| Reduce | 1 |
Local 大概 1–2 次调用就能收工,Global 则是几十到上百次。报告越多、层级越低,这个数字越大。
动态社区选择能砍掉明显无关的分支,但砍不掉「相关分支本身就很多」这种情况。一个语料覆盖多个领域时,和问题相关的社区本来就不会少。
这就是 GraphRAG 的结构性矛盾:它的全局能力来自「预写了很多摘要」,而它的查询成本也来自「要读很多摘要」。
5.5 四个困点汇总
| 困点 | 成因 | 常见缓解 | 残留风险 |
|---|---|---|---|
| 索引成本高 | 抽取 + 合并 + 逐社区写报告,且分层放大 | 限定实体类型、便宜模型抽取、控制社区数 | 报告质量下降;小语料不划算 |
| 实体消歧 | 同名异义、异名同义,且错误向上传播 | 命名规范化、名字+描述联合匹配、LLM 裁决、人工白名单 | 领域变宽后兜底成本上升 |
| 增量更新 | 社区划分是全局的,局部更新会漂移 | 少量增量 + 定期全量重建 | 漂移难以量化,发现问题时已影响查询 |
| Global 查询慢 | 调用次数随社区报告数增长 | 动态社区选择、提高层级减少报告数 | 相关分支多时仍然慢;层级高会丢细节 |
LightRAG 的设计,几乎是照着这张表逐条改的。 下一章开始看它怎么改。
六 LightRAG 的索引阶段
6.1 砍掉重的那部分
LightRAG 保留了 GraphRAG 的前半段,砍掉了后半段:
| 环节 | GraphRAG | LightRAG |
|---|---|---|
| 切片 | 有 | 有(完全一样) |
| 实体关系抽取 | 有 | 有(基本一样) |
| 合并重复实体 | 有(LLM 合并描述) | 有(同名合并,需自己补校验) |
| 建图 | 有 | 有 |
| 社区发现 | 有(分层 Leiden) | 没有 |
| 社区报告 | 有 | 没有 |
| 向量化 | 文本、实体、报告 | 文本、实体、关系 |
砍掉社区和社区报告,直接消掉了上一章的第一、第三、第四个困点:
- 不用逐社区写报告 → 索引成本大降;
- 没有全局社区结构 → 增量更新只需并图;
- 查询不需要遍历报告 → 调用次数变成常数级。
代价是全局归纳的质量问题,留到了查询期,靠现场推理来补。
6.2 切片与抽取 完全复用
这两步和 GraphRAG 没有本质区别:切 TextUnit、记录文档来源、用 LLM 抽实体与关系。
差别在抽取的字段上。LightRAG 的关系抽取多要了一样东西:关系关键词(keywords)——用几个词概括这条关系的性质,比如「调用」「依赖」「协作」。落到图里,每条边还会带一个 weight(权重),用于后续排序与截断。
别小看这两个信息。它们正是后面 Global 模式检索的抓手:关系关键词参与关系向量的构建与匹配,权重用来排序、截断候选。
6.3 合并 同名只是候选
LightRAG 内置的合并只做一件事:按名字归一后合并。
具体是:去掉实体名里的引号、统一大小写、压缩多余空格;归一后相同,就认定是同一个实体,把新描述并进旧描述;描述用固定分隔符拼接,片段数超过阈值时才让 LLM 压成一条。关系同理。
这套逻辑能成立,靠的是一个前提:同一份语料里,同名基本同义。 在单领域知识库里,这个前提大多成立,所以它便宜、可预测、也不需要额外调模型。
但前提一旦破了,问题就出来了:
- 「工具」和「Tool」是同义不同名,它不会合并,图里长出两个节点,多跳在这里断掉;
- 智能体的「工具」和维修手册的「工具」是同名不同义,它会合并,两个领域被强行焊在一起。
第二种更危险。合并之后图里只剩一个「工具」节点,描述里既有「智能体调用的外部能力」,又有「扳手、螺丝刀」。之后检索「智能体怎么调用工具」,维修文档的关系也会被带进上下文,顺着边走两跳,整条链路就偏到另一个领域。这种错误不会报错,只会让答案悄悄变脏。
所以实际工程里,不能把「同名」当成合并的充分条件。常见的处理有三层,按成本从低到高。
第一层,把消歧前移到抽取阶段。 在 prompt 里要求实体名自带领域限定:智能体文档抽成「智能体工具」,维修文档抽成「设备维修工具」;跨语言统一成一个规范名。名字本身就带语义,后面的合并自然不会错。这一层成本最低,效果也最稳。
第二层,合并前加一道校验。 名字相同只是候选,不是结论。把两个实体的描述各做一次向量,比较相似度;再看实体类型是否一致。描述距离远、类型又对不上,就不合并。拿不准的交给 LLM 裁决,让它回答「这两个是同一个东西吗」并给出理由。这一层是 GraphRAG 默认在做、LightRAG 默认不做的事。
第三层,按领域分图。 如果语料本身就横跨多个领域,最稳的做法是每个领域建一张图,检索时先路由到对应领域,再在图内做同名合并。同名实体天然不会跨图相遇,代价是要多维护几套索引。
已经合并错的,补救空间很小。LightRAG 提供的 merge_entities 只能把多个实体并成一个,没有对应的反向拆分接口;描述一旦混在一起,想还原只能删掉重建,或者重新抽一份干净的图。所以这三层里,预防比补救重要得多。
LightRAG 的内置合并是「单领域假设」下的省事方案,不是跨领域语料的正确方案。 第五章那个最难点,它没有解决,只是把责任留给了使用者。
6.4 四类存储
LightRAG 把数据分成四类存放,各司其职:
| 存储类型 | 保存什么 | 为什么需要 |
|---|---|---|
| KV Storage | 原始文档、Chunk、抽取结果、缓存 | 保存文本与处理过程中的数据 |
| Vector Storage | 文本块、实体、关系的向量 | 支持语义检索 |
| Graph Storage | 实体节点与关系边 | 支持关系检索与关联扩展 |
| Document Status Storage | 文档处理状态 | 支持任务追踪、去重与处理恢复 |
几个工程细节:
- Graph Storage 可替换:默认用 NetworkX 就能跑,生产上可换 Neo4j 等图数据库;
- Vector Storage 可替换:默认是轻量向量库,也支持 Milvus、Qdrant、pgvector 等;
- Document Status Storage 是它做增量更新的基础:哪份文档处理到哪一步、内容哈希是否重复,都记在这里。
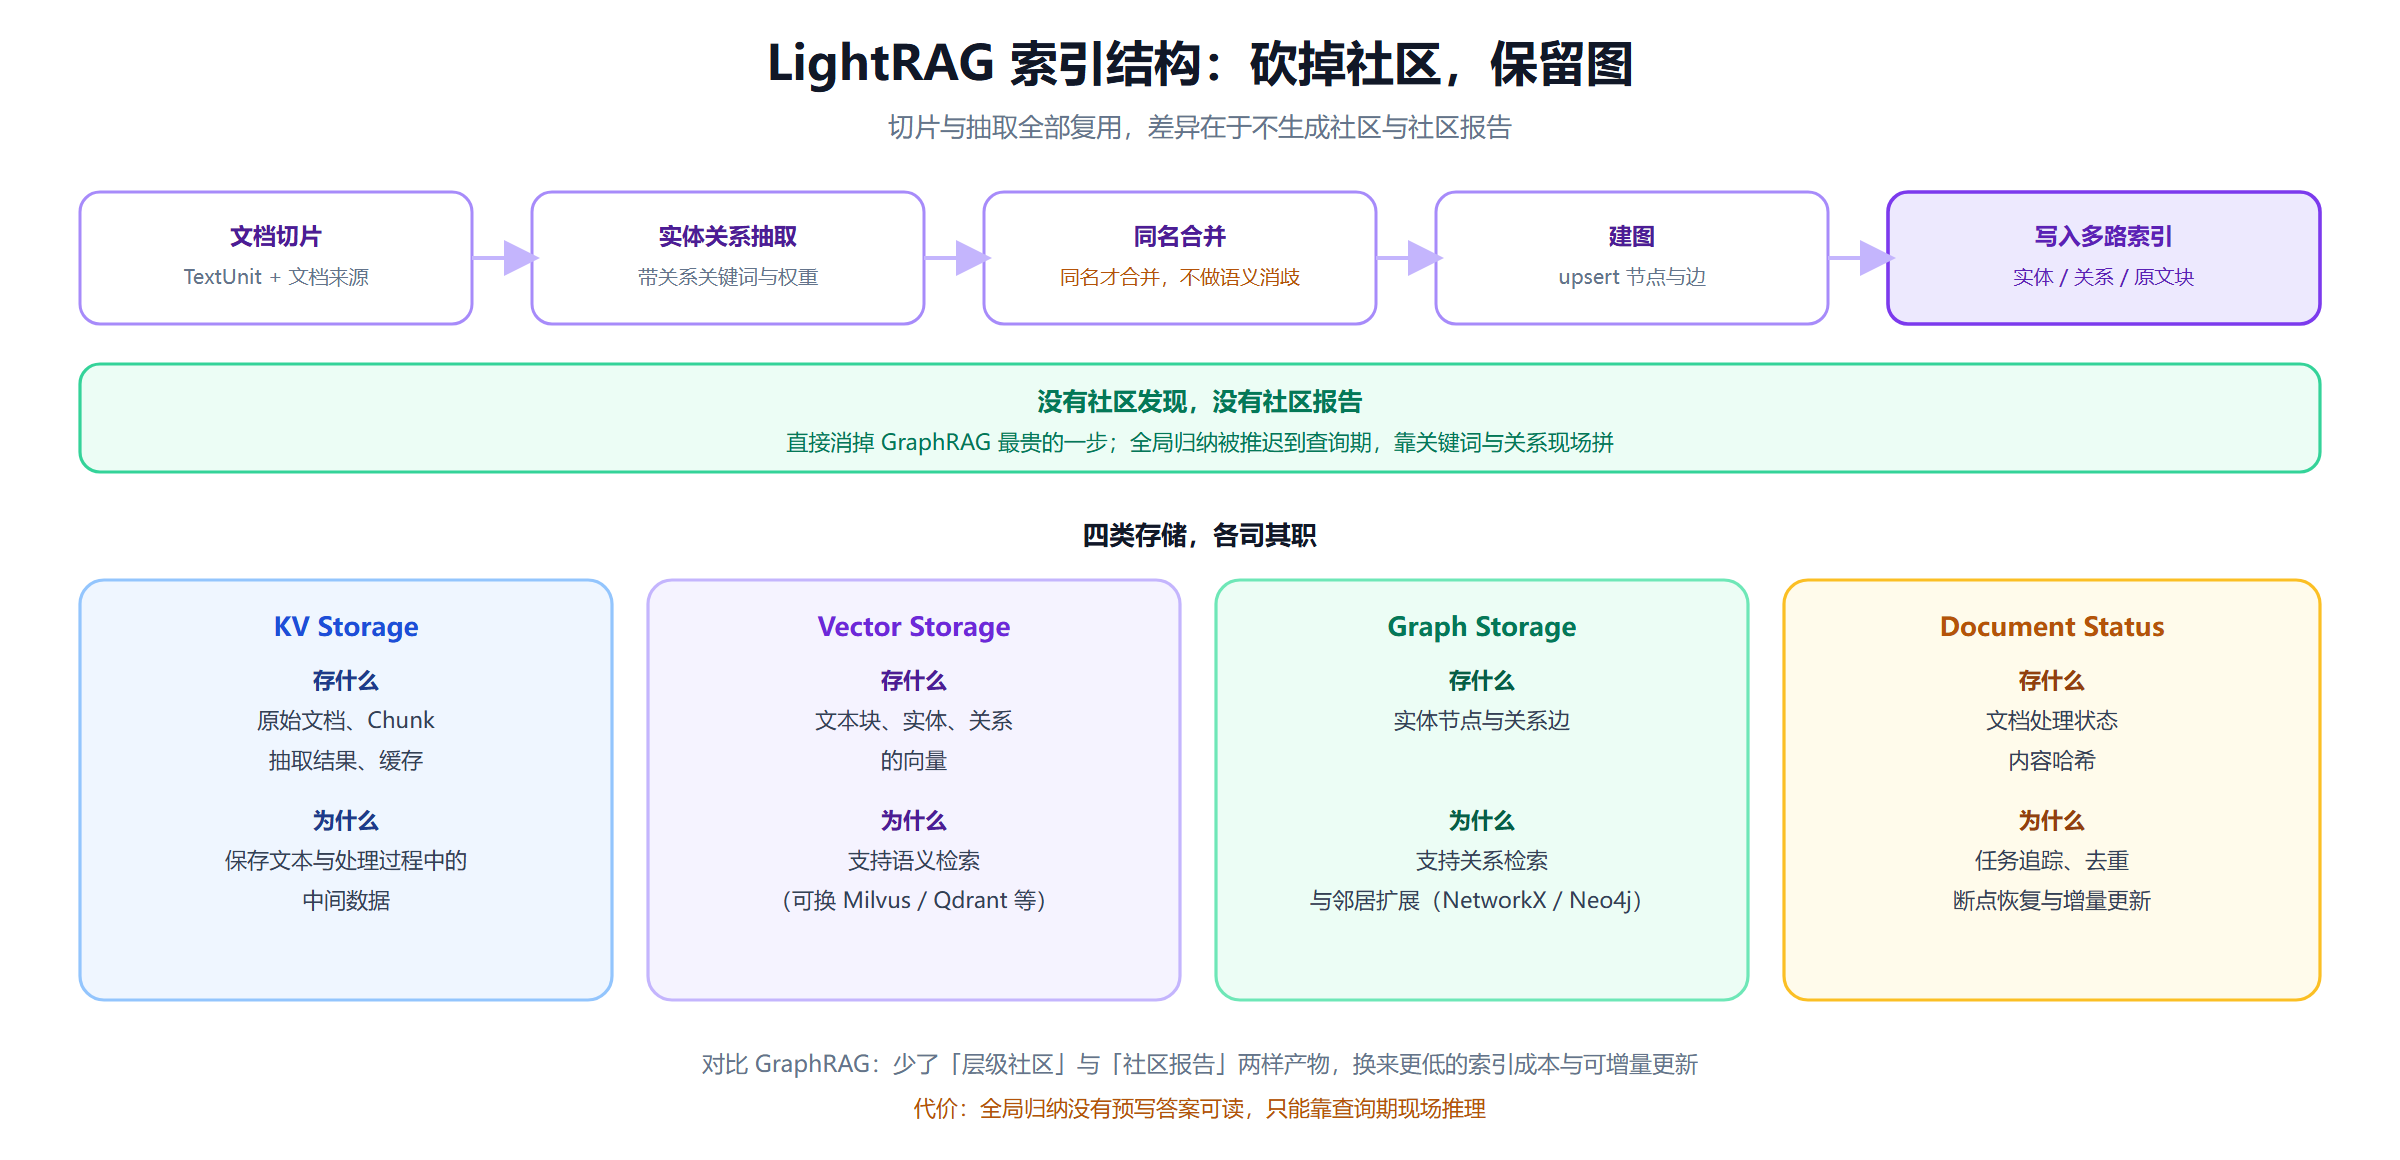
索引完成后的产物,比 GraphRAG 少了一样东西:
| 产物 | GraphRAG | LightRAG |
|---|---|---|
| 原始文本单元 | 有 | 有 |
| 实体与关系图 | 有 | 有 |
| 层级社区 | 有 | 无 |
| 社区报告 | 有 | 无 |
| 向量索引 | 文本/实体/报告 | 文本/实体/关系 |
少了社区报告,全局能力就得靠别的东西补。 那就是下一章的查询设计。
七 LightRAG 的查询阶段
7.1 先拆关键词
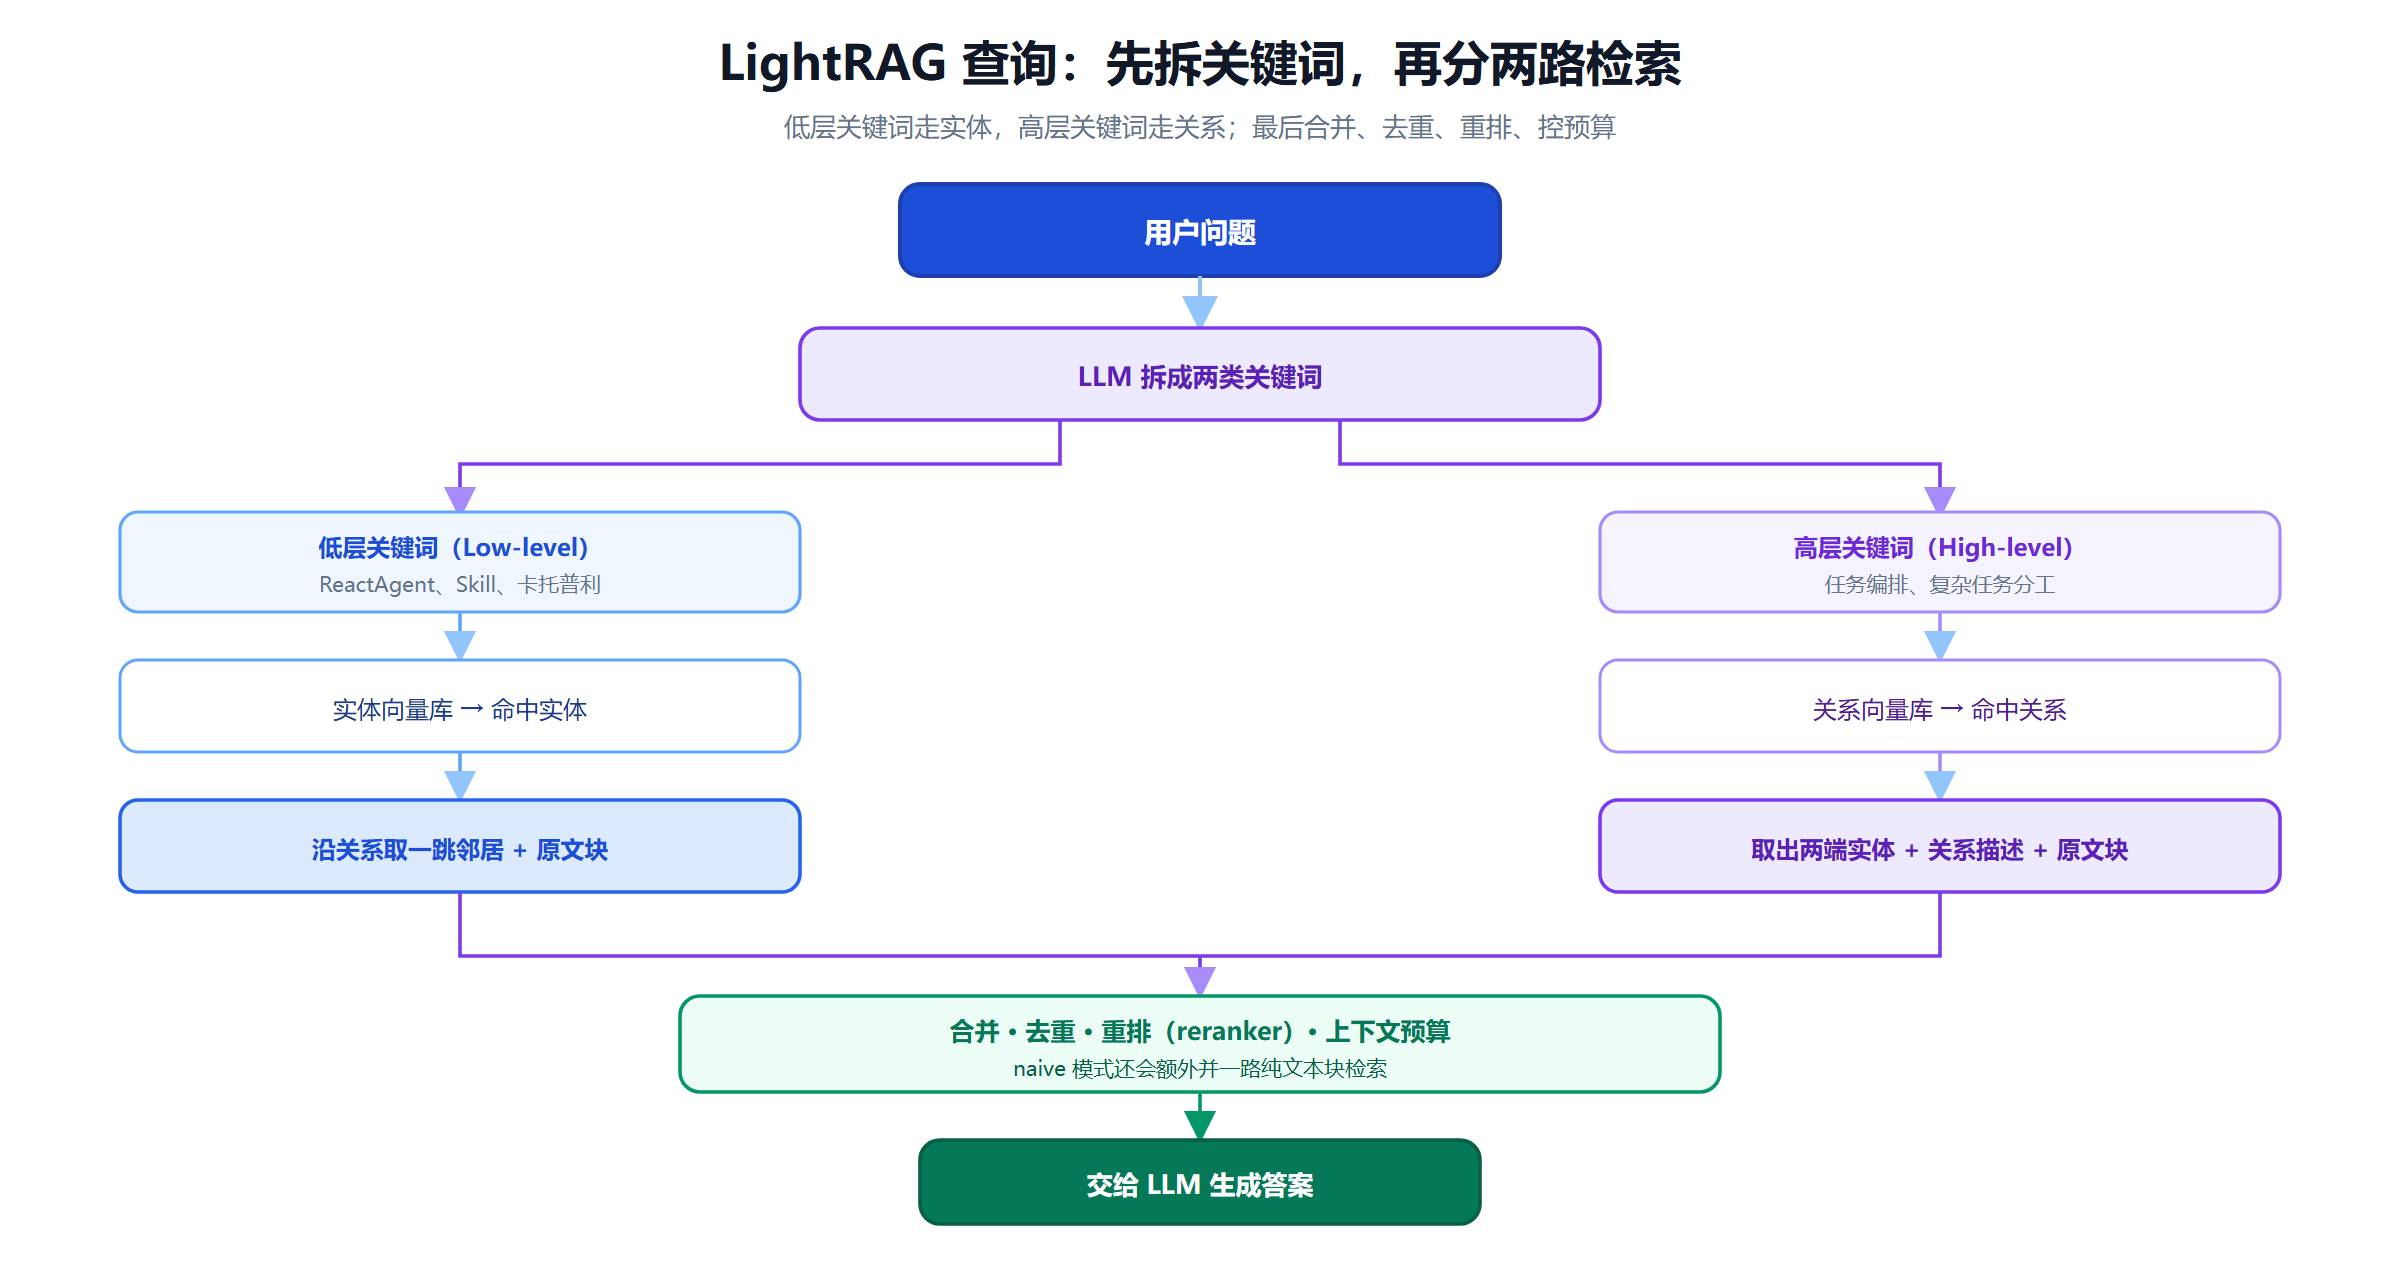
LightRAG 查询的第一步,是让 LLM 把用户输入拆成两类关键词,这一步还没到向量检索:
| 类型 | 含义 | 例子 |
|---|---|---|
| 低层级关键词(Low-level) | 具体实体、技术概念、细节 | ReactAgent、Skill、卡托普利 |
| 高层级关键词(High-level) | 主题、抽象问题、跨实体关系 | 任务编排、复杂任务分工、用药禁忌 |
举个直观的对比:
- 「Skill 是什么?」——偏具体概念,低层关键词为主;
- 「智能体如何组织复杂任务?」——偏主题与关系,高层关键词为主。
这一步,本质上是在替代 GraphRAG 的「社区摘要」。
GraphRAG 用预先写好的报告回答「这类主题大概讲了什么」;LightRAG 则把问题翻译成主题词,再去图里找和这些主题词相关的关系,现场拼出答案。
7.2 五种查询模式
五种模式不是五个独立功能,而是检索范围从窄到宽的五档。理解它们的关键,是看每一次分别用了哪类关键词、去哪个库里找什么。
naive,完全不碰图。
就是把 LightRAG 当传统 RAG 用:用户输入做向量,文本块库找 Top-K,拼上下文。它存在的意义主要是做对照,验证「建图到底有没有带来收益」。
local,低层关键词走实体。
这一档和 GraphRAG 的 Local Search 几乎一样。低层关键词先命中实体,再沿关系取一跳邻居,最后把关系描述和原文块一起拿回来。区别只有一个:它没有社区报告可拿,所以上下文里少了「这个实体所在主题的背景」。
适合问「某个实体是什么」「它和谁有关」这类问题。
global,高层关键词走关系。
这一档最容易被误解。它不是「用高层关键词找实体」,而是先用高层关键词去关系向量库里找关系,再把关系两端的实体取出来。
路径是:
- 高层关键词 → 关系向量库,命中一批关系;
- 取出这些关系两端的实体;
- 取出关系描述与相关原文块;
- 按配置和 Token 预算筛选;
- 交给 LLM 组织答案。
例如命中这样一组关系:
1 | ReactAgent -> selects -> Skill |
模型就能围绕「智能体如何组织任务」这个主题,用这些关系搭出一个有结构的回答,而不是只依赖某一段最相似的文本。
但这里必须说清楚:LightRAG 的 global 不等于自动发现知识之间的所有逻辑联系。它依赖三样东西:索引里已经抽出来的关系、关键词的质量、检索参数。索引里没抽到的关系,它一样找不到。
这正是它和 GraphRAG 社区报告的差别:一个是离线精读后的结论,一个是现场从关系描述里拼出来的推断。
hybrid,两路一起跑。
local 和 global 同时执行,结果取并集再去重。适合一个问题里既有具体实体、又有主题判断的情况。
mix,三路全上,默认模式。
mix 在 hybrid 的基础上再加一路 naive,把 local、global、naive 的结果合在一起:
| 来源 | 补什么 |
|---|---|
| Local | 具体实体及其邻接关系 |
| Global | 与主题、跨实体关系有关的结构信息 |
| Naive | 原文中直接描述流程的细节段落 |
三者互补:图给结构,实体与关系描述给概括语义,原文块给细节与上下文。但 mix 的价值是「扩大信息来源」,不是「保证每条都相关」。三路合起来,噪声也会一起变多。
另外还有一个
bypass模式,完全不检索,只把用户输入交给模型,一般用于调试。
7.3 筛选 重排与预算
三路召回之后,还要做和 GraphRAG 类似的三件事:
- 去重:同一实体、同一段原文可能被多路命中;
- 重排:LightRAG 支持接入 reranker,对候选做精排;
- 上下文预算:用
max_total_tokens之类的参数控制总量,避免把上下文撑爆。
需要说清楚的是:这一层不是 LightRAG 独有的能力。 去重、rerank、Token 预算,传统 RAG 和 GraphRAG 也都在做,思路完全一致。LightRAG 官方提供的是 reranker 接口和预算参数,更细的按来源配额、引用标注,通常要工程侧自己补。
7.4 和 GraphRAG 的查询对比
| 维度 | GraphRAG Local | GraphRAG Global | LightRAG local | LightRAG global | LightRAG mix |
|---|---|---|---|---|---|
| 入口 | 实体向量 | 社区报告 | 低层关键词 → 实体 | 高层关键词 → 关系 | 三路并行 |
| 依赖社区 | 是(取所属社区报告) | 是(核心依赖) | 否 | 否 | 否 |
| LLM 调用次数 | 1–2 | 随报告数增长 | 1–2 | 1–2 | 2–3 |
| 延迟 | 低 | 高 | 低 | 低 | 中 |
| 全局归纳深度 | 中 | 高 | 低 | 中 | 中 |
最后一行是重点。 LightRAG 用「调用次数恒定」换来了「全局深度有限」,这就是它的核心取舍。
八 LightRAG 的代价
前面几章把 LightRAG 讲得很划算:便宜、快、能增量。但账要算全,它有四笔成本。
8.1 全局归纳深度不如社区报告
GraphRAG 的社区报告,是在索引期专门读过该社区的全部成员与原文之后写出来的;LightRAG 的 Global 模式,是查询期临时从一组关系描述里拼出来的。
差别在语料变复杂时会被放大:
- 一个社区里如果有一百条关系,GraphRAG 会先压成一份有主次的摘要;LightRAG 则把这些关系的描述按相关度截断后直接塞给模型。
- 前者是「已经消化过的结论」,后者是「还没消化的原料」。
所以「这套文档的主题思想是什么」这类问题,LightRAG 通常能答个大概,但很难答得像 GraphRAG 那样有层次。
8.2 消歧更弱
LightRAG 内置只做同名合并,第五章那个最难点就落到了使用者身上:
- 跨语言别名(「工具」与「Tool」)不会自动合并,要用
merge_entities手动并; - 跨领域同名(智能体工具与维修工具)会被错误合并,而合并没有反向拆分接口,只能重建或提前分图;
- 内置流程里没有名字加描述的相似度校验,也没有 LLM 裁决。
GraphRAG 至少还有一遍「LLM 合并实体描述」的动作,能把同义描述揉在一起。LightRAG 只在描述片段超过阈值时才压一次。这一项,LightRAG 是更弱的。
8.3 图质量决定上限 而且没有兜底
LightRAG 的全局能力全靠图。抽取漏了关键实体、关系断了,它就没有任何社区报告可以兜底。
GraphRAG 也一样怕抽取错,但它有一层「社区摘要」做缓冲:个别关系错了,摘要里还有可能被其它信息纠正。LightRAG 没有这层缓冲,错误会直接进入检索结果。
8.4 上下文容易膨胀
Local 模式沿关系取一跳邻居,邻居数量不可控。一个热门实体可能连着几十个节点,全部展开会瞬间撑爆预算。
靠截断能解决「装不下」,但解决不了「截断策略是否合理」。截错了,关键证据就丢了。
8.5 同一张表 把账算完
| 困点 | GraphRAG | LightRAG | 结论 |
|---|---|---|---|
| 索引成本 | 高 | 中 | LightRAG 明显更省 |
| 实体消歧 | 有 LLM 合并,较强 | 仅同名合并,较弱 | GraphRAG 更好,但都不彻底 |
| 增量更新 | 弱,易漂移 | 强,按文档并图 | LightRAG 明显更好 |
| 全局查询成本 | 高,随报告数增长 | 低,基本恒定 | LightRAG 明显更好 |
| 全局归纳深度 | 高 | 中 | GraphRAG 明显更好 |
| 工程复杂度 | 高 | 中 | LightRAG 更容易落地 |
没有全能选手,只有取舍。
九 场景与选型
9.1 四个决策维度
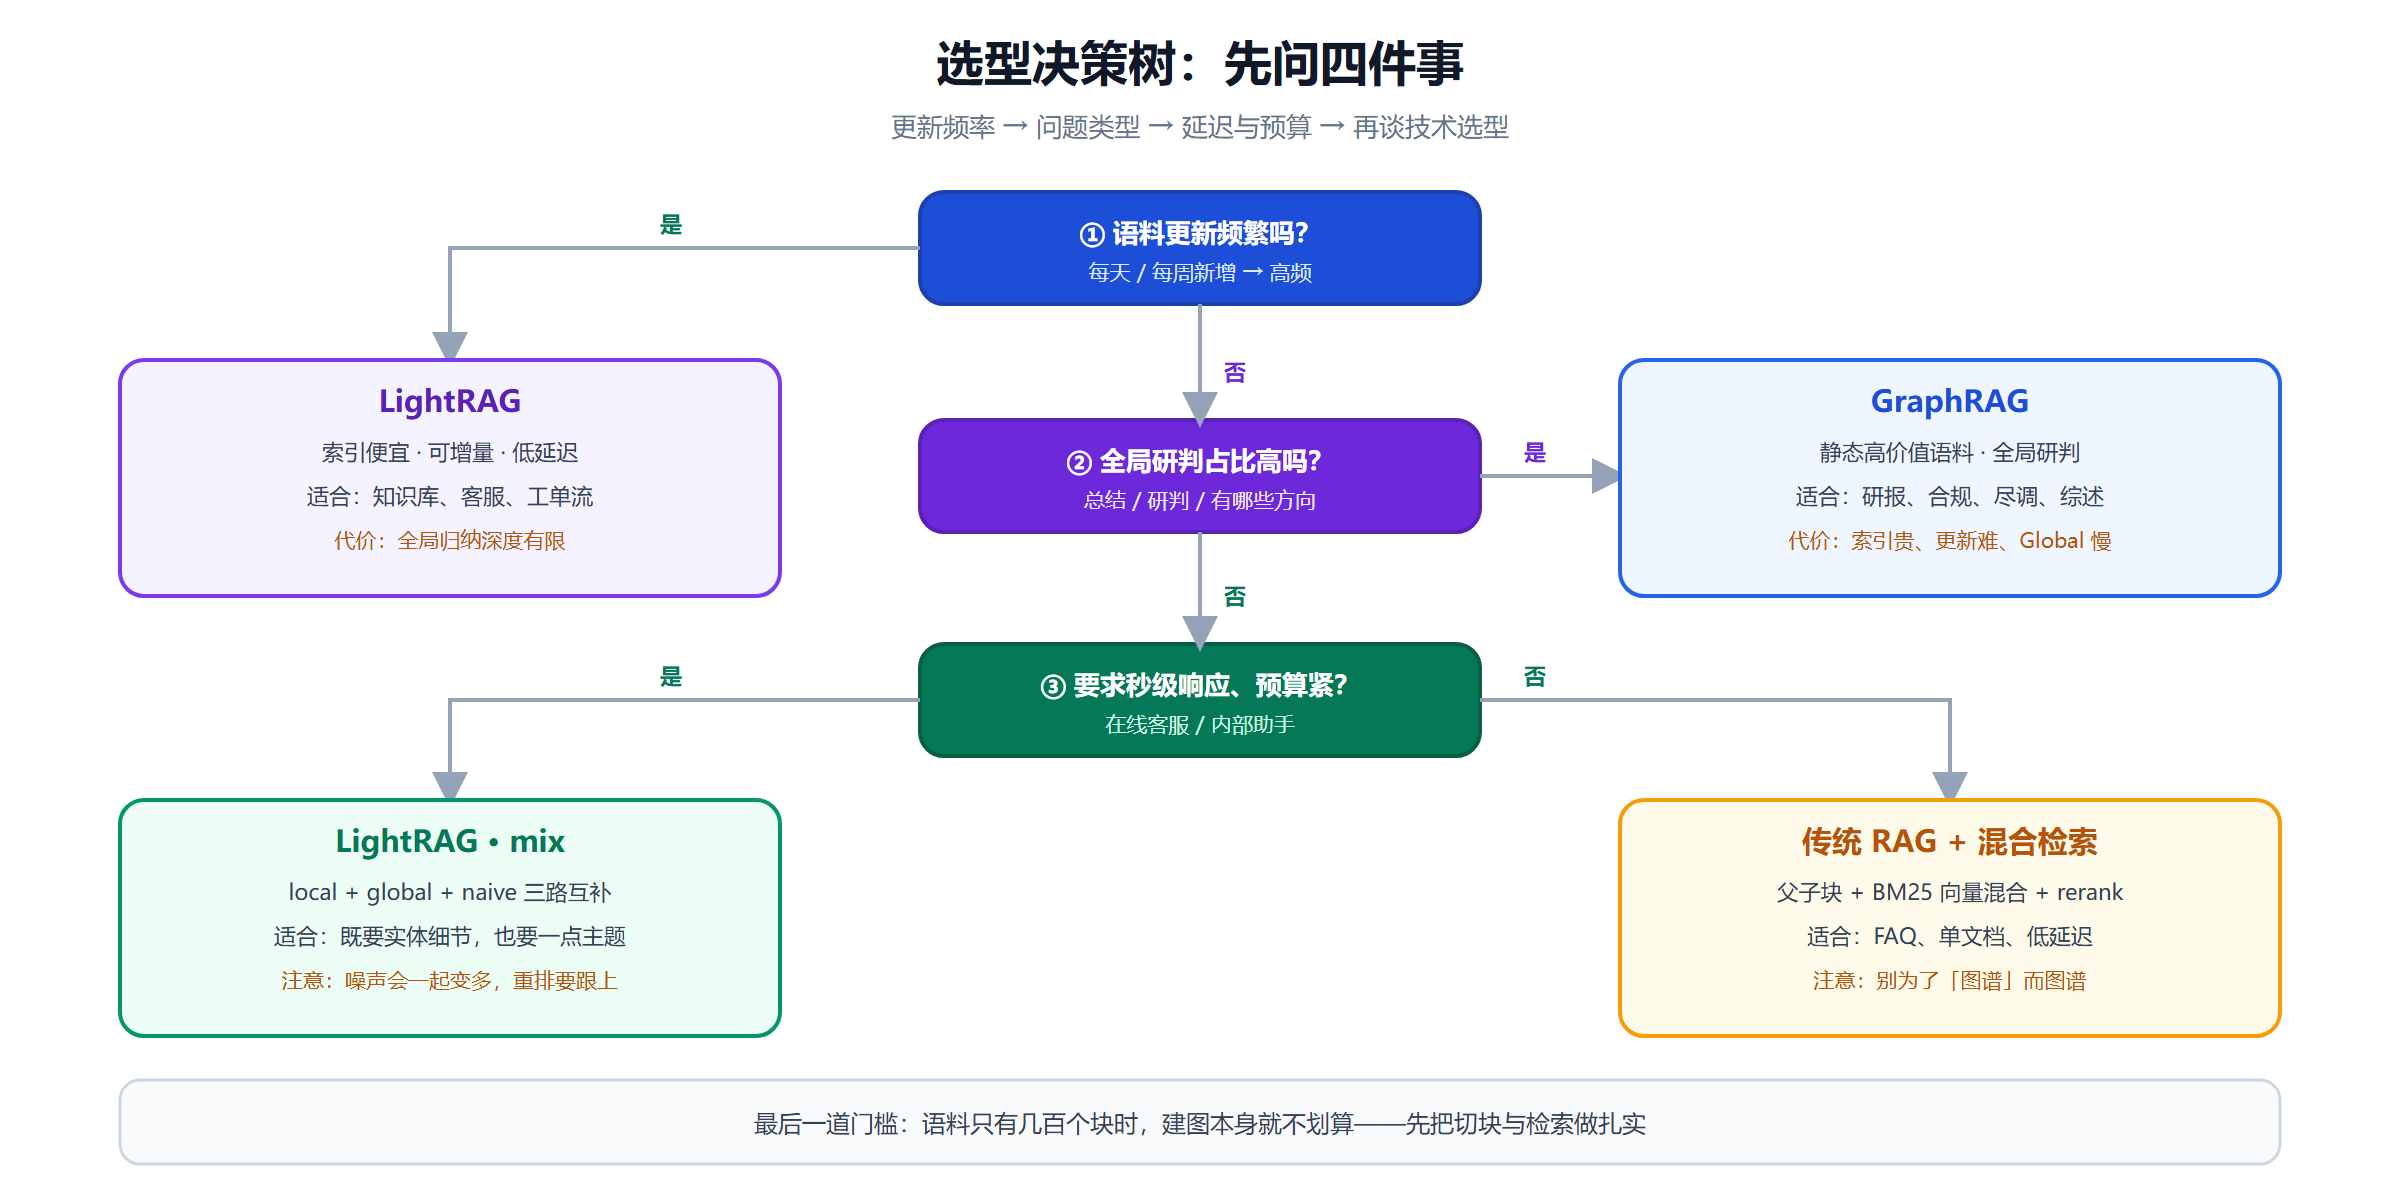
选型别一上来就比效果,先回答四个问题:
- 语料更新频率有多高? 天天变 → LightRAG;一年建一次 → GraphRAG 可接受。
- 问题里「全局归纳」占多大比例? 大量「总结、研判、有哪些方向」→ GraphRAG;多是「某个实体怎么样」→ LightRAG 足够。
- 成本与延迟的容忍度? 面向内部决策、可以等几十秒 → GraphRAG;面向在线客服、要求秒级 → LightRAG。
- 语料规模多大? 只有几百个块,建图本身就不划算,先用传统 RAG 的混合检索 + rerank。
9.2 GraphRAG 适合什么
特征:语料相对静态、价值高、问题偏全局研判。
- 行业研究报告库:问「这个赛道的主要技术路线与玩家格局」;
- 合规与法务卷宗:问「这批合同里有哪些共性风险条款」;
- 情报与尽调材料:问「这家公司的关联方网络里有哪些异常节点」;
- 文献综述:问「这个领域近三年的主要方法演进」。
这些场景的共同点是:答错代价高,愿意为一次深度索引付费,而且语料不会天天变。
9.3 LightRAG 适合什么
特征:语料动态、成本敏感、要求低延迟。
- 企业知识库:制度、流程、产品文档持续更新;
- 客服与内部助手:要秒级响应,问题多为具体实体与流程;
- 工单与新闻流:每天新增,需要增量入库;
- 中小规模专业库:预算有限,先跑起来再迭代。
9.4 混合架构 两个都要 但要分类
两者并不互斥。常见的混合做法是:
- 双写:同一份抽取结果,同时写入两套索引——GraphRAG 建社区报告,LightRAG 建多路向量;
- 路由:在入口加一个轻量分类器,判断问题类型:
- 局部/实体类 → LightRAG local;
- 主题/全局类 → GraphRAG global;
- 多跳类 → 两边都可,优先 LightRAG 的低延迟;
- 降级:GraphRAG 查询超时或成本超限时,回落到 LightRAG。
代价是索引成本翻倍、运维复杂度上升,而且路由分错时会同时拿到两份不好的答案。只有当全局研判确实是核心业务时,这个复杂度才值得。
9.5 迁移路径
如果现在还在用传统 RAG,建议按这个顺序走:
- 先把传统 RAG 的混合检索 + rerank 做好。父子块 + 相邻块合并,能解决相当一部分「切片断裂」,成本几乎为零。
- 再上 LightRAG 试水。索引成本可控、能增量、延迟低,用来验证「图到底有没有带来收益」。
- 只有当全局研判成为明确需求时,再上 GraphRAG。此时你已经有了 LightRAG 的对照数据,能算清这笔钱花得值不值。
9.6 场景对照表
| 场景 | 推荐方案 | 关键理由 | 主要风险 |
|---|---|---|---|
| 静态研报库、尽调材料 | GraphRAG | 需要跨文档归纳与全局研判 | 索引成本高;更新要重建 |
| 合规审查、法务卷宗 | GraphRAG | 全局风险条款汇总 | 消歧错误会放大 |
| 企业知识库(持续更新) | LightRAG | 增量更新、低成本 | 全局归纳深度不足 |
| 客服 / 内部助手 | LightRAG(mix) | 低延迟、多路互补 | 邻居膨胀、噪声 |
| 单文档问答 / FAQ | 传统 RAG | 问题局部、延迟敏感 | 无需建图 |
| 既要全局又要实时 | 混合架构 | 按问题类型路由 | 成本翻倍、路由误差 |
十 收尾 回到那三道坎
现在回到开头那三个例子,看看两套系统分别怎么走。
医疗那个「卡托普利 + 禁忌症」。
LightRAG 的 local 模式会用低层关键词命中「卡托普利」这个实体,沿边取到「属于 ACEI」和「肾功能不全禁用」两条关系,再把对应的原文块一起交给模型。GraphRAG 的 Local Search 走的是同一条路,只是还能额外拿到所属社区的报告。两者都能把断裂的关系重新接上——前提是抽取阶段把这两条关系都抽出来了。
「刘备是个怎么样的人?」
GraphRAG 的 Global Search 会选中较高层社区,读「蜀汉人物」相关的一组报告,Map 出若干性格侧面,再 Reduce 成一段有层次的评价。LightRAG 的 global 模式则用「人物评价、性格、生平」这类高层关键词去命中关系,现场拼。前者更完整,后者更快。
「哪些欧洲供应商审计没过还在处理 PII」。
这是一次典型的多跳遍历。GraphRAG 的 Local Search 从「欧洲」相关实体出发,沿供应商—审计—合同的关系链逐步收窄;LightRAG 的 local 模式同样从实体出发,沿着关系走三跳。两者都靠图,不靠向量排序——这也正是知识图谱存在的意义。
三句话总结:
- GraphRAG 用索引期的重投入,换查询期的全局深度,适合静态、高价值、要研判的语料。
- LightRAG 用「不预写摘要」换成本、增量与延迟,适合动态、成本敏感、要快速上线的场景。
- 两者都不解决消歧,只是 GraphRAG 多垫了一层 LLM 合并。真要做生产,命名规范化和人工白名单躲不掉。
最后一句提醒:
先量化你的失败模式,再决定要不要上图。
把线上真实问题抽 100 条,按「切片断裂 / 全局归纳 / 多跳推理 / 普通事实」四类分桶,看占比。如果 80% 都是普通事实问答,上图谱纯属负优化;如果全局归纳占了三成,那 GraphRAG 的索引钱就花得值。
工具是手段,问题是起点。